Corrigé Banque PT 2026 Informatique et modélisation PT — Partie 2.4 (Q45 à Q50) : Classification des sons sous-marins par les k plus proches voisins
Sujet officiel du concours Banque PT, session 2026, épreuve Informatique et modélisation PT. Corrigé rédigé par Ibrahim Alame.
Sujet officiel (PDF, site du concours)
Énoncé
Les bruits anthropiques (navigation, prospection sismique, sonars) masquent les communications des mammifères marins. La figure 9 du sujet, un diagramme OSPAR, situe les familles de sons dans le plan fréquence ( à ) – niveau sonore ( à ) : séismes et prospection sismique au-dessus de aux basses fréquences, baleines vers –, sifflements de dauphins vers .
Des enregistrements ont été réduits à deux descripteurs, la fréquence et le niveau sonore. Ils sont stockés dans un fichier texte dont chaque ligne contient la fréquence (), le niveau (), la catégorie et l'origine ("Animale" ou "Anthropique"), par exemple 21.236, 186.37, "Baleine bleue", "Animale".
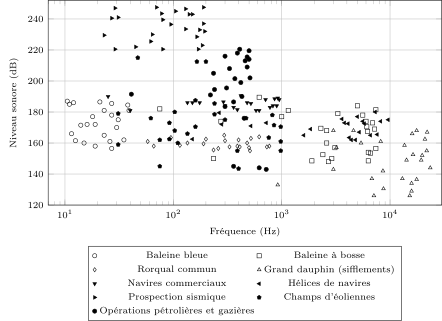
Figure 10 — Mesures classées par origine (symboles vides : animale ; pleins : anthropique), redessinées d'après le sujet, points représentatifs lus sur l'image.
Q45. Principe de l'algorithme des plus proches voisins (5 à 10 lignes).
Q46. Comment choisir ? Inconvénients des valeurs extrêmes.
Q47. Écrire distance_euclidienne(A, B), les points étant des couples (freq, dB).
Q48. Écrire plus_proches(distances, k) renvoyant les indices des plus petites valeurs de la liste distances, sans fonction de tri prédéfinie (sorted interdit).
Après apprentissage, les prédictions sur le jeu de test sont représentées ci-dessous et la matrice de confusion affichée est [[52 13] [22 48]].
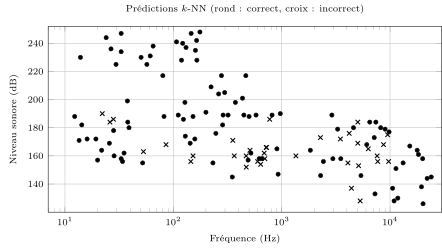
Figure 11 — Visualisation des prédictions, redessinée d'après le sujet.
Q49. Le modèle prédit-il bien l'origine du son ? Calculer la précision globale et les précisions par origine.
Q50. Comment améliorer la classification ?
Corrigé
Q45. L'algorithme des plus proches voisins est un algorithme d'apprentissage supervisé : on dispose d'une base d'apprentissage de points étiquetés, ici des couples (fréquence, niveau) dont l'origine est connue. Pour classer un nouveau point, on procède ainsi :
- on calcule sa distance (ici euclidienne) à chacun des points de la base d'apprentissage ;
- on sélectionne les points de la base les plus proches ;
- on attribue au nouveau point la classe majoritaire parmi ces voisins (vote).
Il n'y a pas de phase d'entraînement à proprement parler, la base est le modèle. En revanche, chaque prédiction coûte calculs de distance pour une base de points, plus la sélection des plus petits. La qualité du classement repose sur l'idée que des sons voisins dans l'espace des descripteurs ont la même origine.
Q46. On choisit expérimentalement. On sépare les données étiquetées en un jeu d'entraînement et un jeu de validation (ou l'on pratique la validation croisée), on mesure le taux de bonnes prédictions en validation pour plusieurs valeurs de , et l'on retient celle qui le maximise. Pour deux classes, on prend impair afin d'éviter les égalités de vote ; l'ordre de grandeur , où est la taille du jeu d'entraînement, est un point de départ usuel.
- trop petit (à la limite ) : la prédiction dépend d'un seul voisin, donc du bruit et des points aberrants. La frontière de décision est très découpée : c'est le surapprentissage, parfait sur les données d'entraînement mais fragile sur des données nouvelles.
- trop grand (à la limite ) : tous les points votent et chaque nouveau point reçoit la classe majoritaire de toute la base. La frontière disparaît : c'est le sous-apprentissage. Le coût de chaque prédiction augmente aussi.
Q47. On extrait les coordonnées des couples par affectation multiple, puis on applique la formule de Pythagore :
def distance_euclidienne(A, B):
    freq_A, dB_A = A
    freq_B, dB_B = B
    return ((freq_A - freq_B) ** 2 + (dB_A - dB_B) ** 2) ** 0.5
Pour les deux premières lignes du fichier, et , la fonction renvoie environ . L'élévation à la puissance évite d'importer sqrt, qui ne figure pas dans la liste des fonctions fournies.
100 % gratuit
La suite du corrigé est sur Adloun
Le corrigé rédigé en entier, question par question, et le tuteur pour poser des questions sur ce sujet.
Voir le corrigé complet, gratuitementInscription gratuite en 30 secondes (e-mail, nom d'utilisateur, mot de passe, classe ou profil), sans carte bancaire : arrivée directe sur le corrigé.