Corrigé bac NSI 2025 Métropole jour 2 — Exercice 1 : Codage de Shannon-Fano : arbre de codage, hauteur, parcours en largeur et fonction récursive
Sujet officiel du baccalauréat, spécialité numérique et sciences informatiques, session 2025. Corrigé rédigé par Ibrahim Alame.
Travailler ce sujet sur Adloun Sujet officiel (PDF) Corrigé complet (PDF)
Énoncé
Cet exercice porte sur les arbres binaires et la programmation Python.
Le codage de Shannon-Fano est un système de codage utilisé pour la compression sans pertes de données. Il a été mis au point par Robert Fano d'après une idée de Claude Shannon.
Partie A
Dans cette partie, on va étudier l'utilisation des arbres de codage.
Un arbre de codage est un arbre binaire où chaque feuille contient un symbole du texte que l'on souhaite coder. Le code binaire d'un symbole s'obtient alors en concaténant les 0 et les 1 sur les branches qui mènent de la racine à la feuille contenant ce symbole. Par exemple, pour l'arbre de codage donné en Figure 1, le symbole c est codé par le mot binaire 1101, tandis que d est codé par le mot binaire 11000. Les codes binaires des symboles ne sont donc pas tous de la même taille. Pour décoder un mot binaire, il suffit de descendre dans l'arbre, depuis la racine, selon les 0 et les 1 qu'on lit jusqu'à trouver une feuille (et donc un symbole), puis de recommencer avec la suite du mot binaire pour décoder les symboles suivants.
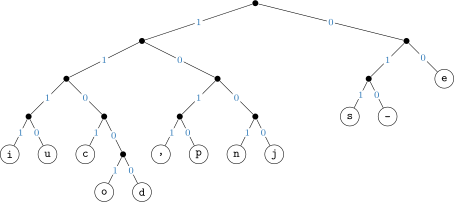
Figure 1. Exemple d'arbre de codage
1. Écrire le mot binaire qui sera utilisé pour encoder le caractère espace, représenté par le symbole _ dans l'arbre.
2. Déterminer le texte codé par le mot binaire 0001110101111110011001.
3. Citer le type de parcours de l'arbre qui permettrait d'obtenir les symboles classés par taille d'encodage croissante.
Partie B
Dans cette partie, on va utiliser le codage de Shannon-Fano pour encoder le texte :
je pense, donc je suis
Dans la méthode de Shannon-Fano, l'arbre de codage est calculé pour un texte donné par l'algorithme suivant.
- Étape 1 : classer les symboles du texte par nombre d'occurrences croissant ;
- Étape 2 : en gardant le classement obtenu, séparer les symboles en deux sous-groupes de sorte que les totaux des nombres d'occurrences soient les plus proches possibles dans les deux sous-groupes ;
- Étape 3 : placer tous les symboles du premier groupe dans le fils gauche (côté étiqueté par
1), et ceux du second groupe dans le fils droit (côté étiqueté par0) ; - Étape 4 : recommencer récursivement pour chacun des sous-groupes jusqu'à ce qu'ils n'aient plus qu'un seul symbole ; on a alors une feuille étiquetée par ce symbole.
Après avoir classé les symboles par nombre d'occurrences croissant (étape 1), on obtient le tableau suivant :
| symbole | `i` | `u` | `c` | `o` | `d` | `,` | `p` | `n` | `j` | `s` | `_` | `e` |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| nombre d'occurrences | 1 | 1 | 1 | 1 | 1 | 1 | 1 | 2 | 2 | 3 | 4 | 4 |
4. Justifier par le calcul que l'étape 2 mène à la situation illustrée par la Figure 2.
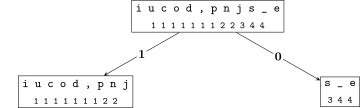
Figure 2. Le résultat de l'étape 2
En appliquant l'algorithme de Shannon-Fano, on peut obtenir l'arbre de la Figure 3.
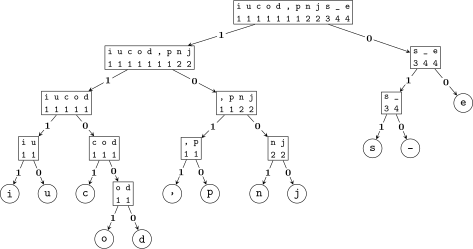
Figure 3. Arbre de codage obtenu par l'algorithme de Shannon-Fano
On rappelle qu'un arbre réduit à un seul nœud, c'est-à-dire réduit à une feuille, est de hauteur 0.
5. Donner la hauteur de l'arbre de la Figure 3 et préciser dans le contexte de l'exercice ce qu'elle représente.
On rappelle que dans le code ASCII, chaque symbole est codé sur un octet.
6. Justifier, en comparant le codage ASCII et le codage de Shannon-Fano, que ce second codage permet d'utiliser environ deux fois moins d'octets pour le texte :
je pense, donc je suis
7. Dessiner, en vous inspirant de l'arbre de la Figure 1, un arbre de codage qui permettrait d'encoder le mot « chiffrer » en utilisant l'algorithme de Shannon-Fano.
Partie C
Dans cette partie, on souhaite écrire une fonction Python qui donnera le mot binaire obtenu pour coder un texte avec l'algorithme de Shannon-Fano. On commence par la fonction creer_dico_occ :
def creer_dico_occ(texte):
    """renvoie un dictionnaire dont les clés sont les
    symboles de texte et les valeurs associées leur
    nombre d'occurences dans texte"""
    dico = {}
    for symbole in texte:
        if symbole in dico:
            dico[symbole] = ...
        else:
            dico[symbole] = ...
    return dico
8. Recopier et compléter les lignes 8 et 10 du code de la fonction creer_dico_occ.
On dispose d'une fonction creer_tab_trie qui prend en paramètre un dictionnaire construit avec la fonction creer_dico_occ et qui renvoie une liste de tuples classés dans l'ordre croissant d'occurrences des symboles.
Par exemple :
>>> texte = 'je pense, donc je suis'
>>> dico = creer_dico_occ(texte)
>>> creer_tab_trie(dico)
[('i', 1), ('u', 1), ('c', 1), ('o', 1), ('d', 1), (',', 1),
('p', 1), ('n', 2), ('j', 2), ('s', 3), (' ', 4), ('e', 4)]
9. Écrire une fonction somme_occ qui prend en paramètres un tableau tab de tuples (symbole, nb_occ) et qui renvoie la somme des nombres d'occurrences des symboles du tableau. Les tuples utilisés sont de même structure que l'élément renvoyé dans l'exemple précédent.
On suppose pour la suite qu'on dispose d'une fonction separe qui sépare un tableau trié en deux sous-tableaux de manière à ce que les sommes de ces derniers soient les plus proches possible :
def separe(tab):
    moitie = somme_occ(tab) // 2
    somme = 0
    i = 0
    while moitie > somme:
        somme = somme + tab[i][1]
        i = i + 1
    tab1 = [tab[k] for k in range(0, i)]
    tab2 = [tab[k] for k in range(i, len(tab))]
    return tab1, tab2
10. Recopier et compléter les lignes 9 et 11 du code de la fonction récursive shannon qui prend en paramètres un caractère symbole et un tableau trié tab et qui renvoie l'écriture binaire associée à symbole dans le tableau tab.
def shannon(symbole, tab):
    """renvoie l'écriture binaire associée à symbole
    dans le tableau trié tab"""
    if len(tab) == 1:
        return ""
    else:
        t1, t2 = separe(tab)
        if symbole in [elt[0] for elt in t1]:
            return "1" + ...
        else:
            return "0" + ...
11. Décrire ce qui garantit la terminaison de la fonction récursive shannon.
12. Écrire une fonction encode_shannon qui prend en paramètre un texte de type str et renvoie un mot binaire de type str obtenu après encodage par l'algorithme de Shannon-Fano.
On pourra utiliser les fonctions vues précédemment qui sont recensées ci-après.
creer_dico_occ(texte)
  renvoie un dictionnaire dont les clés sont les symboles
  du texte et les valeurs associées leur nombre
  d'occurrences

creer_tab_trie(dico)
  renvoie la liste crée à partir d'un dictionnaire
  de couples (symbole, nb_occ)

separe(tab)
  renvoie le tuple composé des 2 sous-tableaux triés
  avec des sommes d'occurences proches

shannon(symbole, tab)
  renvoie l'écriture binaire associée au symbole dans le
  tableau trié tab
Corrigé
Partie A
1. On lit les étiquettes des branches depuis la racine jusqu'à la feuille _ : branche 0 (vers la droite), puis 1, puis 0. Le caractère espace est donc codé par le mot binaire 010.
On vérifie sur les exemples du sujet : c s'obtient par 1, 1, 0, 1 soit 1101, et d par 1, 1, 0, 0, 0 soit 11000 : c'est bien la lecture attendue.
2. On descend depuis la racine en suivant les bits, et l'on repart de la racine chaque fois qu'une feuille est atteinte :
| bits lus | chemin | symbole |
|---|---|---|
| `00` | droite, droite | `e` |
| `011` | droite, gauche, gauche | `s` |
| `1010` | gauche, droite, gauche, droite | `p` |
| `1111` | gauche, gauche, gauche, gauche | `i` |
| `11001` | gauche, gauche, droite, droite, gauche | `o` |
| `1001` | gauche, droite, droite, gauche | `n` |
Le mot binaire 00 011 1010 1111 11001 1001 se décode donc en « espion ». Les 22 bits ont tous été consommés et la dernière lecture s'achève exactement sur une feuille : le décodage est complet.
Ce que le correcteur attend : le décodage n'est pas ambigu parce qu'aucun code n'est le préfixe d'un autre (les symboles ne sont que sur les feuilles) : dès qu'on atteint une feuille, on sait que le symbole est terminé et on repart de la racine.
3. La taille de l'encodage d'un symbole est la profondeur de sa feuille (le nombre de branches entre la racine et la feuille). Le parcours qui visite les nœuds niveau par niveau, par profondeur croissante, est le parcours en largeur (BFS) : il rencontre d'abord e (profondeur 2), puis s et _ (profondeur 3), puis i, u, c, la virgule, p, n, j (profondeur 4), enfin o et d (profondeur 5). Il s'implémente avec une file (FIFO) : on défile un nœud, on enfile ses enfants. Un parcours en profondeur (préfixe, infixe ou suffixe) ne convient pas : il descend jusqu'aux feuilles d'un sous-arbre avant de passer au suivant et mélangerait les profondeurs.
Partie B
4. Le total des occurrences est , ce qui correspond bien aux 22 caractères du texte (espaces et virgule compris). La moitié vaut . On cumule les occurrences dans l'ordre du tableau : après les sept symboles à une occurrence, puis avec n, puis avec j. Le premier groupe i, u, c, o, d, « , », p, n, j totalise occurrences et le second s, _, e totalise occurrences : les deux totaux sont égaux, on ne peut pas faire plus proche. C'est la séparation de la Figure 2 : le premier groupe part à gauche (branche 1), le second à droite (branche 0).
5. La hauteur de l'arbre de la Figure 3 est : la branche la plus longue mène de la racine aux feuilles o et d en cinq arêtes (racine [iucod,pnj] [iucod] [cod] [od] o). Dans le contexte de l'exercice, la hauteur est la longueur du plus long code binaire : les symboles les moins fréquents, o et d, sont codés sur bits (11001 et 11000). C'est le nombre maximal de bits qu'il faut lire pour décoder un symbole.
6. En ASCII, chaque caractère occupe un octet : le texte de caractères occupe octets, soit bits.
Avec le codage de Shannon-Fano, la longueur du code d'un symbole est la profondeur de sa feuille dans la Figure 3 ; on multiplie par le nombre d'occurrences :
| symbole | `i` | `u` | `c` | `o` | `d` | `,` | `p` | `n` | `j` | `s` | `_` | `e` |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| occurrences | 1 | 1 | 1 | 1 | 1 | 1 | 1 | 2 | 2 | 3 | 4 | 4 |
| bits par symbole | 4 | 4 | 4 | 5 | 5 | 4 | 4 | 4 | 4 | 3 | 3 | 2 |
| total | 4 | 4 | 4 | 5 | 5 | 4 | 4 | 8 | 8 | 9 | 12 | 8 |
Total : bits, soit octets ( octets ne font que bits ; il en faut un dixième pour les bits restants). On passe de octets à octets, soit un rapport : environ deux fois moins d'octets. Le gain vient de ce que les symboles fréquents (e, _, s) ont les codes les plus courts.
7. On applique l'algorithme au mot chiffrer ( lettres).
Étape 1 : occurrences c : 1, h : 1, i : 1, e : 1, f : 2, r : 2 (total ) ; on les range par nombre croissant : c, h, i, e, f, r (l'ordre entre symboles de même nombre d'occurrences est libre).
Étape 2 : la moitié de est ; les quatre premiers symboles cumulent occurrences, les deux derniers aussi : premier groupe [c h i e] (branche 1), second groupe [f r] (branche 0).
Étape 4, récursivement : [c h i e] (total , moitié ) se sépare en [c h] et [i e], puis chacun en deux feuilles ; [f r] (total , moitié ) se sépare en f et r.
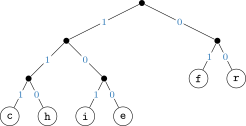
Les codes obtenus sont c : 111, h : 110, i : 101, e : 100, f : 01, r : 00 ; le mot chiffrer s'encode en bits au lieu de en ASCII. Tout arbre de même forme obtenu avec un autre ordre des symboles à une occurrence (par exemple e i h c) est également correct.
Partie C
8. Si le symbole est déjà une clé du dictionnaire, on incrémente son compteur ; sinon on crée la clé avec la valeur :
def creer_dico_occ(texte):
    """renvoie un dictionnaire dont les clés sont les
    symboles de texte et les valeurs associées leur
    nombre d'occurences dans texte"""
    dico = {}
    for symbole in texte:
        if symbole in dico:
            dico[symbole] = dico[symbole] + 1
        else:
            dico[symbole] = 1
    return dico
Sur 'je pense, donc je suis', la fonction renvoie \{'j': 2, 'e': 4, ' ': 4, 'p': 1, 'n': 2, 's': 3, ',': 1, 'd': 1, 'o': 1, 'c': 1, 'u': 1, 'i': 1\}, en accord avec le tableau de la Partie B. Le test d'appartenance symbole in dico porte sur les clés et coûte un temps constant en moyenne (table de hachage) : le comptage est linéaire en la longueur du texte.
9. On parcourt le tableau et l'on accumule la seconde composante de chaque tuple :
def somme_occ(tab):
    """renvoie la somme des nombres d'occurrences
    des tuples (symbole, nb_occ) du tableau tab"""
    somme = 0
    for couple in tab:
        somme = somme + couple[1]
    return somme
Sur le tableau trié de l'exemple, somme_occ renvoie 22 ; sur un tableau vide elle renvoie 0. Sa complexité est linéaire en la longueur du tableau.
10. Après la séparation, si le symbole est dans le premier sous-tableau t1, son code commence par 1 et se poursuit par son code dans t1 ; sinon il commence par 0 et se poursuit par son code dans t2 :
def shannon(symbole, tab):
    """renvoie l'écriture binaire associée à symbole
    dans le tableau trié tab"""
    if len(tab) == 1:
        return ""
    else:
        t1, t2 = separe(tab)
        if symbole in [elt[0] for elt in t1]:
            return "1" + shannon(symbole, t1)
        else:
            return "0" + shannon(symbole, t2)
Trace de shannon('s', tab) sur le tableau trié de l'exemple : 's' est dans t2 = [s, _, e] donc on renvoie "0" + shannon('s', t2) ; dans t2 (total , moitié ), separe donne [s, _] et [e], 's' est dans le premier : "1" + shannon('s', [s, _]) ; enfin [s, _] (total , moitié ) se sépare en [s] et [_], d'où "1" + shannon('s', [s]) et le cas de base renvoie "". Résultat : "011", le code de s dans la Figure 3.
11. La fonction est récursive et chaque appel récursif porte sur t1 ou t2, deux sous-tableaux strictement plus courts que tab : dès que tab contient au moins deux symboles, separe place au moins un symbole dans chaque partie (la boucle while fait au moins un tour car moitie somme , et s'arrête avant d'avoir tout pris puisque les sommes sont les plus proches possible). La longueur len(tab) est donc un variant : un entier positif qui décroît strictement à chaque appel. Elle finit par atteindre , qui est le cas de base (len(tab) == 1, ligne 4) : la fonction renvoie "" sans appel récursif. La récursion s'arrête donc après au plus len(tab) appels.
Ce que le correcteur attend : nommer les deux ingrédients, le cas de base et la décroissance stricte de la taille du tableau à chaque appel. On note au passage que la terminaison suppose que symbole figure bien dans tab et que les deux sous-tableaux sont non vides ; avec le code de separe donné, un symbole qui à lui seul dépasse la moitié des occurrences (texte 'aaab' par exemple) laisse t2 vide et la fonction ne termine plus (RecursionError) : c'est pour cela que le sujet prend soin de supposer que separe équilibre les deux parties.
12. On construit une seule fois le tableau trié, puis on concatène le code de chaque symbole du texte, dans l'ordre :
def encode_shannon(texte):
    """renvoie le mot binaire codant texte
    par l'algorithme de Shannon-Fano"""
    dico = creer_dico_occ(texte)
    tab = creer_tab_trie(dico)
    mot = ""
    for symbole in texte:
        mot = mot + shannon(symbole, tab)
    return mot
Testée sur 'je pense, donc je suis', la fonction renvoie un mot de bits, la longueur calculée à la question 6. Sur 'chiffrer' elle renvoie un mot de bits au lieu des du codage ASCII. Le sujet ne dit pas comment creer_tab_trie départage les symboles de même nombre d'occurrences, et ce choix change le mot obtenu : avec le tableau [('e', 1), ('i', 1), ('h', 1), ('c', 1), ('r', 2), ('f', 2)] (l'ordre qu'on obtient en départageant les ex æquo comme dans l'exemple du sujet) on lit '10010111000000111101' ; avec [('c', 1), ('h', 1), ('i', 1), ('e', 1), ('f', 2), ('r', 2)], l'ordre de l'arbre dessiné à la question 7, on lit '11111010101010010000'. L'ordre choisi entre ex æquo change les codes, jamais la longueur totale ( bits dans les deux cas). Sur un texte vide elle renvoie la chaîne vide, et sur un texte formé d'un seul symbole répété ('aaa') elle renvoie aussi la chaîne vide : le tableau trié n'a qu'un élément et son code est vide.
Ce que le correcteur attend : le tableau trié est calculé avant la boucle, pas à chaque symbole, et c'est shannon(symbole, tab) qui est appelée sur le tableau complet (la descente dans les sous-tableaux est faite par la récursion). Remarque : pour le groupe [, p n j] (occurrences ), deux séparations sont aussi équilibrées ([, p] [n j] et [, p n] [j], écart dans les deux cas) ; le code de separe choisit la seconde, si bien que encode_shannon attribue 100 à j, 1010 à n, 10110 à p et 10111 à la virgule, codes différents de la Figure 3 mais de même longueur totale ( bits) : c'est pourquoi le sujet dit qu'on « peut » obtenir l'arbre de la Figure 3.