Corrigé bac NSI 2026 Métropole jour 2 — Exercice 3 : Covoiturage : base de données SQL, parcours en largeur et point de rendez-vous
Sujet officiel du baccalauréat, spécialité numérique et sciences informatiques, session 2026. Corrigé rédigé par Ibrahim Alame.
Travailler ce sujet sur Adloun Sujet officiel (PDF) Corrigé complet (PDF)
Énoncé
Cet exercice porte sur les bases de données ainsi que les structures de file et de graphe.
Partie A
Dans cette partie, on pourra utiliser les clauses du langage SQL pour :
- construire des requêtes d'interrogation à l'aide de
SELECT,FROM,WHERE(avec les opérateurs logiquesANDetOR),JOIN ... ON; - construire des requêtes d'insertion et de mise à jour à l'aide de
UPDATE,INSERTetDELETE; - affiner les recherches à l'aide de
DISTINCTetORDER BY.
Dans une entreprise qui possède plusieurs sites de production, on met en place une application de covoiturage pour aider les salariés à limiter leurs déplacements en voiture individuelle, et ainsi, diminuer l'empreinte carbone de l'entreprise. Avec cette application, chaque membre du personnel peut proposer un trajet ou s'inscrire sur un trajet proposé.
L'application repose sur une base de données avec trois tables, que l'on décrit par le schéma suivant où les attributs qui servent de clé primaire sont soulignés et les attributs qui servent de clé étrangère sont précédés du caractère #.
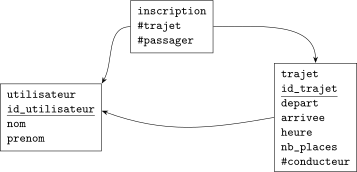
Figure 1. Schéma de la base de données
1. Expliquer pourquoi les attributs nom et prenom n'ont pas été retenus comme clé primaire de la table utilisateur.
Les attributs id_utilisateur et id_trajet sont des nombres entiers.
2. Justifier que les attributs de la relation inscription sont aussi des nombres entiers.
La requête :
SELECT *
FROM trajet
WHERE heure > '2026-06-19 00:00:00'
      AND heure < '2026-06-20 00:00:00';
renvoie le tableau suivant :
Table trajet :<br>
| `id_trajet` | `depart` | `arrivee` | `heure` | `nb_places` | `conducteur` |
|---|---|---|---|---|---|
| 1291 | Liverdun | Toul | `2026-06-19 07:30:00` | 3 | 25 |
| 1292 | Allain | Nancy | `2026-06-19 07:45:00` | 2 | 30 |
| 1293 | Messein | Nancy | `2026-06-19 08:00:00` | 2 | 10 |
| 1294 | Nancy | Messein | `2026-06-19 18:20:00` | 2 | 10 |
| 1295 | Nancy | Allain | `2026-06-19 17:45:00` | 3 | 25 |
| 1296 | Toul | Liverdun | `2026-06-19 18:00:00` | 2 | 30 |
Avec des requêtes adaptées, on peut obtenir les informations suivantes concernant les inscriptions et les utilisateurs concernés par ces trajets :
Table inscription :<br>
| `trajet` | `passager` |
|---|---|
| 1291 | 4 |
| 1291 | 15 |
| 1291 | 38 |
| 1292 | 18 |
| 1295 | 4 |
| 1295 | 15 |
| 1295 | 38 |
| 1296 | 18 |
Table utilisateur :<br>
| `id_utilisateur` | `nom` | `prenom` |
|---|---|---|
| 4 | Mizab | Yasmine |
| 10 | Di Maria | Alexis |
| 15 | Rey | Maxime |
| 18 | Nguema | Basil |
| 25 | Daniel | Valérie |
| 30 | Sanches | Nathalie |
| 38 | Fabre | Clément |
3. Recopier et compléter la requête suivante afin de connaître le nombre de passagers inscrits sur le trajet n<sup>o</sup> 1291.
SELECT COUNT(*)
FROM ...
WHERE ...;
4. Écrire une requête permettant d'obtenir la liste des trajets qui arrivent à Nancy le 19 juin 2026 dans l'ordre croissant de l'heure de départ.
On suppose que le trajet n<sup>o</sup> 1295 a été ajouté dans la base de données lors de sa création par une simple requête et qu'il n'a pas été modifié depuis.
5. Écrire une requête qui aurait permis d'ajouter le trajet n<sup>o</sup> 1295 dans la base de données lors de sa création.
6. Écrire une requête permettant de modifier l'heure de départ à 18h40 pour le trajet n<sup>o</sup> 1294. On pourra utiliser les valeurs présentes dans les tableaux extraits de la base de données.
Pour supprimer le trajet de 18h00 entre Toul et Liverdun, on essaye la requête suivante :
DELETE FROM trajet
WHERE id_trajet=1296;
Le gestionnaire de base de données donne alors l'erreur suivante :
ERROR 1451 (23000) at line 95 in file: 'covoit.sql': Cannot
delete or update a parent row: a foreign key constraint fails
7. Expliquer en détail les raisons de cette erreur.
8. Écrire une requête permettant d'obtenir la liste des noms et prénoms des passagers transportés au moins une fois par l'utilisatrice dont l'identifiant est 25.
Partie B
Alice, Maxime, Valérie et Clément doivent choisir un point de rendez-vous pour leur trajet de covoiturage. Ils ont identifié trois points de rendez-vous possibles. Dans le graphe suivant :
- les sommets A, M, C, et V représentent les domiciles des quatre covoitureurs ;
- les sommets P1, P2, et P3 représentent les points de rendez-vous possibles ;
- les arêtes représentent des trajets entre ces lieux qui possèdent tous approximativement les mêmes conditions de parcours (distance et durée).
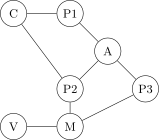
Figure 2. Graphe des domiciles et points de rendez-vous
9. Écrire un dictionnaire Python représentant le graphe de la Figure 2. Ce dictionnaire doit associer à chaque sommet la liste de ses sommets voisins.
On utilise la fonction dico_distance donnée ci-après pour déterminer toutes les distances en nombre d'arêtes entre un point de rendez-vous et les autres sommets du graphe.
def dico_distance(graphe, depart):
    """ graphe : dictionnaire
        {sommet : liste de sommets adjacents }
        depart : un sommet du graphe
        renvoie un dictionnaire
        {sommet atteignable depuis depart :
        distance entre depart et ce sommet }"""

    # initialisation d'une file
    file = File()
    file.inserer(depart)

    # initialisation du dictionnaire de sortie
    dico = {depart : 0}

    while not file.est_vide():
        # extraire le prochain sommet à explorer
        sommet = file.extraire()
        # pour chaque voisin encore non atteint
        for voisin in graphe[sommet]:
            if voisin not in dico:
                # attribuer la distance à ce voisin
                dico[voisin] = dico[sommet] + 1
                # placer ce voisin dans la file
                # pour une exploration future
                file.inserer(voisin)
    return dico
La fonction dico_distance utilise une file pour gérer l'ordre d'exploration des sommets du graphe. Cette file est implémentée avec une classe File. En tapant la commande help(File) dans la console de Python on obtient :
class File(builtins.object)
 |  Methods defined here:
 |
 |  __init__(self)
 |      initialise une file vide
 |
 |  consulter(self)
 |      renvoie le premier élément disponible
 |          sans le retirer de la file
 |      lève une exception IndexError si la file est vide
 |
 |  est_vide(self)
 |      renvoie True si la file est vide, False sinon
 |
 |  extraire(self)
 |      renvoie le premier élément disponible et
 |          le retire de la file
 |      lève une exception IndexError si la file est vide
 |
 |  inserer(self, element)
 |      ajoute l'élément donné dans la file
10. Rappeler le principe de fonctionnement d'une file.
11. Donner un ordre possible d'insertion des sommets dans la file lorsqu'on applique la fonction dico_distance sur le graphe de la Figure 2 avec le sommet P1 pour sommet de départ.
12. Donner le nom du type de parcours de graphe, utilisé dans la fonction dico_distance.
On définit l'excentricité d'un sommet dans un graphe comme la plus grande distance parmi les distances entre ce sommet et un autre sommet quelconque du graphe.
13. Recopier et compléter la fonction excentricite suivante qui calcule l'excentricité d'un sommet dans un graphe. L'utilisation de la fonction max, disponible sans importation, n'est pas autorisée.
def excentricite(graphe, sommet):
    """ graphe : dictionnaire
        {sommet : liste de sommets adjacents }
        renvoie l'excentricité de sommet
        dans le graphe (int) """
    dico = dico_distance(graphe, sommet)
    ...
    ...
    ...
    ...
    ...
14. Donner, en le justifiant avec un indicateur, le meilleur point de rendez-vous pour ces quatre personnes (Alice, Maxime, Valérie et Clément).
Corrigé
Partie A : la base de données du covoiturage
Le schéma relationnel, avec clés primaires soulignées et clés étrangères en # :
utilisateur(<u>id_utilisateur</u>,nom,prenom) ;trajet(<u>id_trajet</u>,depart,arrivee,heure,nb_places,#conducteur) oùconducteurréférenceutilisateur.id_utilisateur;inscription(#trajet,#passager) oùtrajetréférencetrajet.id_trajetetpassagerréférenceutilisateur.id_utilisateur; c'est la table d'association qui relie un trajet à ses passagers, le couple (trajet,passager) identifiant une inscription.
1. Une clé primaire doit identifier de façon unique chaque n-uplet (contrainte d'intégrité d'entité) : deux lignes ne peuvent jamais porter la même valeur de clé. Or rien n'empêche deux membres du personnel d'une entreprise à plusieurs sites d'être homonymes, avec le même nom et le même prénom : le couple (nom, prenom) ne garantit pas l'unicité, il ne peut donc pas servir de clé primaire. S'y ajoutent deux raisons pratiques : un nom peut changer (mariage, correction d'une faute de saisie), alors qu'une clé primaire doit rester stable, et la comparaison de deux chaînes de caractères est plus coûteuse que celle de deux entiers. On préfère donc un identifiant artificiel entier, id_utilisateur, unique et jamais modifié.
2. Les deux attributs de inscription sont des clés étrangères (le # du schéma) : trajet référence la clé primaire id_trajet de la table trajet, et passager référence la clé primaire id_utilisateur de la table utilisateur. La contrainte d'intégrité référentielle impose qu'une clé étrangère prenne ses valeurs parmi les valeurs existantes de la clé primaire qu'elle référence : elle a donc le même domaine qu'elle. Comme id_trajet et id_utilisateur sont des entiers, trajet et passager sont aussi des entiers. On le vérifie sur l'extrait : la ligne (1291, 4) désigne le trajet Liverdun-Toul et Yasmine Mizab.
3. Les passagers inscrits sur un trajet sont les lignes de inscription dont l'attribut trajet vaut 1291 :
SELECT COUNT(*)
FROM inscription
WHERE trajet = 1291;
Sur l'extrait, cette requête renvoie 3 (les passagers 4, 15 et 38).
4. On filtre sur la ville d'arrivée et sur la journée du 19 juin 2026 (toutes les heures de '2026-06-19 00:00:00' inclus à '2026-06-20 00:00:00' exclu), puis on trie par heure croissante avec ORDER BY :
SELECT *
FROM trajet
WHERE arrivee = 'Nancy'
  AND heure >= '2026-06-19 00:00:00'
  AND heure < '2026-06-20 00:00:00'
ORDER BY heure;(ORDER BY heure ASC est équivalent, l'ordre croissant étant celui par défaut.) Résultat sur l'extrait, exécuté sur une base de test : le trajet 1292 (Allain, 07:45:00) puis le trajet 1293 (Messein, 08:00:00).
Ce que le correcteur attend : la borne du jour écrite sous la même forme que dans le sujet ('AAAA-MM-JJ HH:MM:SS'), et le tri explicitement demandé par ORDER BY.
5. On reprend la ligne 1295 du tableau, en respectant l'ordre des attributs et les apostrophes pour les chaînes et la date :
INSERT INTO trajet (id_trajet, depart, arrivee, heure, nb_places, conducteur)
VALUES (1295, 'Nancy', 'Allain', '2026-06-19 17:45:00', 3, 25);
Le conducteur 25 (Valérie Daniel) doit exister dans utilisateur au moment de l'insertion, sans quoi la contrainte référentielle rejetterait la ligne.
6. On modifie le seul attribut heure de la ligne identifiée par sa clé primaire :
UPDATE trajet
SET heure = '2026-06-19 18:40:00'
WHERE id_trajet = 1294;
La clause WHERE est indispensable : sans elle, tous les trajets de la table seraient mis à 18h40.
7. Le trajet 1296 est référencé par la table inscription : la ligne (1296, 18) indique que l'utilisateur 18 (Basil Nguema) y est inscrit, et l'attribut trajet de cette ligne est une clé étrangère vers trajet.id_trajet. Supprimer la ligne 1296 de trajet laisserait dans inscription une référence « pendante » vers un trajet qui n'existe plus : ce serait une violation de la contrainte d'intégrité référentielle. Le SGBD la fait respecter et refuse donc la suppression, ce que dit le message : trajet est la table « parent » (celle dont la clé primaire est référencée), inscription la table « enfant », et « a foreign key constraint fails » signale la contrainte de clé étrangère violée. Pour supprimer ce trajet, il faut d'abord supprimer les inscriptions qui le référencent, puis le trajet lui-même :
DELETE FROM inscription WHERE trajet = 1296;
DELETE FROM trajet WHERE id_trajet = 1296;
(Une autre solution consiste à déclarer la clé étrangère avec ON DELETE CASCADE lors de la création de la table, ce qui supprime automatiquement les inscriptions liées.) L'erreur a été reproduite sur une base de test : la suppression directe est rejetée, la suppression en deux temps est acceptée.
8. L'utilisatrice 25 est la conductrice des trajets 1291 et 1295. On relie les trois tables : utilisateur donne le nom du passager, inscription le lie à un trajet, trajet donne le conducteur. DISTINCT évite de répéter une personne transportée plusieurs fois :
SELECT DISTINCT utilisateur.nom, utilisateur.prenom
FROM utilisateur
JOIN inscription ON inscription.passager = utilisateur.id_utilisateur
JOIN trajet ON trajet.id_trajet = inscription.trajet
WHERE trajet.conducteur = 25;
Résultat sur l'extrait (exécuté) : Mizab Yasmine, Rey Maxime, Fabre Clément. Sans DISTINCT, chacun apparaîtrait deux fois, puisqu'ils sont inscrits à la fois sur le trajet 1291 et sur le trajet 1295.
Ce que le correcteur attend : deux jointures (une seule ne relie pas le passager au conducteur), la condition sur trajet.conducteur et non sur inscription.passager, et le DISTINCT pour « au moins une fois ».
Partie B : le choix du point de rendez-vous
9. Le graphe non orienté de la figure 2 a huit arêtes : C-P1, C-P2, P1-A, A-P2, A-P3, P2-M, P3-M et V-M. Chaque arête apparaît dans les listes de ses deux extrémités :
graphe = {'A':  ['P1', 'P2', 'P3'],
          'M':  ['P2', 'P3', 'V'],
          'C':  ['P1', 'P2'],
          'V':  ['M'],
          'P1': ['C', 'A'],
          'P2': ['C', 'A', 'M'],
          'P3': ['A', 'M']}
(L'ordre des voisins dans chaque liste est libre. Vérification exécutée : la symétrie est respectée et la somme des degrés vaut .)
10. Une file est une structure linéaire de type FIFO (First In, First Out, « premier entré, premier sorti ») : les éléments sont ajoutés à une extrémité, la queue (méthode inserer, « enfiler »), et retirés à l'autre extrémité, la tête (méthode extraire, « défiler ») ; l'élément retiré est toujours le plus ancien encore présent. On peut consulter l'élément de tête sans le retirer (consulter) et tester si la file est vide (est_vide). C'est le fonctionnement d'une file d'attente, à l'opposé de la pile (LIFO), où l'on retire le dernier élément entré.
11. On déroule dico_distance(graphe, 'P1') avec le dictionnaire de la question 9. Le sommet de départ est inséré, puis, à chaque extraction, les voisins non encore présents dans dico sont insérés dans l'ordre de leur liste :
| Sommet extrait | Voisins | Insérés (distance) | File après l'étape |
|---|---|---|---|
| --- | --- | P1 (0) | [P1] |
| P1 | C, A | C (1), A (1) | [C, A] |
| C | P1, P2 | P2 (2) | [A, P2] |
| A | P1, P2, P3 | P3 (2) | [P2, P3] |
| P2 | C, A, M | M (3) | [P3, M] |
| P3 | A, M | aucun | [M] |
| M | P2, P3, V | V (4) | [V] |
| V | M | aucun | [] |
Un ordre possible d'insertion est donc P1, C, A, P2, P3, M, V (exécuté), et la fonction renvoie \{'P1': 0, 'C': 1, 'A': 1, 'P2': 2, 'P3': 2, 'M': 3, 'V': 4\}. Si la liste des voisins de P1 était ['A', 'C'], on obtiendrait P1, A, C, P2, P3, M, V : l'ordre dépend de l'ordre des listes d'adjacence, mais les distances sont toujours les mêmes.
12. C'est un parcours en largeur (Breadth-First Search, BFS) : la file fait explorer les sommets « par couches », d'abord tous les sommets à distance 1 du départ, puis ceux à distance 2, etc. C'est ce qui garantit que dico[voisin] = dico[sommet] + 1 est bien la plus courte distance en nombre d'arêtes. Un parcours en profondeur utiliserait une pile.
13. On parcourt les valeurs du dictionnaire des distances en conservant la plus grande rencontrée, sans la fonction max :
def excentricite(graphe, sommet):
    """ graphe : dictionnaire
        {sommet : liste de sommets adjacents }
        renvoie l'excentricité de sommet
        dans le graphe (int) """
    dico = dico_distance(graphe, sommet)
    maxi = 0
    for s in dico:
        if dico[s] > maxi:
            maxi = dico[s]
    return maxi
Initialiser maxi à 0 est correct puisque toutes les distances sont positives ou nulles (celle du sommet de départ vaut 0). Exécuté : excentricite(graphe, 'P1') renvoie 4 (le sommet V), excentricite(graphe, 'P2') renvoie 2 et excentricite(graphe, 'P3') renvoie 3.
14. L'indicateur naturel est l'excentricité du point de rendez-vous, c'est-à-dire la distance (en nombre d'arêtes) que doit parcourir le covoitureur le plus éloigné. Les distances calculées par dico_distance depuis chaque point sont :
| Point | vers A | vers M | vers V | vers C | Excentricité | Somme des distances |
|---|---|---|---|---|---|---|
| P1 | 1 | 3 | 4 | 1 | 4 | 9 |
| P2 | 1 | 1 | 2 | 1 | 2 | 5 |
| P3 | 1 | 1 | 2 | 3 | 3 | 7 |
(Ici l'excentricité prise sur tout le graphe coïncide avec la plus grande distance aux quatre domiciles.) Le point P2 a l'excentricité minimale, 2 : personne n'a plus de deux trajets élémentaires à faire, et Alice, Maxime et Clément n'en ont qu'un. Un second indicateur, la somme des distances aux quatre domiciles (5 pour P2 contre 7 pour P3 et 9 pour P1), confirme ce choix. Le meilleur point de rendez-vous est donc P2.
Ce que le correcteur attend : un indicateur nommé (excentricité ou somme des distances) et calculé pour les trois points, pas seulement une lecture de la figure.