Tableaux associatifs, hachage et sérialisation
Cours complet · informatique (MP2I/MPI), chapitre 12 · MP2I et MPI
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
12.1 Indexer par autre chose qu'un entier
Un tableau associe une valeur à un entier compris entre et , et l'accès est immédiat. Mais on veut souvent associer une valeur à un mot, à un nom, à une paire de coordonnées. C'est le tableau associatif : un ensemble de couples (clé, valeur), où la clé n'est plus un indice.
Trois réalisations ont déjà été rencontrées ou vont l'être, et elles se distinguent par un seul chiffre :
| Réalisation | Recherche | Ce qu'elle exige de la clé | Chapitre |
|---|---|---|---|
| Liste de couples | l'égalité | chap:sequentielles | |
| Arbre de recherche | un ordre total | chap:tas | |
| Table de hachage | en moyenne | l'égalité, et une fonction de hachage | ici |
La table de hachage est la plus rapide et la plus exigeante en garanties : son est en moyenne, jamais dans le pire cas.
12.2 Le principe
Une fonction de hachage envoie une clé sur un entier de , où est la taille du tableau sous-jacent. La valeur associée à la clé est rangée à l'indice .
L'accès devient alors le calcul de , puis un accès direct : , si tout va bien.
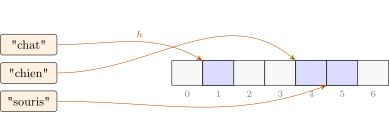
La phrase est explicite : « la construction d'une fonction de hachage et les méthodes de gestion des collisions éventuelles ne sont pas des exigibles du programme ».
On doit donc savoir utiliser une table de hachage, connaître son coût et ses limites. On n'a pas à savoir concevoir une bonne fonction de hachage, ni à connaître le détail des stratégies de résolution. Ce chapitre les présente néanmoins brièvement, parce qu'on ne peut pas juger un « en moyenne » sans savoir de quoi il dépend.
12.3 Les collisions
Deux clés distinctes telles que sont en collision.
Il y a beaucoup plus de clés possibles que de cases : la fonction ne peut pas être injective. Mais l'inévitabilité est plus forte encore que l'argument par les cardinaux ne le suggère.
Avec cases et clés tirées uniformément, la probabilité qu'aucune collision ne survienne vaut
Pour , cette probabilité passe sous dès : c'est le paradoxe des anniversaires. Vingt-trois clés dans trois cent soixante-cinq cases suffisent à rendre la collision plus probable que son absence. Une table de hachage doit donc les gérer par conception, jamais les traiter comme un cas rare.
- Chaînage : chaque case contient une liste de couples. On y ajoute, on y cherche linéairement.
- Adressage ouvert : tout est dans le tableau ; en cas de collision, on cherche une autre case selon une règle fixée (la suivante, par exemple).
Le module Hashtbl d'OCaml procède par chaînage.
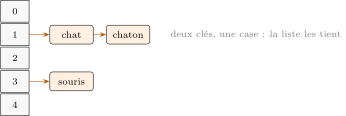
Le facteur de charge est le nombre moyen de clés par case. Avec le chaînage et une fonction de hachage qui répartit uniformément, la recherche coûte en moyenne : constant tant que reste borné. On redimensionne donc la table dès que dépasse un seuil, et le coût de la recopie est amorti sur les insertions, exactement comme au chapitre chap:algo-prog.
Si toutes les clés tombent dans la même case, la table dégénère en liste chaînée. Sur des données quelconques c'est improbable ; sur des données choisies par un adversaire qui connaît , c'est facile — et cela constitue une attaque par déni de service bien réelle contre les serveurs. La parade est la randomisation : tirer un paramètre de au démarrage, pour que personne ne puisse prévoir les collisions.
Notons que le programme écarte explicitement ce point : le module Hashtbl y est utilisé « sans liaison multiple ni randomisation ». On le mentionne pour que le ne soit pas pris pour une garantie : il n'en est pas une.
12.4 S'en servir
L'annexe B en liste limitativement les fonctions : create, add, remove, mem, find — qui lève Not_found —, find_opt, iter.
(* Renvoie la table des occurrences de chaque mot de la liste l. *)
let compter l =
  let h = Hashtbl.create 97 in
  List.iter (fun mot ->
    let n = match Hashtbl.find_opt h mot with Some k -> k | None -> 0 in
    Hashtbl.replace h mot (n + 1)) l;
hC'est le piège du module. Hashtbl.add h c v ajoute une liaison sans retirer les précédentes : find rendra la dernière ajoutée, et remove en retirera une seule, faisant réapparaître l'ancienne valeur. C'est ce que l'annexe appelle la « liaison multiple », qu'elle exclut du programme. Pour la sémantique attendue — une valeur par clé — on écrit Hashtbl.replace, comme ci-dessus.
Méthode : Quand préférer le hachage, quand préférer l'arbre
| Table de hachage | Arbre de recherche |
|---|---|
| accès le plus rapide en moyenne | garanties dans le pire cas |
| les clés n'ont pas besoin d'ordre | les clés doivent être ordonnées |
| aucun parcours trié possible | parcours infixe trié, gratuit |
| pas de « plus proche clé » | recherche du prédécesseur, d'un intervalle |
La ligne décisive est souvent la troisième : si l'on doit un jour lister les clés dans l'ordre, la table de hachage oblige à tout extraire et à trier, en , alors que l'arbre le donne pour rien.
12.5 Sérialisation
Sérialiser une structure, c'est l'écrire comme une suite d'octets — pour la ranger dans un fichier ou la transmettre. Désérialiser est l'opération inverse. Le programme demande de « présenter un exemple de sérialisation d'une structure hiérarchique et d'une structure relationnelle ».
Un arbre en mémoire est fait de pointeurs. Un fichier est une suite plate. Sérialiser consiste donc à coder la forme dans l'ordre des octets, de manière que la lecture puisse la reconstruire sans ambiguïté.
12.5.1 Une structure hiérarchique : l'arbre
Le parcours préfixe seul ne suffit pas : deux arbres différents peuvent le partager. Il faut écrire aussi les sous-arbres vides.
(* Sérialise a en préfixe : chaque nœud donne son étiquette, chaque vide un '#'. *)
let rec serialise = function
  | Vide -> "#"
  | Noeud (g, e, d) -> string_of_int e ^ " " ^ serialise g ^ " " ^ serialise d
L'arbre du chapitre chap:arbres devient :
8 3 1 # # 6 4 # # # 9 7 # # #La désérialisation lit les jetons de gauche à droite : un # rend Vide, un nombre lit son étiquette puis récursivement son fils gauche et son fils droit. C'est exactement le parcours préfixe relu à l'envers — et c'est ce marquage des vides qui rend l'écriture injective.
La suite sans marqueurs peut être « est le fils gauche de » ou « est le fils droit de » : deux arbres, une seule écriture. Le # n'est pas un détail de format, c'est ce qui fait de la sérialisation une bijection.
12.5.2 Une structure relationnelle : le graphe
Un graphe n'est pas hiérarchique : il a des cycles, et un sommet peut être atteint par plusieurs chemins. On ne peut donc pas le parcourir en écrivant au fil de l'eau — on écrirait le même sommet plusieurs fois, ou l'on tournerait en rond.
On sérialise donc en deux temps : d'abord les sommets, numérotés ; puis les arcs, comme couples de numéros.
3                 <- nombre de sommets
Paris Lyon Nice   <- les étiquettes, dans l'ordre des numéros 0, 1, 2
4                 <- nombre d'arcs
0 1               <- Paris -> Lyon
1 0
1 2
2 0
Le numéro joue ici le rôle qu'avait le pointeur en mémoire : c'est une référence, mais une référence portable, qui a un sens hors du processus. C'est le principe de tout format d'échange, et l'on retrouvera exactement cette idée avec la clé étrangère du chapitre chap:sql : dans une base de données aussi, un lien s'écrit comme une valeur, jamais comme une adresse.
12.6 Ce qu'il faut retenir
- Une table de hachage donne l'accès en en moyenne, jamais dans le pire cas — et le pire cas peut être provoqué.
- Les collisions sont inévitables : dès clés pour cases, elles sont plus probables que leur absence. Une table les gère par conception.
- Le hachage n'ordonne rien : dès qu'un parcours trié ou une recherche d'intervalle est en jeu, l'arbre de recherche reprend l'avantage.
- Sérialiser, c'est coder la forme dans l'ordre des octets : les vides marqués pour un arbre, des numéros de sommets pour un graphe. En mémoire, un lien est une adresse ; dans un fichier, c'est une valeur.