Algorithmique des textes
Cours · informatique (MP2I/MPI), chapitre 18 · MP2I et MPI · le début du chapitre, la suite sur Adloun
18.1 Deux questions sur les mots
Un texte est une suite de caractères, et deux questions reviennent sans cesse : où se trouve ce motif ? et comment ranger ce texte en moins de place ? Le programme les traite dans la même section, et elles ont un point commun : la solution naïve est déjà correcte, et l'on ne cherche qu'à aller plus vite.
Sur un alphabet , un mot est une suite finie de lettres. Pour :
- un préfixe est un , un suffixe un ;
- un facteur est un — des lettres consécutives ;
- un sous-mot s'obtient en supprimant des lettres, sans changer l'ordre des autres.
Le mot vide se note . Facteur et sous-mot ne se confondent pas : abc est un sous-mot de axbyc, il n'en est pas un facteur. Ce vocabulaire est repris tel quel au chapitre chap:automates.
18.2 Chercher un motif
Étant donné un texte de longueur et un motif de longueur , trouver les positions où apparaît comme facteur de .
18.2.1 La méthode naïve, et son coût
/* Affiche les positions où p apparaît dans t.
   Préconditions : n >= m >= 1. Complexité : O(n·m) dans le pire cas. */
void recherche_naive(const char t[], int n, const char p[], int m) {
    for (int i = 0; i + m <= n; i = i + 1) {
        int j = 0;
        while (j < m && t[i + j] == p[j]) { j = j + 1; }
        if (j == m) { printf("%d ", i); }
    }
}Sur ( lettres) et ( lettres), chaque position échoue à la dernière lettre : décalages, comparaisons chacun, soit . Sur du texte naturel, en revanche, le premier caractère suffit presque toujours à conclure, et la méthode est en pratique — ce qui explique qu'elle survive dans bien des programmes.
18.2.2 Boyer-Moore : comparer par la fin
Le programme autorise une simplification : « on peut se restreindre à une version simplifiée de l'algorithme de Boyer-Moore, avec une seule fonction de décalage. L'étude précise de la complexité de ces algorithmes n'est pas exigible. » C'est cette version qu'on présente, avec la règle du mauvais caractère.
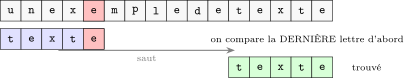
On aligne le motif, et l'on compare de droite à gauche. Si la lettre du texte qui provoque l'échec ne figure pas du tout dans le motif, alors aucun alignement chevauchant cette position ne peut réussir : on peut sauter le motif tout entier, soit positions d'un coup.
Méthode : La règle du mauvais caractère
On précalcule, pour chaque lettre de l'alphabet, sa dernière position dans le motif — ou si elle n'y figure pas. En cas d'échec en position du motif sur la lettre du texte, on décale de , en s'assurant d'avancer d'au moins un cran.
#define ALPHABET 256

/* Affiche les positions où p apparaît dans t (Boyer-Moore, mauvais caractère).
   Préconditions : n >= m >= 1. */
void boyer_moore(const char t[], int n, const char p[], int m) {
    int derniere[ALPHABET];
    for (int c = 0; c < ALPHABET; c = c + 1) { derniere[c] = -1; }
    for (int j = 0; j < m; j = j + 1) { derniere[(unsigned char) p[j]] = j; }

    int i = 0;
    while (i + m <= n) {
        int j = m - 1;
        while (j >= 0 && p[j] == t[i + j]) { j = j - 1; }   /* de DROITE à gauche */
        if (j < 0) {
            printf("%d ", i);
            i = i + 1;
        } else {
            int saut = j - derniere[(unsigned char) t[i + j]];
            i = i + (saut > 1 ? saut : 1);      /* JAMAIS moins d'un cran */
        }
    }
}saut > 1 ? saut : 1 n'est pas une précaution : c'est la terminaisonSi la lettre fautive apparaît dans le motif après la position , alors est négatif : le décalage ferait reculer l'algorithme, qui boucherait indéfiniment. Le variant de la boucle est , et il ne décroît que si l'on avance d'au moins un cran. C'est la démonstration de terminaison du chapitre chap:algo-prog, appliquée ici.
Sur un texte en alphabet large — de la langue naturelle — les sauts sont proches de : l'algorithme lit moins de caractères qu'il n'y en a, ce que la méthode naïve ne peut pas faire. Sur un alphabet à deux lettres, en revanche, les sauts sont petits et l'avantage s'évanouit. Le pire cas reste avec cette seule règle.