Unir & trouver, arbres couvrants
Cours complet · informatique (MP2I/MPI), chapitre 23 · MP2I et MPI
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
23.1 Une structure faite pour une seule question
La question est : ces deux éléments sont-ils dans le même paquet ? Et l'opération est : fusionne ces deux paquets. Rien d'autre. On ne sait pas séparer, on ne sait pas énumérer un paquet, on ne sait même pas le nommer autrement que par un représentant arbitraire.
Cette pauvreté est la source de l'efficacité, et le programme la traite comme un cas d'école de la démarche du chapitre chap:abstraction : « on commence par donner des implémentations naïves de la structure unir & trouver qui privilégient soit l'opération unir, soit l'opération trouver, avant de donner une implémentation par des arbres qui permet une mise en œuvre efficace des deux opérations ».
La structure représente une partition d'un ensemble en classes d'équivalence.
| Opération | Rôle | Effet |
|---|---|---|
| `creer(n)` | constructeur | classes, chacune à un élément |
| `trouver(x)` | accesseur | le représentant de la classe de |
| `unir(x, y)` | transformateur | fusionne les classes de et |
Deux éléments sont dans la même classe si et seulement si trouver leur rend le même représentant.
23.2 Deux mises en œuvre naïves
Un tableau où est directement le numéro de classe de .
int trouver(const int c[], int x) { return c[x]; }         /* O(1) */

void unir(int c[], int n, int x, int y) {                  /* O(n) */
    int a = c[x], b = c[y];
    if (a == b) { return; }
    for (int k = 0; k < n; k = k + 1) { if (c[k] == b) { c[k] = a; } }
}
trouver est immédiat, unir doit balayer tout le tableau.
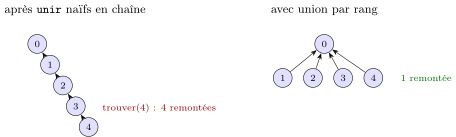
Chaque élément pointe vers un parent, et l'union se contente d'accrocher une racine sous l'autre.
int trouver(const int p[], int x) {                        /* O(hauteur) */
    while (p[x] != x) { x = p[x]; }
    return x;
}

void unir(int p[], int x, int y) {                         /* O(hauteur) */
    p[trouver(p, x)] = trouver(p, y);
}
unir est bon marché — mais rien n'empêche l'arbre de dégénérer en peigne, et trouver devient alors . C'est exactement le défaut de l'arbre binaire de recherche non équilibré du chapitre chap:tas.
23.3 La mise en œuvre efficace
Deux optimisations, chacune tenant en une ligne, et dont la conjonction rend la structure quasi instantanée.
Méthode : Union par rang
On garde une estimation de la hauteur de chaque arbre — son rang — et l'on accroche toujours le plus petit sous le plus grand. La hauteur ne croît alors que si les deux rangs sont égaux.
void unir(int p[], int rang[], int x, int y) {
    int a = trouver(p, x), b = trouver(p, y);
    if (a == b) { return; }
    if (rang[a] < rang[b]) { int t = a; a = b; b = t; }   /* a est le plus haut */
    p[b] = a;
    if (rang[a] == rang[b]) { rang[a] = rang[a] + 1; }
}Un arbre de rang contient au moins éléments. Donc , et trouver est en .
Démonstration
Par récurrence sur les unions. Un arbre de rang a un élément, soit . Le rang ne croît que lorsqu'on unit deux arbres de même rang : le résultat a le rang et contient au moins éléments. La propriété est conservée.
Méthode : Compression de chemin
Puisque trouver remonte déjà jusqu'à la racine, autant en profiter : on raccroche directement à la racine tous les nœuds traversés.
int trouver(int p[], int x) {
    if (p[x] != x) { p[x] = trouver(p, p[x]); }   /* on RÉÉCRIT en remontant */
    return p[x];
}
Le premier trouver coûte la hauteur ; tous les suivants, sur les mêmes éléments, coûtent . La structure s'aplatit à l'usage.
Avec les deux optimisations, une suite de opérations sur éléments coûte , où est l'inverse de la fonction d'Ackermann — celle du chapitre chap:induction. Sa croissance est si lente que pour tout inférieur au nombre d'atomes de l'univers observable : le coût amorti est constant en pratique.
Le programme est net sur le niveau attendu : « l'analyse de la complexité de cette structure est admise ». On retient donc le résultat et les deux optimisations qui le produisent, pas sa démonstration.
23.4 L'arbre couvrant de poids minimum
Dans un graphe non orienté connexe et pondéré, un arbre couvrant est un sous-ensemble d'arêtes qui relie tous les sommets sans former de cycle — donc arêtes (chapitre chap:graphes). On cherche celui de poids total minimal.
C'est le problème du réseau à moindre coût : relier villes par le moins de câble possible.
Méthode : L'algorithme de Kruskal
Trier les arêtes par poids croissant, puis les prendre une à une en écartant celles qui formeraient un cycle. La détection du cycle est exactement une question d'appartenance à une même classe : unir & trouver est l'outil, et c'est pourquoi les deux sujets sont dans le même chapitre.
(* Arêtes d'un arbre couvrant de poids minimal.
   Précondition : g est une liste d'arêtes (u, v, poids), n sommets numérotés
   de 0 à n-1. Complexité : O(m log m). *)
let kruskal n aretes =
  let triees = List.sort (fun (_,_,p1) (_,_,p2) -> compare p1 p2) aretes in
  let uf = creer n in
  List.filter (fun (u, v, _) ->
    if trouver uf u = trouver uf v then false      (* cycle : on écarte *)
    else begin unir uf u v; true end               (* on relie, on garde *)
  ) triees
Complexité : pour le tri, puis opérations quasi constantes. Le tri domine.
Démonstration (Par échange, comme au chapitre chap:gloutons)
Soit l'ensemble rendu par Kruskal et un arbre couvrant minimal ayant le plus d'arêtes en commun avec . Supposons , et soit la première arête choisie par Kruskal qui n'est pas dans .
Ajouter à crée un unique cycle, lequel contient nécessairement une autre arête reliant la classe de à celle de au moment où Kruskal a examiné . Cette n'a pas été prise par Kruskal avant — sinon et auraient déjà été dans la même classe et aurait été écartée. Comme Kruskal traite les arêtes par poids croissant, .
Alors est encore un arbre couvrant, de poids . Donc est minimal lui aussi, et il a une arête de plus en commun avec : cela contredit le choix de .
Le programme suggère de « mentionner l'adaptation au problème du chemin le plus large dans un graphe non orienté » : trouver, entre deux sommets, le chemin dont l'arête la plus faible est la plus forte possible — le trajet d'un convoi limité par le pont le plus fragile.
L'arbre couvrant maximal — Kruskal en triant par poids décroissant — le résout : le chemin unique entre deux sommets dans cet arbre est un chemin le plus large. La même structure, un tri retourné.
| Kruskal | Dijkstra (ch. chap:parcours) | |
|---|---|---|
| Ce qu'il construit | un arbre couvrant minimal | les plus courts chemins |
| Ce qu'il trie | les arêtes, une fois | les sommets, au fil de l'eau |
| Sa structure | unir & trouver | file de priorité |
| Sa preuve | échange d'arêtes | minimalité du sommet extrait |
Les deux sont gloutons, et aucun des deux ne revient sur un choix. Ce qui diffère est la question — relier au moindre coût, ou atteindre au plus vite — et donc la structure qui y répond.
La confusion est fréquente. Sur un triangle de poids , et , l'arbre couvrant minimal prend les deux arêtes de poids , et le chemin qu'il offre entre les extrémités de l'arête de vaut — plus que l'arête directe qu'il a écartée. Minimiser le poids total n'est pas minimiser chaque distance.
23.5 Ce qu'il faut retenir
- La structure ne répond qu'à une question : même classe ou non. Cette pauvreté est ce qui la rend rapide.
- Deux naïvetés, chacune bonne pour une opération et mauvaise pour l'autre : le tableau de classes, la forêt sans équilibrage.
- Union par rang (accrocher le petit sous le grand, hauteur ) et compression de chemin (raccrocher à la racine en remontant, la structure s'aplatit à l'usage).
- Ensemble, elles donnent un coût amorti quasi constant — analyse admise par le programme.
- Kruskal trie les arêtes et écarte celles qui ferment un cycle. La preuve est un échange d'arêtes, et un arbre couvrant minimal ne donne pas les plus courts chemins.