Apprentissage automatique
Cours · informatique (MP2I/MPI), chapitre 26 · MP2I et MPI · le début du chapitre, la suite sur Adloun
26.1 Ce que le programme demande, et ce qu'il n'attend pas
Ce chapitre est le plus jeune du livre, et le programme y met une mise en garde qu'il faut lire avant tout le reste : « la connaissance des théories sous-jacentes aux algorithmes de cette section n'est pas un attendu du programme. Les étudiants acquièrent une familiarité avec les idées qu'ils peuvent réinvestir dans des situations où les modélisations et les recommandations d'implémentation sont guidées. »
Autrement dit : on apprend ce que font ces algorithmes, on sait les écrire quand on est guidé, et l'on ne démontre ni leur convergence ni leurs garanties statistiques. Le programme écarte d'ailleurs explicitement la démonstration de convergence des -moyennes.
- Supervisé : les données d'apprentissage portent une étiquette — une réponse connue — et l'on veut prédire celle de données nouvelles.
- Non supervisé : aucune étiquette ; on cherche une structure dans les données, typiquement des paquets.
26.2 Apprentissage supervisé
26.2.1 Les plus proches voisins
Méthode : L'algorithme le plus simple qui soit
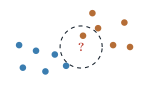
Pour classer un point nouveau : trouver ses plus proches voisins parmi les données étiquetées, et lui donner l'étiquette majoritaire. Le programme fixe la distance : euclidienne.
(* Étiquette prédite pour x par les k plus proches voisins.
   Précondition : k >= 1, donnees non vide. Complexité : O(n·d + n log n). *)
let knn donnees k x =
  let d2 (p, _) =
    Array.fold_left (+.) 0.0
      (Array.mapi (fun i xi -> (xi -. p.(i)) ** 2.0) x)
  in
  let triees = List.sort (fun a b -> compare (d2 a) (d2 b)) donnees in
  let voisins = prendre k triees in
majoritaire (List.map snd voisins)Il n'y a pas de phase d'entraînement : le modèle est l'ensemble des données. Tout le coût est reporté sur la prédiction, qui parcourt les points à chaque requête. C'est l'inverse des méthodes suivantes, longues à entraîner et instantanées à interroger.
Le choix de arbitre entre deux défauts : recopie le bruit des données ; trop grand lisse jusqu'à ignorer les structures fines. Aucune règle ne le fixe — on l'évalue.
Le programme cite les arbres dimensionnels (-d trees), qui accélèrent la recherche des voisins. L'idée est celle de la dichotomie du chapitre chap:diviser, portée en dimension : on découpe l'espace par un hyperplan perpendiculaire à un axe, en alternant les axes à chaque niveau, et l'on construit ainsi un arbre binaire.
La recherche descend vers la région du point, puis ne remonte explorer la région voisine que si la distance à l'hyperplan est inférieure au meilleur candidat trouvé — c'est un élagage, exactement au sens du chapitre chap:exploration. On passe de à en moyenne, en petite dimension.
26.2.2 Les arbres de décision et l'algorithme ID3
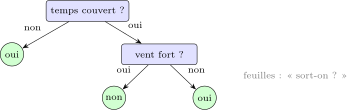
Un arbre de décision pose une question à chaque nœud interne et porte une étiquette à chaque feuille. Classer un exemple, c'est descendre selon ses réponses. Le programme restreint « au cas d'arbres binaires » : chaque question est un test à deux issues.
Exercices du chapitre
- Un vote sans majorité corrigé
- L'unité change le voisin corrigé
- La matrice de confusion d'un dépistage corrigé
- L'erreur d'entraînement de -NN corrigé
- Le gain nul du ou exclusif corrigé
- Quand faut-il visiter l'autre côté ? corrigé