Algorithmique de l'apprentissage : voisins et moyennes
Cours · informatique (tronc commun des prépas scientifiques), chapitre 19 · prépas scientifiques, tronc commun · le début du chapitre, la suite sur Adloun
19.1 Introduction et motivation
Comment un programme reconnaît-il un chiffre manuscrit, un courriel indésirable, une tumeur sur une image ? Pas par une suite de if écrits à la main — personne ne sait écrire la règle « ceci est un 7 ». L'apprentissage automatique renverse la démarche : au lieu de coder la règle, on fournit des exemples, et l'algorithme en tire ses réponses. Ce chapitre présente les deux algorithmes d'apprentissage du programme — choisis parce qu'ils sont simples, géométriques, et représentatifs des deux grandes familles :
l'algorithme des plus proches voisins, pour l'apprentissage supervisé : on dispose d'exemples étiquetés (cette mesure cette catégorie), et il faut classer un nouveau venu — réponse de bon sens : regarder ses voisins les plus proches, et voter ; et l'algorithme des -moyennes, pour l'apprentissage non supervisé : aucune étiquette, seulement un nuage de points — et il faut y découvrir des groupes naturels.
Aucune magie : des distances euclidiennes, des tris, des moyennes et des boucles — tout l'outillage des chapitres précédents. Mais aussi de vraies questions nouvelles, qui font le métier : comment évaluer honnêtement un classifieur (la matrice de confusion, le piège de l'évaluation sur les données d'entraînement) ? pourquoi faut-il normaliser les données ? et que signifie « converger vers un minimum local » — la première rencontre du cours avec un algorithme qui s'arrête sans garantie d'optimalité ?
19.2 Des données aux points : la distance
Chaque individu est décrit par attributs numériques — un point de : une fleur par (longueur, largeur) de pétale, un fruit par (masse, diamètre), une image par ses pixels (chapitre 8 : un point de !). La proximité se mesure par la distance euclidienne :
def distance(x: list, y: list) -> float:
    return sum((x[i] - y[i]) ** 2 for i in range(len(x))) ** 0.5
(Pour comparer des distances, le carré suffit — la racine est croissante ; on l'économise souvent.)
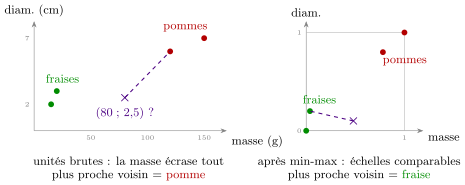
Si l'attribut 1 est une masse en grammes ( à ) et l'attribut 2 un diamètre en mètres ( à ), la distance euclidienne ne voit que la masse : l'écart au carré du diamètre est microscopique en face. Avant tout calcul de distance, ramener les attributs à des échelles comparables — la normalisation min-max envoie chaque attribut sur :
(minimum et maximum calculés sur le jeu d'entraînement, et réappliqués tels quels aux nouveaux points). L'exercice 6 montre un classifieur entier qui change d'avis selon l'unité de mesure — un algorithme correct sur des données mal préparées reste un mauvais système : en apprentissage, la préparation des données fait partie de l'algorithme.