Recherche séquentielle et dictionnaires
Cours complet · informatique (tronc commun des prépas scientifiques), chapitre 2 · prépas scientifiques, tronc commun
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
<i class="fa-solid fa-compass mr-2" style="color:#9A563B"></i>2.1 Introduction et motivation
Chercher : voilà sans doute l'opération la plus exécutée de toute l'informatique. Un nom dans un répertoire, un mot dans un texte, le plus grand échantillon d'une série de mesures — derrière chacune de ces questions se cache un parcours de tableau, l'algorithme le plus simple qui soit et pourtant le premier où tout se joue : la spécification du chapitre 1 s'y applique, l'invariant y fait sa première vraie preuve, et une question nouvelle surgit — combien de temps cela prend-il ?
Ce chapitre installe donc le second pilier du cours : la complexité, c'est-à-dire l'estimation asymptotique du coût d'un algorithme dans le cas le pire. On y rencontre les deux premières classes de coût — constant et linéaire — et un personnage qui les illustre à merveille : le dictionnaire de Python, utilisé en boîte noire, qui retrouve une valeur en temps constant là où le tableau exige un parcours complet.
2.2 Le coût d'un algorithme
2.2.1 Compter quoi, et dans quel cas ?
Le coût d'une exécution est le nombre d'opérations élémentaires effectuées : affectations, comparaisons, opérations arithmétiques, accès à une case de tableau — chacune comptée pour un temps constant. On exprime ce coût en fonction de la taille de l'entrée (notée : longueur du tableau, nombre de caractères du texte, etc.).
Pour une taille donnée, toutes les entrées ne coûtent pas le même prix : chercher un élément placé en tête est immédiat, le chercher en vain oblige à tout lire. Le programme retient le coût dans le cas le pire :
C'est une garantie : aucune entrée de taille ne coûtera davantage. Un algorithme rapide « en général » mais catastrophique sur certaines entrées ne vaut rien pour qui doit s'engager sur un temps de réponse.
2.2.2 L'estimation asymptotique
Compter les opérations une à une est aussi fastidieux qu'inutile : entre et opérations, la différence relève du détail d'implémentation — du langage, de la machine. Ce qui compte est le comportement quand grandit : doubler la taille de l'entrée double-t-il le temps, le quadruple-t-il, ou ne change-t-il presque rien ?
Soient et deux fonctions de dans . On dit que s'il existe une constante et un rang tels que
Autrement dit : à une constante multiplicative près, ne croît pas plus vite que . Ainsi , : les deux algorithmes correspondants ont le même comportement asymptotique, dit linéaire.
La notation jette volontairement deux informations : les constantes multiplicatives et les termes d'ordre inférieur. On écrit donc aussi bien pour que pour opérations ; et , car pour grand le terme écrase le reste. Cette perte est un gain : elle rend la mesure indépendante de la machine et du langage, et ne retient que la nature de l'algorithme.
- Un traitement est à coût constant, noté , si son nombre d'opérations est borné indépendamment de : accéder à
t[i], comparer deux nombres, affecter une variable. - Un algorithme est à coût linéaire, noté , si son coût dans le cas le pire est au plus proportionnel à : c'est la signature d'un nombre borné de parcours du tableau.
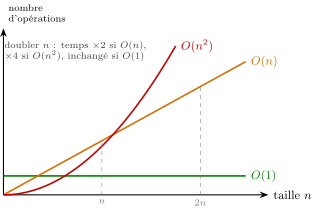
Complexité : L'échelle de lecture
Pour se représenter ce que ces classes signifient, supposons une machine exécutant opérations élémentaires par seconde, et (un tableau d'un milliard de cases) :
| Coût | Opérations pour | Temps approximatif |
|---|---|---|
| quelques-unes | instantané | |
| seconde | ||
| (chapitre 3) | ans |
La complexité n'est pas une élégance théorique : c'est la frontière entre ce qui répond dans la seconde et ce qui ne répondra jamais.
2.3 Manipulations élémentaires d'un tableau
Méthode : Les gestes de base et leur coût
Pour une liste Python t de longueur :
| Geste | Écriture | Coût |
|---|---|---|
| Lire ou écrire une case | `t[i]`, `t[i] = v` | |
| Longueur | `len(t)` | |
| Ajouter en queue | `t.append(v)` | |
| Parcourir | `for x in t` ou `for i in range(n)` | |
| Tester l'appartenance | `v in t` | — un parcours caché ! |
| Copier | `list(t)` |
La ligne piège est l'avant-dernière : v in t a l'air d'un test anodin, c'est une recherche séquentielle complète. L'écrire dans une boucle transforme silencieusement un algorithme linéaire en algorithme quadratique.
Calculer la somme des éléments se fait par valeurs ou par indices :
def somme(t: list) -> float:
    s = 0
    for x in t:        # parcours par VALEURS
        s += x
    return s

def somme_indices(t: list) -> float:
    s = 0
    for i in range(len(t)):    # parcours par INDICES
        s += t[i]
    return s
Les deux sont en . Le parcours par valeurs est plus lisible quand on ne se sert pas de la position ; le parcours par indices devient nécessaire dès qu'on compare des cases entre elles ( et ), qu'on écrit dans le tableau, ou que la position fait partie du résultat.
2.4 La recherche séquentielle
2.4.1 L'algorithme et sa preuve
La recherche séquentielle (ou linéaire) d'une valeur dans un tableau examine les cases une à une, dans l'ordre, et s'arrête à la première occurrence :
def recherche(v, t: list):
    """Renvoie le plus petit i tel que t[i] == v, ou None si v est absent."""
    for i in range(len(t)):
        # Invariant : v n'apparaît pas dans t[0..i-1]
        if t[i] == v:
            return i
    return None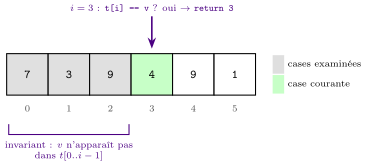
Démonstration (Correction)
L'invariant : « » est vrai initialement (préfixe vide) et conservé : on n'atteint le tour que si le test t[i] == v a échoué, ce qui étend l'invariant d'une case. Deux sorties possibles. Si la fonction renvoie : alors et, par l'invariant, aucun indice plus petit ne convient — c'est bien le plus petit indice. Si la boucle s'achève : dit que n'apparaît nulle part, et None est conforme au contrat. La terminaison est acquise (boucle for).
Complexité : Recherche séquentielle
Chaque tour coûte (un test, une comparaison d'égalité). Dans le cas le pire — élément absent, ou présent en dernière position — la boucle fait tours : le coût est , linéaire. Dans le meilleur cas ( en tête), un seul tour suffit : le cas le pire et le meilleur cas peuvent être très éloignés, et c'est bien le pire que l'on garantit.
Peut-on faire mieux que comparaisons dans le cas le pire ? Pas sans hypothèse supplémentaire : si le tableau est quelconque, toute case non examinée pourrait contenir , et un adversaire malicieux placerait précisément là. Il faudra une structure — un tableau trié (chapitre 5) ou un dictionnaire (section suivante) — pour battre la recherche séquentielle.
2.4.2 Maximum, et second maximum
Le chapitre 1 a spécifié, testé et prouvé la fonction ; on retient sa forme canonique, en :
def maximum(t: list) -> float:
    """Renvoie le plus grand élément de t. Précondition : t non vide."""
    m = t[0]
    for i in range(1, len(t)):
        # Invariant : m est le maximum de t[0..i-1]
        if t[i] > m:
            m = t[i]
    return m
Elle effectue exactement comparaisons d'éléments — et l'on peut démontrer qu'aucun algorithme ne peut faire moins : pour certifier un maximum, chacun des autres éléments doit avoir perdu au moins une comparaison.
Le second maximum (le plus grand élément du tableau privé d'une occurrence du maximum) se calcule naïvement en deux passages : trouver le max, puis le max du reste. Un seul passage suffit, en maintenant deux champions :
def deux_maximums(t: list) -> tuple:
    """Renvoie (m1, m2) : le maximum de t et le second maximum.
    Précondition : len(t) >= 2."""
    if t[0] >= t[1]:
        m1, m2 = t[0], t[1]
    else:
        m1, m2 = t[1], t[0]
    for i in range(2, len(t)):
        # Invariant : (m1, m2) sont les deux plus grands de t[0..i-1]
        if t[i] > m1:
            m1, m2 = t[i], m1      # nouveau champion : l'ancien devient second
        elif t[i] > m2:
            m2 = t[i]              # nouveau second seulement
    return (m1, m2)
Le point délicat est la ligne du nouveau champion : l'ancien maximum ne disparaît pas, il descend à la deuxième place. L'oublier — écrire m1 = t[i] seul — est le bogue classique, que le jeu de tests deux_maximums([1, 5, 9]) attrape aussitôt ( doit valoir , pas ).
Avec des doublons, le contrat doit trancher (chapitre 1 !) : pour , notre spécification donne — le second maximum est la deuxième occurrence de . L'autre contrat (« le plus grand élément strictement inférieur au maximum », donnant ) est tout aussi défendable : c'est l'énoncé qui décide, jamais l'implémentation.
2.5 Les dictionnaires
2.5.1 Une boîte noire à accès direct
Un dictionnaire (type dict) associe des valeurs à des clés : là où un tableau est indexé par les entiers , un dictionnaire est indexé par des clés arbitraires (nombres, chaînes, tuples…). Les gestes de base :
d = {}                      # dictionnaire vide
d["pommes"] = 3             # associer la valeur 3 à la clé "pommes"
d["pommes"]                 # lire la valeur associée -> 3 (KeyError si absente)
"poires" in d               # la clé existe-t-elle ?  -> False
d.get("poires", 0)          # lire avec valeur par défaut -> 0
del d["pommes"]             # supprimer une association
for cle in d:               # parcourir les clés
    print(cle, d[cle])
L'annexe du programme exige l'itération via d.keys() et d.items() ; le raccourci for cle in d leur est équivalent.
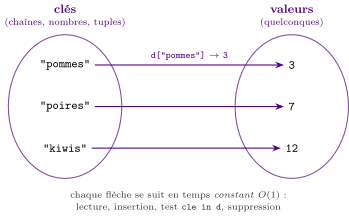
On utilise le dictionnaire en boîte noire : son mécanisme interne (la table de hachage) est hors programme. On admet son contrat de coût : l'insertion, la lecture, le test d'appartenance et la suppression s'effectuent en temps constant — contre pour le test v in t sur une liste. C'est l'écart entre ouvrir un annuaire à la bonne page et le lire ligne à ligne.
2.5.2 Le comptage : l'idiome fondamental
Combien de fois chaque valeur apparaît-elle dans ? Le dictionnaire répond en un seul parcours :
def comptage(t: list) -> dict:
    """Renvoie le dictionnaire {valeur: nombre d'occurrences dans t}."""
    c = {}
    for x in t:
        # Invariant : c[v] est le nb d'occurrences de v dans la partie déjà vue
        c[x] = c.get(x, 0) + 1
    return c

assert comptage([1, 2, 1, 1]) == {1: 3, 2: 1}
assert comptage([]) == {}
L'idiome c.get(x, 0) + 1 traite d'un même geste la première apparition (défaut ) et les suivantes (get est hors annexe — la version exigible est le test if x in c). Coût : tours à chacun, soit — alors que compter chaque valeur par t.count(x) dans une boucle coûterait parcours complets, un gaspillage quadratique.
Le tableau contient-il deux fois la même valeur ? Version dictionnaire, :
def a_un_doublon(t: list) -> bool:
    vus = {}
    for x in t:
        if x in vus:            # O(1) : c'est un dictionnaire
            return True
        vus[x] = True
    return False
La même fonction avec if x in deja_vus sur une liste serait correcte… et quadratique : chaque test cacherait un parcours. Le choix de la structure de données est le choix de la complexité.
Méthode : Quand penser au dictionnaire ?
Trois signaux dans un énoncé appellent un dictionnaire :
- « combien de fois… » : comptage (
c[x] = c.get(x, 0) + 1) ; - « a-t-on déjà vu… » : mémoire des éléments rencontrés (test d'appartenance en ) ;
- « associer à chaque… » : table d'association clé valeur (index, annuaire, inventaire).
Dans les trois cas, le dictionnaire remplace un parcours répété ( par question) par un accès direct () — et fait souvent passer l'algorithme entier de quadratique à linéaire.
<i class="fa-solid fa-dumbbell mr-2" style="color:#2E7559"></i>2.6 Exercices résolus
Niveau (Application directe du cours)
Donner le coût asymptotique, en fonction de len(t), de chacun des fragments :
# (a)
x = t[0] + t[-1]

# (b)
s = 0
for x in t:
    if x > 0:
        s += x

# (c)
p = 0
for x in t:
    if x in t:      # !
        p += 1
Démonstration (Solution)
(a) Deux accès et une addition : , quel que soit — t[-1] désigne la dernière case (l'indexation négative est une commodité Python, hors annexe du programme).
(b) Un parcours, chaque tour en : — le test if ne change rien à l'asymptotique, il borne juste le travail de chaque tour.
(c) Le piège : x in t est une recherche séquentielle, à chaque tour. Au total : quadratique — pour calculer ce qui vaut toujours len(t) ! (Un coût se lit en multipliant le nombre de tours par le coût d'un tour, en n'oubliant aucun parcours caché.)
Écrire derniere_occurrence(v, t) (plus grand indice tel que , ou None) en un seul parcours, donner son invariant et son coût.
Démonstration (Solution)
On parcourt tout le tableau en retenant la dernière position vue :
def derniere_occurrence(v, t: list):
    pos = None
    for i in range(len(t)):
        # Invariant : pos est le plus grand indice j < i tel que t[j] == v,
        #             ou None si v est absent de t[0..i-1]
        if t[i] == v:
            pos = i
    return pos
L'invariant est conservé : si , le plus grand indice devient ; sinon il ne change pas. À la sortie (), pos est le plus grand indice de tout le tableau, ou None. Coût : , et l'on ne peut pas s'arrêter plus tôt — contrairement à la première occurrence, la dernière exige d'avoir tout vu (une occurrence pourrait se cacher dans la partie non lue). (Parcourir à l'envers et s'arrêter à la première trouvaille est l'alternative : même pire cas , mais meilleur cas .)
Un texte est donné comme une chaîne s. Écrire frequences(s) qui renvoie le dictionnaire des fréquences de chaque caractère, puis l'utiliser pour trouver le caractère le plus fréquent de "abracadabra".
Démonstration (Solution)
def frequences(s: str) -> dict:
    """Renvoie {caractère: nombre d'apparitions dans s}."""
    f = {}
    for c in s:
        f[c] = f.get(c, 0) + 1
    return f

f = frequences("abracadabra")
# f == {'a': 5, 'b': 2, 'r': 2, 'c': 1, 'd': 1}
plus_frequent = None
for c in f:
    if plus_frequent is None or f[c] > f[plus_frequent]:
        plus_frequent = c
# plus_frequent == 'a'
Deux étages, tous deux linéaires : le comptage parcourt les caractères (), la recherche du maximum parcourt les clés du dictionnaire — au plus , donc aussi. (C'est le « maximum » du début du chapitre, appliqué non plus à un tableau mais aux clés d'un dictionnaire : les algorithmes se composent.)
Niveau (Application avec raisonnement intermédiaire)
Écrire indices_du_maximum(t) qui renvoie la liste de tous les indices où le maximum est atteint, en un seul parcours. Exemple : .
Démonstration (Solution)
On maintient le maximum courant et la liste de ses positions ; un nouveau champion remet la liste à zéro :
def indices_du_maximum(t: list) -> list:
    """Précondition : t non vide."""
    m, pos = t[0], [0]
    for i in range(1, len(t)):
        # Invariant : m = max(t[0..i-1]) et pos = liste des j < i avec t[j] == m
        if t[i] > m:
            m, pos = t[i], [i]      # nouveau maximum : on repart de lui seul
        elif t[i] == m:
            pos.append(i)           # une position de plus pour le même maximum
    return pos

assert indices_du_maximum([3, 7, 1, 7]) == [1, 3]
assert indices_du_maximum([5]) == [0]
assert indices_du_maximum([2, 2, 2]) == [0, 1, 2]
La subtilité est la remise à zéro pos = [i] : les anciennes positions concernaient un maximum désormais battu, elles ne valent plus rien. Coût . (Trois branches — strictement plus grand, égal, plus petit — et chacune mérite son test : c'est le tri des cas du chapitre 1 en action.)
Un élément est majoritaire dans s'il apparaît strictement plus de fois. Écrire majoritaire(t) qui le renvoie, ou None s'il n'existe pas, en coût .
Démonstration (Solution)
Le comptage par dictionnaire donne tout en deux parcours linéaires :
def majoritaire(t: list):
    c = {}
    for x in t:                    # passage 1 : compter
        c[x] = c.get(x, 0) + 1
    for v in c:                    # passage 2 : chercher un compte > n/2
        if c[v] > len(t) / 2:
            return v
    return None

assert majoritaire([2, 5, 2, 2]) == 2
assert majoritaire([2, 5, 2, 5]) is None    # 2 fois sur 4 : pas STRICTEMENT plus de n/2
assert majoritaire([]) is None
Coût : . La version sans dictionnaire — pour chaque élément, compter ses occurrences par un parcours — coûterait : le dictionnaire divise le travail par un facteur . (Au plus un élément peut être majoritaire — deux comptes ne peuvent excéder chacun — c'est pourquoi renvoyer le premier trouvé est correct.)
Un dictionnaire annuaire associe à chaque nom un numéro de téléphone (les numéros sont supposés distincts). Construire le dictionnaire inverse qui : numéro nom, puis adapter au cas où plusieurs noms partagent un numéro (le résultat associe alors à chaque numéro la liste des noms).
Démonstration (Solution)
def inverse(annuaire: dict) -> dict:
    """Précondition : les valeurs de annuaire sont deux à deux distinctes."""
    qui = {}
    for nom in annuaire:
        qui[annuaire[nom]] = nom
    return qui

def inverse_multi(annuaire: dict) -> dict:
    """Version générale : numéro -> liste des noms (sans précondition)."""
    qui = {}
    for nom in annuaire:
        num = annuaire[nom]
        if num not in qui:
            qui[num] = []
        qui[num].append(nom)
    return qui
Coût pour entrées dans les deux cas. La première version exige sa précondition : si deux noms partagent un numéro, l'écriture qui[num] = nom écrase silencieusement le premier — une erreur de logique sans aucun message, exactement le scénario contre lequel le chapitre 1 mettait en garde. La version multi remplace l'écrasement par l'accumulation dans une liste. (L'idiome « si la clé est neuve, créer une liste vide, puis ajouter » est le second réflexe-dictionnaire à connaître, après le comptage.)
Écrire deux_sommes(t, cible) qui détermine s'il existe deux indices tels que cible, en coût — et justifier le coût.
Démonstration (Solution)
L'idée : pour chaque rencontré, le partenaire idéal est ; un dictionnaire mémorise les valeurs déjà vues pour interroger le passé en :
def deux_sommes(t: list, cible: float) -> bool:
    vus = {}
    for x in t:
        # Invariant : vus contient exactement les valeurs de la partie déjà parcourue
        if (cible - x) in vus:
            return True
        vus[x] = True
    return False

assert deux_sommes([3, 8, 2, 5], 10) == True      # 8 + 2
assert deux_sommes([3, 8, 2, 5], 4) == False
assert deux_sommes([5, 5], 10) == True            # deux indices distincts, valeurs égales
assert deux_sommes([5], 10) == False              # un seul 5 : pas de paire
Chaque tour effectue un test d'appartenance et une insertion, tous deux : total . La version naïve à deux boucles imbriquées (tester tous les couples) coûte — le chapitre 3 lui est consacré. Noter que l'invariant règle finement le cas avec cible : quand on examine , le dictionnaire ne contient que le passé strict, donc pas lui-même — les deux indices sont automatiquement distincts. (Interroger « le passé » mémorisé dans un dictionnaire plutôt que re-parcourir : c'est le geste qui fait tomber un facteur .)
Niveau (Raisonnement subtil ou plusieurs étapes)
La fonction deux_maximums du cours effectue, dans le cas le pire, comparaisons d'éléments. Le vérifier, puis montrer comment obtenir le maximum et le second maximum en environ comparaisons, par la méthode du tournoi.
Démonstration (Solution)
Compte de la version du cours : l'initialisation coûte une comparaison ; chacun des tours coûte une comparaison si , deux sinon. Le pire cas — par exemple un tableau où presque aucun élément ne bat — donne comparaisons.
Le tournoi : faire s'affronter les éléments deux à deux comme dans une coupe — matchs désignent le champion . Observation clé : le second maximum a nécessairement perdu contre le champion (sinon, qui l'aurait éliminé ?). Or le champion n'a disputé que matchs (un par tour de la coupe) : il suffit de chercher le maximum parmi ses victimes, soit comparaisons de plus. Total : , contre . Pour : environ comparaisons au lieu de — presque deux fois moins. (Les deux algorithmes restent : l'asymptotique ne voit pas la différence, mais le compte exact des comparaisons, lui, se moque des constantes — les deux niveaux d'analyse coexistent, et le programme demande le premier.)
Deux mots sont des anagrammes s'ils contiennent les mêmes lettres avec les mêmes multiplicités (chien / niche). Écrire sont_anagrammes(u, v) en , puis groupes_anagrammes(mots) qui partitionne une liste de mots en groupes d'anagrammes.
Démonstration (Solution)
Deux mots sont anagrammes si et seulement si leurs dictionnaires de fréquences coïncident :
def sont_anagrammes(u: str, v: str) -> bool:
    return frequences(u) == frequences(v)      # exercice 3 ; comparaison de dicts
Pour grouper, il faut une clé canonique commune à tous les anagrammes d'un même groupe — le mot trié fait l'affaire :
def groupes_anagrammes(mots: list) -> list:
    groupes = {}
    for m in mots:
        cle = "".join(sorted(m))        # "chien" -> "cehin", "niche" -> "cehin"
        if cle not in groupes:
            groupes[cle] = []
        groupes[cle].append(m)
    return list(groupes.values())

g = groupes_anagrammes(["chien", "niche", "art", "rat", "tour"])
# [['chien', 'niche'], ['art', 'rat'], ['tour']]
sont_anagrammes est en : deux comptages linéaires et une comparaison de dictionnaires (linéaire en leur taille). (L'idée de la clé canonique — représenter toute une classe d'équivalence par un représentant calculable — resservira sans cesse : c'est elle qui transforme « être équivalents » en « avoir la même clé », testable en par dictionnaire.)
On considère la recherche séquentielle d'un élément présent, en supposant sa position uniformément distribuée parmi les cases. Calculer le nombre moyen de tours de boucle, comparer au pire cas, et expliquer pourquoi le programme d'informatique retient néanmoins le cas le pire.
Démonstration (Solution)
Si l'élément est en position (indices de à ), la boucle fait tours. La position étant uniforme :
En moyenne, on lit donc la moitié du tableau — deux fois mieux que le pire cas , mais toujours : la classe asymptotique ne change pas. Le programme retient le pire cas pour trois raisons. D'abord, c'est une garantie : « au plus tours » est vrai pour toute entrée, quand la moyenne suppose un modèle probabiliste (ici l'uniformité — qui la justifie ?). Ensuite, les entrées réelles sont rarement uniformes : dans bien des applications, le cas défavorable est précisément le plus fréquent (chercher un mot absent d'un index, par exemple, coûte toujours le pire cas ). Enfin, le pire cas se calcule par un simple maximum, quand la moyenne exige de probabiliser l'espace des entrées — un outil que le cours de mathématiques ne fournira qu'en fin d'année. (L'analyse en moyenne n'est pas au programme, mais savoir qu'elle existe évite un contresens : « linéaire dans le cas le pire » ne signifie pas « toujours aussi lent ».)
- Coût : nombre d'opérations élémentaires, fonction de la taille de l'entrée ; le programme retient le cas le pire sur les entrées de taille — une garantie.
- Notation : si à partir d'un rang ; on jette constantes et termes d'ordre inférieur () pour ne garder que la nature de l'algorithme, indépendante de la machine.
- Coût constant : accès
t[i],len,append, opérations arithmétiques. Coût linéaire : nombre borné de parcours. Piège :v in listeest un parcours caché () — dans une boucle, il rend l'algorithme quadratique. - Recherche séquentielle : premier indice de , invariant « absent du préfixe lu » ; pire cas (absent ou en dernière position) : ; sans structure supplémentaire, on ne peut pas faire mieux.
- Maximum : comparaisons, optimal ; second maximum en un passage avec deux champions (l'ancien maximum descend, ne disparaît pas) ; variante tournoi comparaisons.
- Dictionnaire (boîte noire) : clés arbitraires valeurs ; insertion, lecture,
in, suppression en admis ; trois réflexes — comptage (c[x] = c.get(x, 0) + 1), mémoire du déjà-vu, table d'association (et son inverse, avec listes en cas de collisions). - Le choix de la structure est le choix de la complexité : remplacer un parcours répété par un accès dictionnaire fait passer de à (doublons, deux-sommes, majoritaire, anagrammes par clé canonique).
2.7 Exercices d'entraînement
Cette banque d'exercices, classée par thème, couvre l'intégralité du chapitre. La numérotation prolonge celle des dix exercices résolus. Légende : application directe, raisonnement intermédiaire, approfondissement ; le symbole signale un classique incontournable.
A. Coûts et notation
- () Classer en ou :
t[len(t) // 2];sum(t);t.append(0);max(t);t[0] = t[-1];list(t). - () Montrer à partir de la définition que , que mais que .
- ( ) Donner le coût (cas le pire) de : un parcours qui s'arrête au premier élément négatif ; deux parcours successifs ; un parcours contenant
x in t; un parcours contenantx in d( dictionnaire). Justifier chaque réponse en une phrase. - () Chronométrer réellement
recherche(v, t)pour (moduletime, élément absent) et vérifier la proportionnalité au doublement — l'asymptotique rendue tangible.
B. Parcours de tableaux
- () Écrire en , avec invariant en commentaire :
minimum(t);moyenne(t);nb_negatifs(t);tous_positifs(t)(booléen, avec arrêt anticipé). - () Écrire
amplitude(t)(différence max min) en un seul parcours. - ( ) Écrire
est_croissante(t)(la liste est-elle triée en ordre croissant ?) ; préciser le contrat pour les égalités (croissance large ou stricte) et le coût. - () Écrire
indice_premier_pic(t): plus petit tel que , ouNone. Attention aux bornes : quel est le domaine valide de ? - () Le minimum glissant : étant donné et une largeur , renvoyer la liste des minimums de chaque fenêtre . Donner la version naïve et son coût () — on la battra au second semestre.
- ( ) Écrire
fusion_comptes(t): est une liste de couples (nom, montant) ; renvoyer la liste des (nom, total) sans doublon de nom, en , ordre d'apparition préservé.
C. Dictionnaires
- () Écrire
premier_unique(t): le premier élément n'apparaissant qu'une fois (ouNone), en deux passages . - () À partir d'une liste de mots, construire le dictionnaire longueur nombre de mots de cette longueur.
- ( ) Écrire
intersection(t, u): les valeurs présentes dans les deux listes, sans doublon, en — et expliquer pourquoi la double boucle naïve est en . - () Un fichier de notes fournit des couples (élève, note), un élève pouvant apparaître plusieurs fois. Construire en un passage le dictionnaire élève moyenne de ses notes (indication : mémoriser somme et effectif).
- ( ) Écrire
mode(t): la valeur la plus fréquente (en cas d'égalité, la première atteignant ce compte) ; jeu de tests imposé : liste vide, tous distincts, égalité de fréquences. - () Les clés d'un dictionnaire doivent être non modifiables : vérifier que
d[[1, 2]] = 0lèveTypeError, mais qued[(1, 2)] = 0est licite. En déduire comment mémoriser des couples déjà vus (positions sur une grille, par exemple), et écrirepremiere_case_revisitee(chemin)pour une liste de positions . - ( ) Écrire
plus_longue_serie_sans_repetition(t): la longueur de la plus longue tranche de sans valeur répétée, en (fenêtre glissante : dictionnaire valeur dernier indice vu, et borne gauche qui ne recule jamais).
D. Études et démonstrations
- () Prouver par invariant la correction de
tous_positifs(avec arrêt anticipé) : l'invariant doit justifier les deux sorties. - ( ) Montrer que tout algorithme correct de calcul du maximum effectue au moins comparaisons (chaque élément autre que le maximum doit perdre au moins une fois — argument du tournoi).
- () La recherche séquentielle avec sentinelle : placer en queue de tableau pour supprimer le test d'indice de la boucle. Écrire cette variante, compter les comparaisons économisées, et discuter : le contrat « non modifiée » est-il respecté ?
- ( ) On admet que le dictionnaire effectue ses opérations en en pratique, mais son pire cas théorique est . Construire un scénario d'usage où cette nuance change la garantie globale d'un algorithme, et expliquer pourquoi le programme choisit malgré tout la convention (coût amorti, boîte noire).