Modules, fichiers et données
Cours complet · informatique (tronc commun des prépas scientifiques), chapitre 4 · prépas scientifiques, tronc commun
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
<i class="fa-solid fa-compass mr-2" style="color:#9A563B"></i>4.1 Introduction et motivation
Un langage de programmation ne vit pas seul : autour du noyau de Python gravitent des modules — des boîtes à outils prêtes à l'emploi pour calculer (), simuler (), tracer (). Savoir s'en servir, c'est savoir trois choses : les importer, lire leur documentation, et garder à l'esprit qu'on les utilise en boîte noire — le programme officiel est explicite : aucune connaissance d'un module n'est exigible, mais leur usage accompagné de documentation est attendu.
Ce chapitre met ces outils au service d'un scénario complet et réaliste, celui que tout scientifique rencontre dès sa première séance de laboratoire : lire un fichier de mesures, calculer des statistiques, produire un graphique. Au passage, on découvre que les données du monde réel sont sales — lignes vides, valeurs manquantes, séparateurs variables — et que la discipline du chapitre 1 (spécifier, tester les cas limites) n'est pas un luxe d'école : c'est elle qui fait la différence entre un script qui marche sur l'exemple du cours et un outil qui survit au contact d'un vrai fichier.
4.2 Les modules
4.2.1 Importer
Un module est un ensemble de fonctions et de constantes regroupées sous un nom. Trois formes d'importation :
import math                    # forme de référence : on écrit math.sqrt(2)
import matplotlib.pyplot as plt    # alias consacré par l'usage
from math import sqrt, pi      # importe des noms précis : on écrit sqrt(2)
La première forme est la plus sûre : le préfixe math. dit d'où vient chaque fonction et évite les collisions de noms. La troisième s'autorise pour quelques noms très fréquents ; on s'interdit en revanche from math import *, qui déverse des dizaines de noms inconnus dans le programme.
import math
math.sqrt(2)       # 1.4142135623730951
math.pi            # 3.141592653589793
math.floor(3.7)    # 3 (partie entière inférieure)
math.log(8, 2)     # 3.0 (logarithme en base 2)
import random
random.random()           # flottant uniforme dans [0, 1[
random.randint(1, 6)      # entier uniforme entre 1 et 6 INCLUS (un dé)
random.choice(t)          # un élément de la liste t, au hasard
random.seed(42)           # fige la graine : exécutions reproductibles
L'appel random.seed(42) mérite le détour : il rend le « hasard » reproductible, ce qui est indispensable pour déboguer (revoir exactement la même exécution) et pour tester (jeux de tests déterministes sur des fonctions aléatoires — chapitre 1).
Méthode : Travailler avec une boîte noire
Face à une fonction de module inconnue, trois réflexes :
help(math.floor)ou la documentation en ligne : lire la spécification (que renvoie-t-elle ? quelles préconditions ?) ;- l'essai en console : deux ou trois appels sur des cas simples dont on connaît la réponse —
math.floor(-3.5)vaut-il ou ? (Réponse : — l'essai vaut mieux que l'intuition.) - ne jamais deviner : une fonction de module a un contrat, comme les nôtres au chapitre 1 ; l'utiliser sans le connaître, c'est programmer à l'aveugle.
4.3 Lire un fichier de données
4.3.1 Ouvrir, lire, fermer
Un fichier texte se lit ligne à ligne. La forme recommandée, qui garantit la fermeture du fichier même en cas d'erreur :
with open("mesures.txt", "r") as f:
    for ligne in f:
        ...                # ligne est une chaîne, AVEC son '\n' final
Chaque ligne contient le caractère de fin de ligne '\n' : le premier geste est presque toujours ligne.strip(), qui retire les blancs et sauts de ligne aux deux extrémités.
L'annexe du programme liste open, read, readline, readlines, split, write, close. La forme explicite f = open(...) … f.close() est la seule littéralement exigible — le with, plus sûr, la remplace avantageusement en pratique. f.read() lit tout le fichier d'un bloc, f.readline() une seule ligne.
Deux outils transforment une ligne en données :
"12.5;14.2;13.0".split(";")    # ['12.5', '14.2', '13.0'] : découpe sur un séparateur
float("12.5")                  # 12.5 : conversion chaîne -> flottant
int("42")                      # 42   : conversion chaîne -> entier
Attention au piège de typage : "12" + "3" vaut "123" (concaténation de chaînes) et "9" > "10" vaut True (comparaison alphabétique !) — tant que la conversion n'a pas eu lieu, on manipule du texte, pas des nombres.
Le fichier temperatures.csv contient un relevé par ligne, au format jour;température :
lundi;12.5
mardi;14.2
mercredi;13.0
def lire_releves(nom_fichier: str) -> list:
    """Renvoie la liste des couples (jour, température) du fichier.
    Précondition : chaque ligne non vide est au format jour;valeur."""
    releves = []
    with open(nom_fichier, "r") as f:
        for ligne in f:
            ligne = ligne.strip()
            if ligne == "":            # ignorer les lignes vides
                continue
            champs = ligne.split(";")
            releves.append((champs[0], float(champs[1])))
    return releves
Le test if ligne == "" n'est pas décoratif : les fichiers réels se terminent souvent par une ligne vide, et "".split(";") suivi de float(champs[1]) planterait sur IndexError. Les cas limites du chapitre 1 vivent dans les fichiers.
Pour écrire, on ouvre en mode "w" (écrasement) ou "a" (ajout) et l'on utilise f.write(chaine) — sans oublier le '\n' final de chaque ligne, que write, contrairement à print, n'ajoute pas.
4.4 Calculs statistiques
4.4.1 Les indicateurs et leur calcul
Pour une série de mesures :
La moyenne situe la série, l'écart-type mesure sa dispersion autour de la moyenne — deux séries de même moyenne peuvent décrire des réalités très différentes ( les distingue).
def moyenne(t: list) -> float:
    """Précondition : t non vide."""
    return sum(t) / len(t)

def ecart_type(t: list) -> float:
    """Précondition : t non vide."""
    m = moyenne(t)
    return (sum((x - m) ** 2 for x in t) / len(t)) ** 0.5

assert moyenne([2, 4, 6]) == 4
assert abs(ecart_type([2, 4, 6]) - 1.632993) < 1e-5
assert ecart_type([5, 5, 5]) == 0          # série constante : dispersion nulle
Coût : deux parcours, . Les tests suivent la règle du chapitre 1 — résultat exact comparé par == quand il est exact, par tolérance sinon.
La médiane d'une série est la valeur qui la coupe en deux moitiés : une fois la série triée, c'est l'élément central (effectif impair) ou la demi-somme des deux éléments centraux (effectif pair).
def mediane(t: list) -> float:
    """Précondition : t non vide."""
    s = sorted(t)                  # copie triée : t n'est pas modifiée
    n = len(s)
    if n % 2 == 1:
        return s[n // 2]
    return (s[n // 2 - 1] + s[n // 2]) / 2
Contrairement à la moyenne, la médiane résiste aux valeurs aberrantes : sur (une erreur de saisie), la moyenne explose à plus de quand la médiane reste — raison pour laquelle on calcule toujours les deux.
La fonction native sorted(t) renvoie une copie triée en (chapitre 9) sans modifier t ; sa cousine t.sort() trie en place. La confusion des deux — attendre de t.sort() une valeur de retour, qui est None — est une erreur de logique classique. Le module statistics de la bibliothèque standard fournit aussi mean, median, pstdev : libre à nous de l'utiliser après avoir su écrire ces trois fonctions nous-mêmes.
4.5 Représentation graphique
4.5.1 Trois graphiques avec matplotlib
Le module matplotlib.pyplot (alias plt) fournit :
import matplotlib.pyplot as plt

plt.plot(x, y)            # courbe : les points (x[i], y[i]) reliés
plt.bar(noms, valeurs)    # diagramme en barres : une barre par catégorie
plt.hist(t, bins=20)      # histogramme : répartition des valeurs de t en 20 classes
plt.show()                # afficher (ou plt.savefig("figure.png") pour enregistrer)
On choisit selon la nature des données : une évolution (le temps en abscisse) se trace en courbe, des catégories en barres, une distribution (comment les valeurs se répartissent) en histogramme.
import matplotlib.pyplot as plt

jours = list(range(1, 31))
temperatures = [12.5, 14.2, 13.0, 15.1, 16.3] * 6      # données du mois

plt.plot(jours, temperatures, label="température")
plt.xlabel("jour du mois")
plt.ylabel("température (degrés Celsius)")
plt.title("Relevés de janvier")
plt.legend()
plt.grid(True)
plt.show()
Une figure sans axes nommés ni titre est illisible une semaine plus tard — la compétence « communiquer » du programme commence ici : toute figure rendue porte ses étiquettes.
import random
random.seed(1)
# 1000 mesures simulées : somme de 10 dés (la cloche apparaît !)
mesures = [sum(random.randint(1, 6) for _ in range(10)) for _ in range(1000)]

plt.hist(mesures, bins=range(10, 61), edgecolor="black")
plt.xlabel("somme de 10 dés")
plt.ylabel("effectif")
plt.title("1000 lancers : la distribution se concentre autour de 35")
plt.show()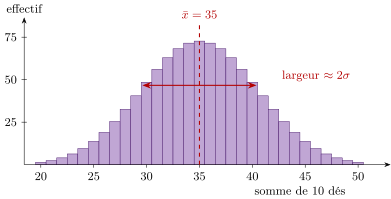
L'histogramme révèle ce que moyenne et écart-type résument : la forme de la distribution — ici une cloche centrée sur , dont la finesse est précisément ce que mesure.
4.6 Étude de cas : du fichier au graphique
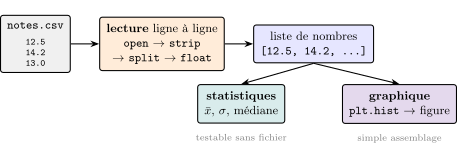
On dispose d'un fichier notes.csv (une note par ligne, sur 20). Produire la synthèse : effectif, moyenne, écart-type, médiane, et l'histogramme.
import matplotlib.pyplot as plt

def lire_notes(nom_fichier: str) -> list:
    notes = []
    with open(nom_fichier, "r") as f:
        for ligne in f:
            ligne = ligne.strip()
            if ligne != "":
                notes.append(float(ligne))
    return notes

notes = lire_notes("notes.csv")
print("effectif   :", len(notes))
print("moyenne    :", round(moyenne(notes), 2))
print("écart-type :", round(ecart_type(notes), 2))
print("médiane    :", mediane(notes))

plt.hist(notes, bins=range(0, 22), edgecolor="black")
plt.xlabel("note sur 20")
plt.ylabel("effectif")
plt.title("Répartition des notes")
plt.savefig("notes.png")
Le découpage en fonctions n'est pas cosmétique : lire_notes est testable seule (sur un petit fichier de trois lignes écrit pour l'occasion), les statistiques sont testables sans fichier, et le tracé n'est qu'un assemblage. Décomposer en blocs indépendants — la deuxième compétence du programme — c'est exactement cela.
<i class="fa-solid fa-dumbbell mr-2" style="color:#2E7559"></i>4.7 Exercices résolus
Niveau (Application directe du cours)
Sans machine, prédire la valeur de : math.floor(-2.5), round(2.5), round(3.5), random.randint(0, 1) (ses valeurs possibles), "3" * 2. Vérifier ensuite en console et corriger ses prédictions.
Démonstration (Solution)
math.floor(-2.5) vaut : le plancher descend, même pour les négatifs. round(2.5) vaut et round(3.5) vaut : Python arrondit les demi-entiers au pair le plus proche (arrondi du banquier), pas systématiquement au-dessus — c'est précisément l'ambiguïté de l'exercice 4 du chapitre 1, tranchée autrement que ce qu'on attend ! random.randint(0, 1) renvoie ou : les deux bornes sont incluses, contrairement à range. "3" 2 vaut "33" : répétition de chaîne, pas multiplication. (Cinq fonctions, trois surprises : la documentation et l'essai en console ne sont pas optionnels.)*
Écrire nb_donnees(nom_fichier) qui compte les lignes non vides et ne commençant pas par "#" (lignes de commentaire) d'un fichier.
Démonstration (Solution)
def nb_donnees(nom_fichier: str) -> int:
    c = 0
    with open(nom_fichier, "r") as f:
        for ligne in f:
            ligne = ligne.strip()
            if ligne != "" and not ligne.startswith("#"):
                c += 1
    return c
L'ordre des deux tests compte : ligne.startswith("#") sur la ligne déjà débarrassée de ses blancs traite aussi les commentaires indentés. Coût : un parcours du fichier, lignes. (Le motif « filtrer puis compter » est le squelette de la plupart des lectures de fichiers ; les lignes de commentaire en tête de fichier sont une convention très répandue dans les données scientifiques.)
Utiliser random pour estimer la probabilité d'obtenir au moins un six en quatre lancers de dé (le pari du chevalier de Méré), sur expériences, et comparer à la valeur exacte .
Démonstration (Solution)
import random
random.seed(0)

def au_moins_un_six() -> bool:
    for _ in range(4):
        if random.randint(1, 6) == 6:
            return True
    return False

n = 100_000
succes = sum(1 for _ in range(n) if au_moins_un_six())
frequence = succes / n
exacte = 1 - (5 / 6) ** 4          # 0.5177...
print(frequence, exacte)            # par exemple 0.5181 contre 0.5177
assert abs(frequence - exacte) < 0.01
La fréquence observée approche la probabilité exacte à mieux que — la loi des grands nombres, rencontrée ici expérimentalement avant d'être un théorème du cours de mathématiques. La graine figée rend le test reproductible : sans elle, l'assertion pourrait (très rarement) échouer par pur hasard. (La simulation est l'outil de contrôle des probabilités : quand le calcul exact est hors de portée, elle donne l'ordre de grandeur ; quand il est connu, elle le vérifie.)
Niveau (Application avec raisonnement intermédiaire)
Le fichier de relevés contient parfois la mention NA (valeur manquante) à la place d'un nombre. Adapter lire_releves pour ignorer ces lignes en les comptant, et renvoyer le couple (liste des relevés valides, nombre de lignes ignorées). Pourquoi est-il important de compter ce qu'on ignore ?
Démonstration (Solution)
def lire_releves_robuste(nom_fichier: str) -> tuple:
    releves, ignorees = [], 0
    with open(nom_fichier, "r") as f:
        for ligne in f:
            ligne = ligne.strip()
            if ligne == "":
                continue
            champs = ligne.split(";")
            if len(champs) != 2 or champs[1] == "NA":
                ignorees += 1
                continue
            releves.append((champs[0], float(champs[1])))
    return (releves, ignorees)
Compter les rejets est une exigence de validation : si des lignes sont écartées, la moyenne calculée sur le reste ne décrit plus la série — et sans le compteur, personne ne le saurait. Un programme qui ignore silencieusement des données produit des résultats faux avec l'air d'être justes : c'est l'erreur de logique du chapitre 1, version données. (Le test len(champs) != 2 attrape au passage les lignes mal formées — une robustesse qui ne coûte qu'une ligne.)
La formule de Kœnig-Huygens (moyenne des carrés moins carré de la moyenne) permet de calculer la variance en un seul parcours. Écrire cette version, vérifier qu'elle coïncide avec la version en deux passages, et signaler son talon d'Achille numérique.
Démonstration (Solution)
def variance_un_passage(t: list) -> float:
    """Précondition : t non vide."""
    s, s2 = 0.0, 0.0
    for x in t:
        s += x
        s2 += x * x
    n = len(t)
    return s2 / n - (s / n) ** 2

t = [2, 4, 6, 8]
assert abs(variance_un_passage(t) - ecart_type(t) ** 2) < 1e-12
Un seul parcours au lieu de deux — précieux si les données arrivent en flux et ne tiennent pas en mémoire. Le talon d'Achille : quand la moyenne est grande devant l'écart-type (mesures autour de à ), et sont deux nombres immenses et presque égaux ; leur différence perd presque tous ses chiffres significatifs (annulation catastrophique), au point de pouvoir sortir négative. La version en deux passages, qui soustrait la moyenne avant d'élever au carré, n'a pas ce défaut. (Deux formules mathématiquement égales ne sont pas numériquement équivalentes — première rencontre avec une réalité du calcul flottant qui reviendra souvent.)
Écrire histogramme(t, a, b, k) qui répartit les valeurs de t en classes de même largeur couvrant et renvoie la liste des effectifs — c'est ce que plt.hist calcule avant de dessiner. Préciser le sort des valeurs hors de et la classe d'une valeur frontière.
Démonstration (Solution)
La classe d'une valeur s'obtient sans boucle, par une division :
def histogramme(t: list, a: float, b: float, k: int) -> list:
    """Effectifs des k classes [a + i*h, a + (i+1)*h[, h = (b-a)/k.
    Les valeurs hors de [a, b[ sont ignorées. Précondition : a < b, k >= 1."""
    effectifs = [0] * k
    h = (b - a) / k
    for x in t:
        if a <= x < b:
            i = int((x - a) // h)
            if i == k:            # garde-fou flottant (x très proche de b)
                i = k - 1
            effectifs[i] += 1
    return effectifs

assert histogramme([1, 2, 2, 7, 9], 0, 10, 5) == [1, 2, 0, 1, 1]
assert histogramme([10], 0, 10, 5) == [0, 0, 0, 0, 0]    # b est EXCLU
Une valeur frontière entre deux classes ( exactement) tombe dans la classe de droite — conséquence directe du // — et la spécification le dit. Le garde-fou sur pare aux arrondis flottants quand frôle . Coût : . (Calculer l'indice de classe par division plutôt qu'en testant les classes une à une : c'est le passage de à — le réflexe d'accès direct du chapitre 2, version numérique.)
Le fichier ventes.csv contient des lignes produit;montant. Calculer en un seul parcours la moyenne des montants par produit, et afficher le résultat trié par moyenne décroissante. (Combiner le dictionnaire du chapitre 2 et la lecture de fichier.)
Démonstration (Solution)
On accumule par clé le couple (somme, effectif) — jamais la liste complète des montants, inutilement coûteuse :
def moyennes_par_produit(nom_fichier: str) -> dict:
    sommes, effectifs = {}, {}
    with open(nom_fichier, "r") as f:
        for ligne in f:
            ligne = ligne.strip()
            if ligne == "":
                continue
            produit, montant = ligne.split(";")
            sommes[produit] = sommes.get(produit, 0.0) + float(montant)
            effectifs[produit] = effectifs.get(produit, 0) + 1
    return {p: sommes[p] / effectifs[p] for p in sommes}

moyennes = moyennes_par_produit("ventes.csv")
classement = sorted(moyennes, key=lambda p: moyennes[p], reverse=True)
for p in classement:
    print(p, round(moyennes[p], 2))
Coût : un parcours du fichier en , puis un tri des produits en — avec en général très inférieur à . (L'idiome sorted(d, key=...), avec sa fonction lambda — hors annexe du programme, fourni avec sa documentation —, trie les clés d'un dictionnaire selon un critère calculé : avec reverse=True, le classement tombe en une ligne. La double accumulation somme/effectif est la version « flux » de la moyenne — exactement l'exercice 24 du chapitre 2, ici branché sur un vrai fichier.)
Niveau (Raisonnement subtil ou plusieurs étapes)
Estimer en tirant points uniformes dans le carré et en comptant la proportion qui tombe dans le quart de disque . Justifier l'estimateur, l'implémenter, mesurer l'erreur pour , et commenter la vitesse de convergence.
Démonstration (Solution)
La probabilité qu'un point uniforme du carré tombe dans le quart de disque est le rapport des aires : . La fréquence observée estime donc , et estime :
import random
random.seed(2)

def estime_pi(n: int) -> float:
    dans_le_disque = 0
    for _ in range(n):
        x, y = random.random(), random.random()
        if x * x + y * y <= 1:
            dans_le_disque += 1
    return 4 * dans_le_disque / n

import math
for n in (100, 10_000, 1_000_000):
    e = estime_pi(n)
    print(n, e, abs(e - math.pi))
# erreurs typiques :  0.1 ;  0.01 ;  0.001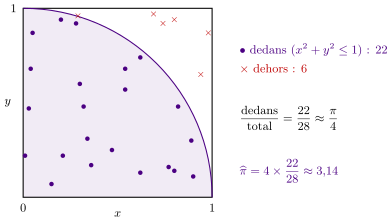
L'erreur observée est divisée par quand est multiplié par : elle décroît comme — c'est la signature des méthodes de Monte-Carlo, que le cours de probabilités justifiera (écart-type d'une moyenne empirique). Conséquence pratique : chaque décimale supplémentaire de coûte cent fois plus de tirages — Monte-Carlo est robuste et simple, mais lentement convergent. (Retenir le trio : justification de l'estimateur par un argument d'aires, graine figée pour la reproductibilité, étude expérimentale de l'erreur en fonction de .)
Le fichier stations.csv contient station;t1;t2;...;tk — un nombre de mesures variable selon la station. Produire le rapport : pour chaque station, son nombre de mesures, sa moyenne et son maximum, en une seule lecture, puis tracer un diagramme en barres des moyennes.
Démonstration (Solution)
import matplotlib.pyplot as plt

def rapport_stations(nom_fichier: str) -> dict:
    """Renvoie {station: (nb, moyenne, maximum)}.
    Précondition : chaque ligne non vide contient au moins une mesure."""
    rapport = {}
    with open(nom_fichier, "r") as f:
        for ligne in f:
            ligne = ligne.strip()
            if ligne == "":
                continue
            champs = ligne.split(";")
            nom = champs[0]
            mesures = [float(c) for c in champs[1:]]
            rapport[nom] = (len(mesures),
                            sum(mesures) / len(mesures),
                            max(mesures))
    return rapport

rapport = rapport_stations("stations.csv")
noms = list(rapport)
plt.bar(noms, [rapport[n][1] for n in noms])
plt.ylabel("température moyenne")
plt.title("Moyenne par station")
plt.show()
La compréhension [float(c) for c in champs[1:]] convertit toutes les mesures d'un coup — la tranche champs[1:] écarte le nom. La précondition « au moins une mesure » protège la division et le max ; une version robuste compterait les stations sans mesure comme l'exercice 4 comptait ses rejets. (Format à largeur variable : on ne code jamais « la colonne 3 » en dur, on découpe puis on raisonne sur ce qui reste — le programme survit alors aux fichiers réels.)
Construire un auto-contrôle de la chaîne de traitement : écrire controle(t) qui vérifie sur la série lue un faisceau de propriétés — , , , et si et seulement si toutes les valeurs sont égales — puis expliquer ce que chaque propriété attrape comme bogue plausible.
Démonstration (Solution)
def controle(t: list) -> None:
    """Auto-contrôle des statistiques. Précondition : t non vide."""
    mini, maxi = min(t), max(t)
    m, s, med = moyenne(t), ecart_type(t), mediane(t)
    assert mini <= med <= maxi, "médiane hors bornes"
    assert mini <= m <= maxi, "moyenne hors bornes"
    assert s >= 0, "écart-type négatif"
    constantes = all(x == t[0] for x in t)
    assert (s == 0) == constantes, "écart-type nul incohérent"
La forme assert condition, message (hors annexe du programme, fournie avec sa documentation) nomme la garde qui échoue. Ce que chaque garde attrape : une médiane hors bornes trahit un tri oublié ou un mauvais indice central ; une moyenne hors bornes signale presque toujours une erreur de lecture (une chaîne non convertie, un séparateur décimal « virgule » lu comme deux champs) ; un écart-type négatif est impossible en deux passages mais peut sortir de la formule en un passage par annulation catastrophique (exercice 5) — ce garde-fou détecte donc un problème numérique ; enfin l'équivalence série constante attrape les données dupliquées par une boucle de lecture défectueuse. (Ces propriétés sont des invariants mathématiques de la spécification, pas des choix d'implémentation : elles valent pour toute chaîne de traitement correcte, et leur coût — quelques parcours linéaires — est négligeable. Instrumenter ainsi un programme de données est la traduction concrète de la compétence « justifier et critiquer une solution ».)
- Modules :
import math(préfixe explicite, forme de référence), alias consacrés (plt),from ... import nomavec parcimonie, jamaisimport *; boîte noire lire la documentation (help) essayer en console —floor(-2.5),round(2.5)etrandint(bornes incluses !) réservent des surprises ; rien d'un module n'est exigible, son usage documenté l'est. - Aléatoire reproductible :
random.seed(...)fige les tirages — indispensable pour déboguer et tester ; simulation vérification expérimentale (Méré, Monte-Carlo, erreur en ). - Fichiers :
with open(...) as f; ligne à ligne,strip()d'abord ;split(sep)puis conversion explicite (float/int) — tant qu'on n'a pas converti,"9" > "10"; ignorer lignes vides et commentaires, compter ce qu'on rejette (NA, lignes mal formées). - Statistiques : moyenne, variance, écart-type, médiane (sur copie triée —
sortedrenvoie,.sort()mute) ; la médiane résiste aux valeurs aberrantes ; Kœnig-Huygens en un passage mais fragile numériquement (annulation catastrophique) ; accumulations par dictionnaire pour les moyennes par catégorie. - Graphiques : courbe (évolution), barres (catégories), histogramme (distribution — classes par division, ) ; axes nommés, titre, légende toujours ;
plt.show()ousavefig. - Méthode : décomposer lecture / calcul / tracé en fonctions testables séparément ; auto-contrôles par invariants mathématiques (, , constante) — la validation s'applique aux données comme aux algorithmes.
4.8 Exercices d'entraînement
Cette banque d'exercices, classée par thème, couvre l'intégralité du chapitre. La numérotation prolonge celle des dix exercices résolus. Légende : application directe, raisonnement intermédiaire, approfondissement ; le symbole signale un classique incontournable.
A. Modules et aléatoire
- () À l'aide de
helpou de la documentation, déterminer ce que fontmath.ceil,math.gcd,random.uniform(a, b),random.shuffle(t)— préconditions, type du résultat, mutation éventuelle de l'argument. - () Simuler lancers de deux dés et tracer l'histogramme de la somme : quelle valeur domine, et pourquoi ?
- ( ) Vérifier expérimentalement que
random.random()est uniforme : histogramme de tirages en classes, et écart maximal des effectifs à la valeur attendue . - () Le paradoxe des anniversaires : estimer par simulation la probabilité que, dans un groupe de personnes, deux au moins partagent un jour d'anniversaire (utiliser
a_un_doublondu chapitre 2) ; comparer à la valeur exacte . - () Écrire
melange(t)(mélange de Fisher-Yates : pour de à , échanger avec , uniforme dans ) sans utiliserrandom.shuffle, puis vérifier expérimentalement l'équiprobabilité des permutations de sur mélanges.
B. Fichiers
- () Écrire
ecrire_carres(n, nom_fichier)qui produit un fichier de lignesk;k*k, puisrelire_carresqui le relit et vérifie chaque ligne — un aller-retour complet. - () Compter le nombre de mots d'un fichier texte (séparateur : l'espace ; utiliser
split()sans argument et comparer son comportement àsplit(" ")sur les espaces multiples). - ( ) Le fichier contient des décimaux à la française (virgule :
12,5). Adapter la lecture (replace(",", ".")avant conversion) et discuter : pourquoi convertir au plus tôt plutôt que de garder des chaînes ? - () Fusionner deux fichiers de relevés
jour;valeuren un seul dictionnaire jour liste de valeurs, et signaler les jours présents dans un seul des deux fichiers. - () Écrire
tete(nom_fichier, k)qui affiche les premières lignes sans charger tout le fichier en mémoire, et expliquer pourquoif.readlines()[:k]ne respecte pas cette contrainte.
C. Statistiques
- () Écrire
etendue(t),quartiles(t)(premier quartile, médiane, troisième quartile sur la copie triée) et les tester sur . - () Sur la série , calculer moyenne et médiane, puis retirer la valeur aberrante et recommencer : chiffrer la sensibilité de chacune.
- ( ) Écrire
centre_reduit(t)qui renvoie la série transformée (précondition ), et vérifier par assertion que la série résultante a une moyenne et un écart-type — à tolérance, chapitre 1 oblige. - () Comparer
ecart_type(deux passages) etvariance_un_passagesur la série : laquelle donne la bonne variance () ? Conclure. - () La moyenne glissante de largeur : renvoyer la liste des moyennes de chaque fenêtre de valeurs consécutives, en (mettre à jour la somme en ajoutant l'entrant et retirant le sortant), puis tracer série brute et série lissée sur le même graphique.
D. Graphiques et études
- () Tracer sur une même figure , et pour (échelle ordinaire puis
plt.yscale("log")) : où l'exponentielle dépasse-t-elle le carré, et que devient chaque courbe en échelle logarithmique ? - ( ) Mesurer le temps d'exécution de la recherche séquentielle (chapitre 2) et de
tous_distincts(chapitre 3) pour à , tracer les deux courbes temps-taille en échelle log-log, et lire les pentes ( et ) : la complexité asymptotique devient une droite. - () Charger un fichier de notes par classe (
classe;note), tracer un histogramme par classe (deux appels àhistavec transparencealpha=0.6) et commenter ce que la moyenne seule aurait caché. - ( ) Étude complète : générer températures simulées ( uniforme dans ), écrire le fichier, le relire, calculer les statistiques mensuelles, tracer la série et la moyenne glissante sur jours, et vérifier par auto-contrôle (exercice résolu 10) chaque étape — la chaîne de traitement intégrale, de bout en bout.