Les tris
Cours complet · informatique (tronc commun des prépas scientifiques), chapitre 9 · prépas scientifiques, tronc commun
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
<i class="fa-solid fa-compass mr-2" style="color:#9A563B"></i>9.1 Introduction et motivation
Trier — ranger des données selon un ordre — est l'opération la plus étudiée de l'histoire de l'informatique, et pour cause : une donnée triée change de nature. La recherche y devient dichotomique (chapitre 5), les doublons s'y touchent, la médiane s'y lit (chapitre 4), la paire la plus proche y est voisine (chapitre 3) — trier d'abord est le premier réflexe de simplification d'une foule de problèmes.
Ce chapitre rassemble les grands algorithmes de tri et, surtout, leur zoologie : aux deux tris quadratiques fondamentaux — sélection et insertion — succèdent le tri par partition-fusion et le tri rapide, qui brisent le mur du pour atteindre , puis le tri par comptage qui, en trichant avec les comparaisons, descend à . Chaque algorithme se décrit par ses caractéristiques — stable ou non, en place ou non, comparatif ou non — qui décident de son emploi bien plus que sa seule complexité. Et le chapitre se ferme sur un théorème remarquable : n'est pas un exploit mais une frontière — aucun tri par comparaisons ne fera jamais mieux.
9.2 Le problème du tri
Trier le tableau , c'est produire un tableau tel que :
- est croissant : pour tout ;
- est une permutation de : mêmes éléments, avec les mêmes multiplicités.
Les deux clauses sont indispensables — le chapitre 3 a montré qu'oublier la seconde laisse passer des tris qui « perdent » des éléments.
- Un tri est en place s'il réordonne le tableau dans sa propre mémoire (quelques variables auxiliaires au plus), sans tableau annexe de taille comparable.
- Un tri est stable si deux éléments égaux (au sens de la clé de tri) restent dans leur ordre relatif initial — crucial pour trier des fiches : trier par note des élèves déjà rangés par nom conserve, à note égale, l'ordre alphabétique.
- Un tri est comparatif s'il n'accède aux éléments que par comparaisons () — sans regarder leur valeur. Tous les tris du chapitre le sont, sauf le dernier.
9.3 Le tri par sélection
À chaque étape, sélectionner le minimum de la partie non triée et le placer juste après la partie triée :
def tri_selection(t: list) -> None:
    """Trie t en place."""
    n = len(t)
    for i in range(n - 1):
        # Invariant : t[0..i-1] est trié et contient les i plus petits éléments
        imin = i
        for j in range(i + 1, n):
            if t[j] < t[imin]:
                imin = j
        t[i], t[imin] = t[imin], t[i]
Démonstration (Correction)
Invariant : « est trié et ses éléments sont inférieurs ou égaux à tous ceux de ». Initialisation : préfixe vide. Conservation : la boucle interne calcule l'indice du minimum de (invariant du chapitre 2) ; l'échange place ce minimum en position — il majore le préfixe (par ) et minore le reste : . À la sortie (), le préfixe est trié et minore : tout est trié, et l'on n'a fait qu'échanger des éléments de — permutation garantie.
Complexité : Tri par sélection
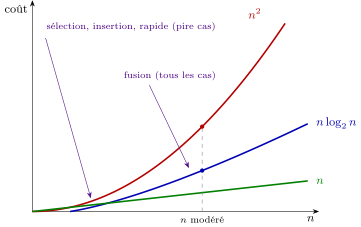
La boucle interne fait comparaisons : total , quel que soit le tableau — déjà trié ou non, la sélection ne voit rien. En revanche, au plus échanges : c'est le tri qui écrit le moins, précieux quand l'écriture coûte cher. Non stable dans cette version : l'échange peut faire sauter un élément par-dessus son égal.
9.4 Le tri par insertion
Le tri du joueur de cartes : prendre les éléments un à un et insérer chacun à sa place dans la partie déjà triée, en décalant les plus grands vers la droite :
def tri_insertion(t: list) -> None:
    """Trie t en place."""
    for i in range(1, len(t)):
        # Invariant : t[0..i-1] est trié (mêmes éléments qu'au départ)
        x = t[i]
        j = i
        while j > 0 and t[j - 1] > x:
            t[j] = t[j - 1]          # décaler vers la droite
            j -= 1
        t[j] = x                     # insérer x dans le trou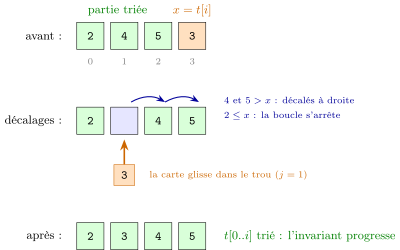
Démonstration (Correction)
Invariant externe : « est trié ». La boucle interne décale vers la droite les éléments du préfixe strictement supérieurs à — son propre invariant : « contient les éléments déplacés, tous , et n'a pas bougé » ; son variant : . À l'arrêt, soit , soit : poser en redonne un préfixe trié. Aucun élément n'est perdu : est sauvegardé avant les décalages et reposé — la permutation est préservée.
Complexité : Tri par insertion : la sensibilité au désordre
Le pire cas est le tableau strictement décroissant : chaque traverse tout le préfixe, comparaisons — . Mais le meilleur cas est le tableau déjà trié : la boucle interne échoue immédiatement, comparaisons — ! Plus finement, le nombre de décalages est exactement le nombre d'inversions du tableau (chapitre 3) : l'insertion est rapide sur les tableaux presque triés, ce qui en fait le tri de choix des petites entrées et des données quasi ordonnées. Stable (on n'insère qu'en passant strictement au-dessus : les égaux ne se croisent jamais), en place, comparatif.
9.5 Le tri par partition-fusion
9.5.1 Fusionner deux tableaux triés
Deux tableaux triés se combinent en un tableau trié en un seul parcours : comparer les têtes, prélever la plus petite, répéter :
def fusion(a: list, b: list) -> list:
    """Fusionne deux listes triées en une liste triée. Coût O(len(a) + len(b))."""
    r = []
    i, j = 0, 0
    while i < len(a) and j < len(b):
        # Invariant : r est trié, contient les éléments de a[0..i-1] et b[0..j-1],
        # et max(r) <= min des éléments restants
        if a[i] <= b[j]:                 # <= : la stabilité se joue ICI
            r.append(a[i]); i += 1
        else:
            r.append(b[j]); j += 1
    return r + a[i:] + b[j:]             # l'un des deux est épuisé : coller le reste
Coût : chaque comparaison place un élément, . Le <= (et non <) fait passer l'élément de gauche en premier en cas d'égalité : c'est lui qui rendra le tri stable.
9.5.2 L'algorithme
Couper en deux moitiés, trier chacune (récursivement), fusionner :
def tri_fusion(t: list) -> list:
    """Renvoie une nouvelle liste triée. Coût O(n log n)."""
    if len(t) <= 1:                      # cas de base : déjà trié
        return list(t)
    m = len(t) // 2
    return fusion(tri_fusion(t[:m]), tri_fusion(t[m:]))
C'est la stratégie diviser pour régner du chapitre 6 appliquée au tri — et le premier algorithme du cours à battre le mur quadratique.
Démonstration (Correction)
Récurrence forte sur (chapitre 6). Base : une liste de taille est triée. Hérédité : les deux appels portent sur des listes strictement plus courtes (pour , : variant) ; par hypothèse ils renvoient des permutations triées des deux moitiés ; la fusion de deux listes triées est triée et contient exactement leurs éléments — le résultat est une permutation triée de .
Complexité : Tri fusion : le compte de l'arbre
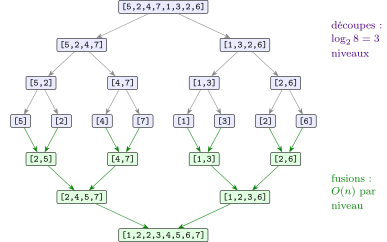
Notons le coût. La découpe et la fusion coûtent , d'où . L'image qui résout cette récurrence : l'arbre des appels. Au niveau , une liste de taille ; au niveau , deux de taille ; au niveau , listes de taille — chaque niveau totalise un travail de fusion en , et il y a niveaux avant d'atteindre les listes singletons :
dans tous les cas — meilleur, pire, moyen : la découpe en moitiés ne dépend pas des valeurs. Pour fixer les idées : donne opérations (un clin d'œil), là où les tris quadratiques en demandaient (des heures). En revanche, la fusion exige des listes auxiliaires : le tri fusion n'est pas en place ( de mémoire annexe). Stable (grâce au <=), comparatif.
9.6 Le tri rapide
Choisir un élément pivot, partager les autres en « plus petits » et « plus grands », trier les deux camps récursivement — le travail se fait au partage, et il n'y a rien à fusionner :
def tri_rapide(t: list) -> list:
    """Renvoie une nouvelle liste triée."""
    if len(t) <= 1:
        return list(t)
    pivot = t[0]
    petits = [x for x in t[1:] if x < pivot]
    grands = [x for x in t[1:] if x >= pivot]
    return tri_rapide(petits) + [pivot] + tri_rapide(grands)
(La version historique partitionne en place par échanges — plus économe en mémoire, même idée ; notre version par compréhensions privilégie la clarté du raisonnement.)
Complexité : Tri rapide : la loterie du pivot
Tout dépend de l'équilibre du partage. Si le pivot tombe vers le milieu, les deux camps ont taille : même arbre que le tri fusion, — et en pratique, sur données quelconques, le tri rapide est le plus véloce des tris comparatifs (d'où son nom). Mais si le pivot est extrême, le partage donne contre : l'« arbre » dégénère en chemin de profondeur , et le coût total . Or notre pivot est : le pire cas est le tableau… déjà trié (ou trié à l'envers) — l'entrée la plus banale qui soit ! Les implémentations sérieuses tirent le pivot au hasard ou prennent une médiane de trois, rendant le pire cas improbable sans l'éliminer. Retenir l'énoncé exact : tri rapide en moyenne et en pratique, dans le cas le pire — c'est l'exemple canonique de l'écart entre les deux mesures. Non stable (le partage réordonne les égaux), version du cours non en place.
Tri fusion et tri rapide sont jumeaux inversés : la fusion travaille en remontant (combiner deux résultats triés), le rapide en descendant (partager avant de déléguer). Le premier offre une garantie inconditionnelle, le second une vitesse pratique : le tri natif de Python (sorted, Timsort) est un descendant du tri fusion, précisément pour la garantie et la stabilité.
9.7 Le tri par comptage
Quand les éléments sont des entiers d'un intervalle borné , on peut trier sans comparer : compter les occurrences de chaque valeur (chapitre 2 !), puis réécrire le tableau dans l'ordre des valeurs :
def tri_comptage(t: list, k: int) -> list:
    """Trie t dont les éléments sont des entiers de [0, k-1]. Coût O(n + k)."""
    effectifs = [0] * k
    for x in t:
        effectifs[x] += 1
    r = []
    for v in range(k):
        r.extend([v] * effectifs[v])     # v répété autant de fois que compté
    return r

assert tri_comptage([3, 1, 3, 0, 1], 4) == [0, 1, 1, 3, 3]
Complexité : Tri par comptage
Un parcours de () puis un parcours des valeurs en produisant éléments () : total — linéaire si . Trier un million de notes sur : deux parcours, aucune comparaison. La contrainte est tout aussi claire : il faut des clés entières dans un intervalle petit et connu — pour (des identifiants quelconques), le tableau d'effectifs est impossible. Non comparatif — c'est ainsi qu'il échappe à la borne de la section suivante ; la variante par positions cumulées (exercice 9) le rend stable, ce qui en fait la brique du tri par base.
9.8 La borne des tris comparatifs
Tout algorithme de tri par comparaisons effectue, dans le cas le pire, au moins comparaisons, quantité de l'ordre de . Le tri fusion est donc asymptotiquement optimal.
Démonstration
C'est l'argument de la dichotomie (chapitre 5, exercice 9), à plus grande échelle. Un tri par comparaisons doit distinguer les ordres initiaux possibles : deux permutations différentes de l'entrée exigent des suites de mouvements différentes, donc des suites de réponses aux comparaisons différentes. Après comparaisons (chacune binaire), l'algorithme ne distingue qu'au plus scénarios : il faut , soit . Or
(en minorant les derniers termes par ) : c'est bien de l'ordre de . (La frontière est donc dans le problème, pas dans nos algorithmes — comme les déplacements de Hanoï. Et l'évasion du tri par comptage s'explique : en lisant la valeur des éléments, il obtient bien plus qu'un bit par opération.)
Méthode : Choisir son tri
| Tri | Pire cas | Particularité | Stable | En place | Comparatif |
|---|---|---|---|---|---|
| Sélection | échanges | non | oui | oui | |
| Insertion | si presque trié | oui | oui | oui | |
| Bulles (ch. 3) | arrêt anticipé | oui | oui | oui | |
| Fusion | garanti, tous les cas | oui | non | oui | |
| Rapide | en pratique | non | possible | oui | |
| Comptage | clés entières bornées | oui* | non | non |
{ (version par positions cumulées.)} En pratique : sorted/.sort() (stables, garantis) pour tout usage courant ; insertion pour les petites entrées ou presque triées ; comptage quand les clés s'y prêtent. Savoir écrire et prouver* les six reste l'exigible.
<i class="fa-solid fa-dumbbell mr-2" style="color:#2E7559"></i>9.9 Exercices résolus
Niveau (Application directe du cours)
Dérouler le tri par sélection puis le tri par insertion sur : état du tableau après chaque étape externe, nombre de comparaisons de chacun.
Démonstration (Solution)
Sélection : : minimum de en position , échange ( comparaisons). : minimum de déjà en place inchangé ( comp.). : minimum de en position , échange ( comp.). Total : comparaisons, échanges effectifs.
Insertion : : insérer dans ( comp.). : insérer dans — reste en place ( comp.). : insérer dans — traverse tout ( comp.). Total : comparaisons.
Sur ce petit exemple l'insertion gagne d'une comparaison — et l'écart se creuse sur les tableaux presque triés, où la sélection s'obstine à ses . (Le déroulé manuel, vérification d'invariant comprise — le préfixe trié grandit bien d'un cran par étape — reste le premier test de tout tri.)
Dérouler fusion([1, 4, 7], [2, 3, 9]) : à chaque tour, les indices , la comparaison faite et l'état de r. Combien de comparaisons — et quel est le pire cas du nombre de comparaisons d'une fusion de deux listes de tailles et ?
Démonstration (Solution)
: , ; : , ; : , ; : , ; : , ; : la liste est épuisée, on colle — résultat , comparaisons. En général : chaque comparaison place exactement un élément, et la dernière place l'avant-dernier au pire — soit au plus comparaisons, atteint quand les deux listes s'entrelacent jusqu'au bout (comme ici : ). (Et au mieux , atteint quand la liste la plus courte précède entièrement l'autre : la boucle s'arrête dès l'épuisement de la première.)
On trie par note les fiches . Donner le résultat d'un tri stable ; montrer que tri_selection (adapté aux couples, comparaison sur la note) ne l'est pas, en exhibant le moment fautif.
Démonstration (Solution)
Tri stable attendu : — Alice avant Chloé, comme au départ.
Sélection sur les notes : à , le minimum () est déjà en position — pas d'échange. À : le minimum de est Chloé, échange avec Bob . Ici, par chance, le résultat est stable ! Le contre-exemple demande que l'échange enjambe un égal : prenons . À , le minimum est Alice : échange avec Bob — non : ? L'échange envoie Bob en position … où il était déjà relativement à Chloé. Troisième essai, l'exemple canonique : . À : minimum Alice (position ), échange avec Bob — Bob est passé derrière Chloé : les deux ont été inversés, et plus rien ne les remettra dans l'ordre. Le tri par sélection n'est pas stable, et le mécanisme est identifié : le grand échange à longue distance enjambe les égaux. (Chercher un contre-exemple est une compétence en soi : les deux premières tentatives échouent et c'est instructif — il faut que l'élément échangé saute par-dessus son égal, d'où la configuration minimale à trois fiches.)
Niveau (Application avec raisonnement intermédiaire)
Pour : dessiner (ou décrire) l'arbre des appels de tri_fusion, donner le nombre de niveaux, le travail par niveau, le total — puis vérifier expérimentalement la croissance en en chronométrant .
Démonstration (Solution)
L'arbre : une liste de , deux de , quatre de , huit de , seize de — niveaux de découpe, et les fusions remontent : huit fusions de tailles , quatre de , deux de , une de . Chaque niveau fusionne éléments au total : travail par niveau, niveaux, placements (et au plus comparaisons). Le chronométrage typique donne des temps quasi proportionnels à à un facteur logarithmique près : de à , est multiplié par et le temps par — le facteur supplémentaire est le rapport atténué par les constantes. (L'arbre est la bonne image mentale : « combien de niveaux, combien par niveau » résout toutes les récurrences de ce cours sans aucune machinerie.)
Montrer que sur un tableau déjà trié de taille , tri_rapide (pivot ) effectue comparaisons. Que donne le tableau trié décroissant ? Et pourquoi le pivot au hasard échappe-t-il à la malédiction en pratique sans y échapper en théorie ?
Démonstration (Solution)
Sur : le pivot donne et ( comparaisons) ; l'appel récursif sur les grands recommence avec le pivot , etc. — total : l'arbre est un chemin, le tri est quadratique sur l'entrée la plus courante du monde réel (les données déjà triées ou presque). Le tableau décroissant donne le symétrique exact () : même compte. Avec un pivot uniforme au hasard, chaque exécution a une petite probabilité de mal tomber partout — l'espérance du coût est (admis), et la probabilité d'un comportement quadratique devient infinitésimale ; mais pour toute stratégie de pivot, il existe une entrée défavorable (au hasard près) : le pire cas théorique reste . (D'où la formulation soignée du cours : « en moyenne et en pratique, au pire » — les deux moitiés de la phrase sont vraies ensemble, et confondre les deux mesures est l'erreur classique sur le tri rapide.)
On veut trier des fiches par note décroissante, et à note égale par ordre alphabétique. Le réaliser de deux façons : avec sorted et une clé bien choisie ; puis en exploitant la stabilité par deux tris successifs. Vérifier l'équivalence.
Démonstration (Solution)
fiches = [("Bob", 15), ("Alice", 12), ("Chloe", 15), ("Dan", 12)]

# 1. une seule clé composite : note décroissante = -note croissante
r1 = sorted(fiches, key=lambda f: (-f[1], f[0]))

# 2. deux tris STABLES successifs : critère secondaire D'ABORD
r2 = sorted(fiches)                                    # alphabétique
r2 = sorted(r2, key=lambda f: f[1], reverse=True)      # puis par note

assert r1 == r2 == [("Bob", 15), ("Chloe", 15), ("Alice", 12), ("Dan", 12)]
La méthode 2 repose entièrement sur la stabilité de sorted : le second tri, en regroupant les notes égales, conserve l'ordre alphabétique établi par le premier. L'ordre des deux tris est contre-intuitif — le critère secondaire d'abord, le principal ensuite — et c'est le pattern historique du tri de fichiers multi-critères (et du tri par base de l'exercice 9). (Avec un tri non stable, la méthode 2 s'effondre silencieusement : la stabilité n'est pas une coquetterie de théoricien, c'est une fonctionnalité.)
Écrire le banc qui valide les six tris du cours (bulles compris) par tests de propriété (chapitre 3 : croissance et permutation, copie préalable pour les tris en place), puis qui mesure leurs temps sur trois profils d'entrée — aléatoire, déjà triée, triée à l'envers — pour . Commenter le tableau obtenu.
Démonstration (Solution)
import random, time

def valide(tri_renvoie, essais=500):
    random.seed(9)
    for _ in range(essais):
        t = [random.randint(0, 50) for _ in range(random.randint(0, 40))]
        copie = list(t)
        r = tri_renvoie(t)
        assert all(r[i] <= r[i+1] for i in range(len(r) - 1))
        assert sorted(copie) == r and t == copie     # permutation, source intacte

def chrono(tri_renvoie, t):
    debut = time.perf_counter()
    tri_renvoie(list(t))
    return time.perf_counter() - debut

n = 2000
profils = {"aleatoire": [random.randint(0, 10**6) for _ in range(n)],
           "triee":     list(range(n)),
           "inverse":   list(range(n, 0, -1))}
Résultats typiques (ordres de grandeur, machine ordinaire) :
| aléatoire | déjà triée | inverse | |
|---|---|---|---|
| sélection | lent | lent | lent — aveugle au désordre |
| insertion | lent | instantané | le pire de tous |
| bulles (drapeau) | lent | instantané | lent |
| fusion | rapide | rapide | rapide — imperturbable |
| rapide (pivot ) | rapide | lent ! | lent ! |
| comptage (si clés petites) | le plus rapide | idem | idem |
Le tableau est le cours : l'insertion et les bulles voient le tri préexistant, la sélection non ; la fusion garantit ; le rapide naïf s'effondre précisément sur les entrées ordonnées (exercice 5) ; le comptage, hors catégorie, ne compare pas. (Un banc unique, six algorithmes, trois profils : c'est la « caractérisation expérimentale » que demande le programme — et chaque case surprenante du tableau a son théorème au chapitre.)
Niveau (Raisonnement subtil ou plusieurs étapes)
Le chapitre 3 comptait les inversions en . Montrer comment le tri fusion, légèrement instrumenté, les compte en : lors d'une fusion, chaque prélèvement à droite révèle d'un coup toutes les inversions avec le reste de la gauche.
Démonstration (Solution)
def tri_et_inversions(t: list) -> tuple:
    """Renvoie (liste triée, nombre d'inversions de t)."""
    if len(t) <= 1:
        return (list(t), 0)
    m = len(t) // 2
    a, inv_a = tri_et_inversions(t[:m])
    b, inv_b = tri_et_inversions(t[m:])
    r, i, j, inv = [], 0, 0, inv_a + inv_b
    while i < len(a) and j < len(b):
        if a[i] <= b[j]:
            r.append(a[i]); i += 1
        else:
            r.append(b[j]); j += 1
            inv += len(a) - i        # b[j] est plus petit que TOUT le reste de a
    return (r + a[i:] + b[j:], inv)

assert tri_et_inversions([2, 4, 1, 3])[1] == 3     # (2,1), (4,1), (4,3)
Justification : toute inversion de ( avant , ) est comptée exactement une fois — soit ses deux membres tombent dans la même moitié (comptée récursivement dans inv_a ou inv_b), soit est à gauche et à droite, et elle est comptée au moment précis où est prélevé avant les éléments restants de (tous , et tous avant dans ) : le terme len(a) - i. Le surcoût par fusion est par prélèvement : le coût total reste . Pour éléments, le compte passe de opérations (chapitre 3) à . (Greffer un calcul sur un algorithme existant en exploitant son invariant — « et sont triés, et tout précède tout dans l'original » — est un geste de conception majeur : l'algorithme devient un échafaudage réutilisable.)
La version du cours reconstruit les valeurs : elle convient aux entiers nus, pas aux fiches. Écrire la version stable par positions cumulées (chaque fiche est recopiée à sa place calculée), puis l'utiliser pour trier des entiers de trois chiffres par passes successives sur le chiffre des unités, puis des dizaines, puis des centaines — le tri par base. Pourquoi la stabilité est-elle la clé de voûte ?
Démonstration (Solution)
def tri_comptage_stable(fiches: list, cle, k: int) -> list:
    """Trie les fiches selon cle(f) dans [0, k-1], en respectant l'ordre initial
    des égaux. Coût O(n + k)."""
    effectifs = [0] * k
    for f in fiches:
        effectifs[cle(f)] += 1
    debut = [0] * k                      # position de départ de chaque valeur
    for v in range(1, k):
        debut[v] = debut[v - 1] + effectifs[v - 1]
    r = [None] * len(fiches)
    for f in fiches:                     # parcours DANS L'ORDRE INITIAL
        r[debut[cle(f)]] = f
        debut[cle(f)] += 1
    return r

def tri_par_base(t: list) -> list:
    """Trie des entiers de [0, 999] par trois passes de comptage stable."""
    r = tri_comptage_stable(t, lambda x: x % 10, 10)          # unités
    r = tri_comptage_stable(r, lambda x: (x // 10) % 10, 10)  # dizaines
    return tri_comptage_stable(r, lambda x: x // 100, 10)     # centaines

assert tri_par_base([329, 457, 657, 839, 436, 720, 355]) \
       == [329, 355, 436, 457, 657, 720, 839]
La stabilité porte tout l'édifice : après la passe des dizaines, deux nombres de même chiffre des dizaines restent rangés par unités (la passe précédente) — par récurrence, après la passe , le tableau est trié selon les derniers chiffres. Avec une passe instable, l'information des passes antérieures serait détruite et le résultat faux (tester en remplaçant par la version non stable du cours : le banc de l'exercice 7 le détecte aussitôt). Coût : passes en pour des nombres à chiffres — , linéaire à fixé : c'est ainsi que les cartes perforées furent triées un siècle durant. (Le critère secondaire d'abord, le principal en dernier : exactement le pattern des fiches de l'exercice 6, industrialisé.)
Montrer l'encadrement , en déduire que tout tri par comparaisons de éléments exige au moins comparaisons environ, et comparer au tri fusion réel sur . La borne est-elle « serrée » ?
Démonstration (Solution)
Majoration : , d'où . Minoration : les facteurs supérieurs valent chacun au moins , donc et . (L'encadrement exact, , est la formule de Stirling du cours de mathématiques — notre version élémentaire suffit à l'asymptotique.)
Pour : (calcul direct : sum(math.log2(i) for i in range(2, 101)) donne ). Toute stratégie de tri par comparaisons admet donc une entrée à comparaisons. Le tri fusion sur en effectue au plus — soit moins de au-dessus de la borne absolue : la borne est remarquablement serrée, et le tri fusion remarquablement proche de l'optimal, pas seulement en ordre de grandeur mais presque en constante. (Une borne inférieure qui colle à un algorithme réel à près : le problème du tri est, à ce titre, l'un des mieux compris de l'informatique — et la marge restante a nourri cinquante ans de raffinements, dont le Timsort de Python.)
- Spécification : permutation (mêmes éléments !) croissante ; caractéristiques : en place (mémoire), stable (les égaux gardent leur ordre — indispensable aux fiches et aux tris successifs : secondaire d'abord), comparatif (n'accède que par ).
- Sélection : minimum du reste, échangé ; comparaisons toujours, mais échanges ; non stable (le grand échange enjambe les égaux). Insertion : décaler puis poser ; pire cas , meilleur cas — coût nombre d'inversions : le tri des entrées presque triées ; stable, en place.
- Fusion : couper, trier, fusionner ( pour la stabilité ; comparaisons au pire) ; l'arbre : par niveau niveaux garanti ; pas en place ; instrumentable (inversions en ).
- Rapide : pivot, partition, récursion ; en moyenne/pratique mais au pire — atteint sur les entrées déjà triées avec pivot ; pivot aléatoire : pire cas improbable, pas impossible.
- Comptage : clés entières de , , non comparatif ; version cumulative stable tri par base (passes du chiffre faible au fort, la stabilité porte la récurrence).
- Borne inférieure : ordres à distinguer, suites de réponses — la frontière est dans le problème ; le tri fusion la frôle à ; seul l'abandon des comparaisons (comptage) y échappe.
- En pratique :
sorted/.sort()(stables, , clé parkey=...) ; le banc trois-profils (aléatoire / trié / inverse) caractérise expérimentalement tout tri.
9.10 Exercices d'entraînement
Cette banque d'exercices, classée par thème, couvre l'intégralité du chapitre. La numérotation prolonge celle des dix exercices résolus. Légende : application directe, raisonnement intermédiaire, approfondissement ; le symbole signale un classique incontournable.
A. Tris quadratiques
- () Dérouler sélection et insertion sur — avec un doublon : suivre les deux à la trace et conclure sur la stabilité de chacun.
- () Compter exactement, pour chaque tri quadratique, comparaisons et écritures sur le tableau trié et sur son renversé.
- ( ) Prouver l'invariant externe du tri par insertion (rédaction complète : initialisation, conservation avec l'invariant interne de décalage, conclusion).
- () Le tri par insertion dichotomique : chercher la place de par dichotomie (chapitre 5) au lieu du balayage. Combien de comparaisons () ? Pourquoi le coût total reste-t-il (les décalages !) — et que dit cette nuance sur « compter les comparaisons » contre « compter tout » ?
- () Trouver le tableau de taille qui maximise le nombre total d'écritures du tri par insertion, et celui qui maximise les échanges de la sélection — sont-ce les mêmes ?
B. Fusion et rapide
- () Écrire
fusionen place dans un tableau résultat préalloué ([None] * (a + b)) et vérifier l'égalité avec la version du cours. - () Dérouler l'arbre complet de
tri_fusion([5, 2, 4, 7, 1, 3, 2, 6]): toutes les découpes, toutes les fusions. - ( ) Prouver par récurrence que le nombre de comparaisons du tri fusion vérifie .
- () Le tri fusion ascendant (sans récursion) : fusionner les paires, puis les quadruplets, etc. L'implémenter et vérifier le même coût — la récursivité était une commodité, pas une nécessité.
- () Instrumenter
tri_rapidepour mesurer la profondeur de récursion sur entrée aléatoire, triée, inverse () ; relier aux coûts observés et au danger deRecursionError. - ( ) Implémenter le tri rapide en place (partition de Lomuto : un indice frontière, échanges) avec son invariant « », et le valider au banc de l'exercice 7.
C. Comptage et tris non comparatifs
- () Trier un million de dés ( à ) par comptage ; chronométrer contre
sortedet expliquer l'écart. - () Adapter le tri par comptage aux entiers de quelconques (décalage d'indice), avec validation des préconditions.
- () L'histogramme du chapitre 4 et le tri par comptage sont le même algorithme à la dernière étape près — expliciter le lien, et écrire la médiane d'un tableau de notes en sans tri général.
- ( ) Trier dates (jour, mois) par base : deux passes stables (jour puis mois) ; vérifier contre
sortedet montrer qu'inverser l'ordre des passes est faux. - () Pourquoi ne peut-on pas trier des flottants quelconques par comptage ? Discuter ce qui tient lieu de , et ce qu'on peut sauver (tri par paquets sur uniforme — esquisse).
D. Études et démonstrations
- () Vérifier expérimentalement la stabilité de
sorted: fiches (clé aléatoire sur valeurs, numéro d'ordre), trier par clé, contrôler que les numéros restent croissants dans chaque groupe. - ( ) Quel tri choisir — et pourquoi, en trois lignes chacun — pour : entiers entre et ; un fichier de fiches presque trié après une insertion ; des données arrivant en flux à trier par paquets de ; un tableau immense quand la mémoire est comptée ?
- () Montrer qu'un tri stable et un tri quelconque appliqués à un tableau sans doublon donnent toujours le même résultat — la stabilité ne se voit que sur les égaux.
- () Le drapeau hollandais : trier en place un tableau de valeurs dans en un seul parcours avec trois zones et deux frontières — invariant à trois segments, variant, preuve (le problème de Dijkstra, généralisation du drapeau du chapitre 1).
- ( ) Rédiger l'étude de synthèse du semestre : pour le problème « trouver les plus grands éléments parmi », comparer quatre stratégies (tri complet ; sélection partielle passes ; un parcours avec liste des meilleurs maintenue par insertion ; comptage si les clés s'y prêtent) — coûts, mesures, choix final argumenté, au format des six compétences du programme.