Flottants, booléens et textes
Cours complet · NSI (première), chapitre 2 · première, spécialité numérique et sciences informatiques
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Le chapitre précédent a codé les entiers, et il l'a fait exactement : chaque entier représentable a une écriture binaire, et une seule. Ce chapitre traite les trois autres types de base — les nombres à virgule, les valeurs de vérité, les caractères — et le premier d'entre eux impose d'abandonner l'exactitude. C'est le fait le plus déroutant de tout le programme de première, et le plus utile : une machine ne calcule pas sur les réels, elle calcule sur des approximations de réels, et il faut le savoir avant d'écrire une comparaison.
2.1 Les nombres à virgule
2.1.1 La virgule en base deux
Le principe de l'écriture positionnelle ne s'arrête pas à la virgule. En base dix, les rangs après la virgule pèsent , , ; en base deux, ils pèsent , , , et ainsi de suite.
Un réel de s'écrit en base deux
Pour obtenir les chiffres, on inverse le procédé du chapitre 1 : au lieu de diviser par deux et de garder les restes, on multiplie par deux et on garde les parties entières.
Capacité attendue
« Calculer sur quelques exemples la représentation de nombres réels : 0.1, 0.25 ou 1/3. »
. , partie entière ; , partie entière , reste . On s'arrête. Donc , exactement.
. ; , reste . On retrouve : le motif se répète indéfiniment. Donc , périodique de période 01.
. Déroulons :
| Reste | Bit produit | |
|---|---|---|
| (reste ) | ||
| (reste ) | ||
| déjà vu : le cycle recommence |
Donc , périodique de période 0011. Ce développement est infini.
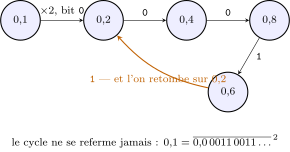
parties entières. On retombe sur : le motif 0011 se répète indéfiniment, et aucune machine à mémoire finie ne peut le stocker exactement.</div>
est un nombre parfaitement banal en base dix — et il n'a pas d'écriture binaire finie. Une machine qui ne dispose que d'un nombre fini de bits ne peut donc pas le stocker exactement. Elle stocke le nombre représentable le plus proche. Tout part de là.
Le phénomène n'a rien de mystérieux : la base dix connaît le même. s'écrit , sans fin. Un réel a une écriture finie en base si et seulement si son dénominateur (fraction réduite) ne contient que des facteurs premiers de . En base dix, : les dixièmes, les quarts, les cinquièmes passent. En base deux, seuls les dénominateurs puissances de deux passent — et contient un .
2.1.2 Ce qu'est un nombre flottant
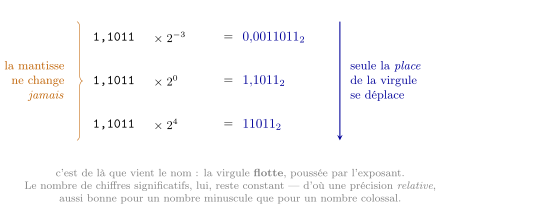
Un nombre flottant est un nombre représenté sous la forme
où la mantisse est écrite sur un nombre fixé de bits et l'exposant est un entier relatif, lui aussi écrit sur un nombre fixé de bits.
Le nom vient de là : la virgule ne reste pas à une place fixe, elle « flotte » — c'est l'exposant qui la déplace. Le procédé est celui de la notation scientifique , transposé en base deux. Il permet de représenter aussi bien des nombres minuscules que colossaux avec le même nombre de bits, au prix d'une précision relative : un flottant garde un nombre à peu près constant de chiffres significatifs, quel que soit son ordre de grandeur.
Un dessin vaut mieux qu'une phrase pour cette histoire de virgule mobile :
Hors programme : Ce que le programme n'exige pas
La norme qui régit ces nombres s'appelle IEEE-754, et le programme est explicite : « aucune connaissance précise de la norme IEEE-754 n'est exigible ». Retenez seulement l'ordre de grandeur utile : les flottants de Python occupent 64 bits, dont 53 pour la mantisse, ce qui correspond à environ 15 à 16 chiffres décimaux significatifs. Le détail du découpage, les valeurs spéciales, les modes d'arrondi : hors programme.
2.1.3 La conséquence :
>>> 0.1 + 0.2
0.30000000000000004
>>> 0.1 + 0.2 == 0.3
False
Ce n'est pas un défaut de Python : tout langage utilisant les flottants du processeur donne le même résultat. L'explication tient en une phrase : ni ni ne sont stockés exactement, leur somme approchée n'est pas le flottant le plus proche de , et les deux valeurs diffèrent d'un poil — ici, environ .
On peut regarder ce que la machine stocke vraiment. Python sait afficher la valeur décimale exacte du flottant qu'il a retenu pour :
>>> from decimal import Decimal
>>> Decimal(0.1)
Decimal('0.1000000000000000055511151231257827021181583404541015625')
Ce nombre-là, lui, est exact : c'est le flottant le plus proche de . Il n'est simplement pas .
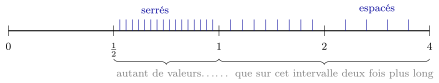
consécutives, on en trouve toujours le même nombre. La précision est donc relative — d'où l'inutilité d'une tolérance absolue quand on compare de très grands ou de très petits nombres.</div>
Le programme la formule ainsi : « il faut éviter de tester l'égalité de deux flottants ». On ne compare pas deux flottants avec ==. On teste si leur écart est suffisamment petit.
Méthode : Comparer deux flottants
Plutôt que x == y, on écrit :
def presque_egaux(x, y, eps=1e-9):
    """Vrai si x et y sont indiscernables à la tolérance relative eps près.

    La tolérance est mise à l'échelle des valeurs comparées : un écart de 1e-9
    est énorme sur des nombres proches de 1e-12, et négligeable sur des
    nombres proches de 1e12.
    """
    return abs(x - y) <= eps * max(1.0, abs(x), abs(y))
La bibliothèque standard fournit la même idée sous le nom math.isclose(x, y). Utilisez-la : elle est écrite, testée et documentée.
Le piège classique n'est pas la comparaison isolée, c'est la boucle :
x = 0.0
while x != 1.0:      # NE JAMAIS ÉCRIRE CELA
x = x + 0.1 n'étant pas exact, les additions successives ne tombent jamais exactement sur : la boucle ne s'arrête pas. Il faut compter en entiers — for i in range(10) puis x = i / 10 — ou comparer avec x < 1.0.
2.2 Les booléens
2.2.1 Deux valeurs, trois opérateurs
Une valeur booléenne est l'une des deux valeurs de vérité, notées et (ou faux et vrai ; en Python False et True). Les trois opérateurs de base sont la conjonction and, la disjonction or et la négation not, définis par les tables suivantes.
Plutôt que d'apprendre trois tables de vérité, il vaut mieux en retenir la forme :
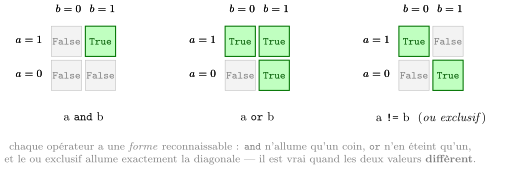
| `and` | `or` | `not` | ||
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 1 |
| 0 | 1 | 0 | 1 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 1 | 1 | 1 | 0 |
Repère historique : Boole 1854, Shannon 1937
En 1854, le mathématicien anglais George Boole publie An Investigation of the Laws of Thought, où il traite le raisonnement logique comme un calcul algébrique sur deux valeurs. Le travail reste longtemps une curiosité de logicien.
Il faut attendre 1937 pour qu'un étudiant du MIT, Claude Shannon, fasse le rapprochement décisif dans son mémoire de master : les circuits de relais — un interrupteur est ouvert ou fermé — se décrivent exactement par l'algèbre de Boole. Publié l'année suivante, ce mémoire fonde la conception logique des machines à calculer. C'est précisément ce que dit le programme quand il écrit que le bit « permet d'unifier logique et calcul » : les mêmes deux valeurs servent à raisonner et à compter.
2.2.2 Dresser la table d'une expression
Capacité attendue
« Dresser la table d'une expression booléenne. »
Méthode : Table de vérité d'une expression
Pour une expression à variables :
- écrire les lignes des combinaisons possibles, dans l'ordre du comptage binaire — cela garantit qu'on n'en oublie aucune ;
- ajouter une colonne par sous-expression intermédiaire, de la plus interne à la plus externe ;
- remplir colonne par colonne, jamais ligne par ligne : on applique une seule règle à la fois.
Dressons la table de not ( and ) et de (not ) or (not ).
| `not` | `not` | `not` | ||||
|---|---|---|---|---|---|---|
| 0 | 0 | 0 | 1 | 1 | 1 | 1 |
| 0 | 1 | 0 | 1 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 | 0 | 1 | 1 |
| 1 | 1 | 1 | 0 | 0 | 0 | 0 |
Les deux dernières colonnes coïncident sur les quatre lignes : les expressions sont équivalentes. Deux expressions ayant la même table sont interchangeables — c'est ainsi qu'on simplifie une condition trop lourde.
2.2.3 Le ou exclusif
Le ou exclusif, noté xor ou , vaut lorsque exactement une des deux valeurs vaut :
C'est le « ou » du langage courant quand on dit « fromage ou dessert » : pas les deux. Le or de la logique, lui, est inclusif. Python n'a pas de mot-clé xor pour les booléens ; on écrit a != b, qui donne exactement la même table.
2.2.4 Application : additionner en binaire
Les opérateurs booléens ne servent pas qu'à décider : ils calculent. Reprenons l'addition binaire de deux bits et :
Le bit de somme vaut et le bit de retenue vaut .
Démonstration
Sur les quatre cas : la somme vaut exactement quand un seul des deux bits vaut , ce qui est la table de ; la retenue vaut exactement dans le cas , ce qui est la table de and.
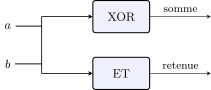
pas une métaphore — c'est le schéma d'un circuit réel, présent dans le processeur.</div>
Pour additionner des nombres de plusieurs bits, il faut aussi tenir compte de la retenue entrante du rang précédent. On obtient l'additionneur complet :
def additionneur_complet(a, b, r):
    """Somme et retenue sortante de trois bits. Renvoie le couple (s, r')."""
    s = a ^ b ^ r
    r_sortante = (a & b) | (r & (a ^ b))
    return s, r_sortante


def addition_binaire(u, v):
    """Somme de deux chaînes de bits de même longueur, sans retenue entrante.

    Renvoie (somme, retenue_finale). La somme a la même longueur que u et v ;
    la retenue finale signale un débordement, comme au chapitre 1.
    """
    assert len(u) == len(v), "les deux operandes doivent avoir la meme longueur"
    r = 0
    resultat = ""
    for i in range(len(u) - 1, -1, -1):
        s, r = additionneur_complet(int(u[i]), int(v[i]), r)
        resultat = str(s) + resultat
return resultat, rLes opérateurs ^, & et | de Python agissent bit à bit sur les entiers ; sur les valeurs et ils se confondent avec xor, and et or. C'est bien un circuit qu'on vient d'écrire : les processeurs additionnent ainsi, en enchaînant des additionneurs complets.
2.2.5 Le caractère séquentiel des opérateurs
Les opérateurs and et or de Python ne sont pas symétriques à l'exécution : ils évaluent l'opérande de gauche d'abord, et s'arrêtent dès que le résultat est connu. C'est ce qu'on appelle l'évaluation en court-circuit.
Si est faux, est faux quel que soit : Python n'évalue même pas . Symétriquement, si est vrai, est vrai sans regarder . La table de vérité ne le dit pas — elle décrit un résultat, pas un ordre — et pourtant cela change tout :
if x != 0 and 10 / x > 1:      # sûr : si x vaut 0, la division n'est pas évaluée
    ...

if 10 / x > 1 and x != 0:      # plante quand x vaut 0
    ...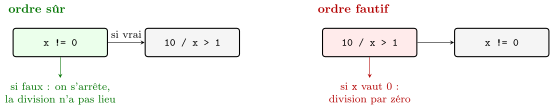
c'est l'évaluation de gauche à droite qui fait que l'une protège et l'autre non.</div>
Les deux conditions ont la même table de vérité ; l'une fonctionne, l'autre lève une erreur. Retenez le procédé : placer à gauche le test qui protège celui de droite.
2.3 Les textes
2.3.1 Un caractère est un nombre
Une machine ne stocke pas de lettres. Elle stocke des entiers, et une convention dit quel entier désigne quelle lettre. Cette convention s'appelle un encodage.
Capacité attendue
« Identifier l'intérêt des différents systèmes d'encodage. »
2.3.2 Trois encodages, trois époques
ASCII (1963), sur 7 bits.
128 codes, suffisants pour l'alphabet latin non accentué, les chiffres, la ponctuation et quelques caractères de commande. Les majuscules occupent les codes 65 à 90, les minuscules 97 à 122 — soit exactement 32 de plus, ce qui n'est pas un hasard : , et passer d'une casse à l'autre revient à basculer un seul bit. Aucun caractère accentué : ASCII a été conçu pour l'anglais.
ISO-8859-1, dite latin-1, sur 8 bits.
256 codes : les 128 d'ASCII, plus 128 autres couvrant les caractères des langues d'Europe occidentale — é, à, ü, ñ, ç. Bon marché, mais borné à une région du monde : le grec, le cyrillique, l'arabe, le chinois ont chacun réclamé leur propre norme, incompatible avec les autres. Un même octet désignait alors des caractères différents selon la table employée.
Unicode.
Le principe change : au lieu d'une table par région, un répertoire universel qui attribue à chaque caractère de chaque écriture un numéro unique appelé point de code, noté U+ suivi de sa valeur hexadécimale. Le é est U+00E9, la lettre grecque est U+03C0.
Unicode dit quel numéro porte chaque caractère. Il ne dit pas comment écrire ce numéro en octets — c'est le rôle d'un encodage comme UTF-8, qui code un caractère sur un à quatre octets selon sa valeur, et qui a l'immense avantage de coïncider avec ASCII sur les 128 premiers codes. Un fichier purement anglais en UTF-8 est identique au même fichier en ASCII. C'est cette compatibilité qui a fait d'UTF-8 l'encodage dominant du Web.
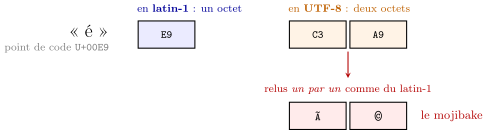
lire du latin-1 ne provoque aucune erreur : cela produit deux caractères là où il y en avait un.</div>
>>> ord("A"), ord("a"), ord("é"), ord("π")
(65, 97, 233, 960)
>>> chr(65), chr(233)
('A', 'é')
>>> "é".encode("utf-8")
b'\xc3\xa9'
>>> "é".encode("latin-1")
b'\xe9'
Le même caractère occupe deux octets en UTF-8 et un seul en latin-1. Lire l'un en croyant lire l'autre produit ces suites de caractères absurdes que l'on voit parfois s'afficher — é au lieu de é : c'est exactement l'octet C3 A9 interprété comme deux caractères latin-1.
2.3.3 Convertir un fichier
Capacité attendue
« Convertir un fichier texte dans différents formats d'encodage. »
def convertir(source, destination, encodage_entree, encodage_sortie):
    """Réécrit le fichier source dans un autre encodage.

    Précondition : le fichier source est effectivement écrit dans
    encodage_entree, et tous ses caractères sont représentables dans
    encodage_sortie — sans quoi une exception est levée, ce qui vaut
    mieux qu'un fichier silencieusement abîmé.
    """
    with open(source, "r", encoding=encodage_entree) as f:
        contenu = f.read()
    with open(destination, "w", encoding=encodage_sortie) as f:
f.write(contenu)Un fichier texte ne contient aucune indication de son propre encodage : ce ne sont que des octets. Le lecteur doit le savoir, ou le deviner. C'est pourquoi l'argument encoding de open n'est pas un détail : l'omettre, c'est laisser Python choisir selon le système, et obtenir un programme qui marche sur une machine et échoue sur une autre.
Hors programme : Ce que le programme n'exige pas
« Aucune connaissance précise des normes d'encodage n'est exigible. » Il n'est demandé ni de mémoriser des tables de codes, ni de connaître le découpage en octets d'UTF-8, ni la liste des normes ISO-8859. Ce qui est attendu : comprendre pourquoi plusieurs encodages ont existé, et savoir convertir un fichier de l'un à l'autre.
Piste de projet : Un détecteur d'encodage
Écrire un programme qui, devant un fichier d'encodage inconnu, tente les encodages usuels et propose le plus vraisemblable. Deux critères simples suffisent à commencer : le décodage échoue-t-il ? et, s'il réussit, le texte obtenu contient-il des séquences improbables du type é ou è ? Extension : mesurer la fréquence des lettres et comparer à celle du français.
Le sujet a le mérite d'être honnêtement difficile — aucun détecteur n'est infaillible — et de le rester à la portée d'un groupe de trois.