Réseaux : protocoles, routage et sécurité
Cours complet · NSI (terminale), chapitre 14 · terminale, spécialité numérique et sciences informatiques
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Les réseaux informatiques permettent à des machines distantes de communiquer en s'échangeant des données. Du courrier électronique à la navigation web, en passant par les services bancaires en ligne, toutes ces applications reposent sur un ensemble de protocoles, c'est-à-dire de règles communes qui définissent comment les informations sont formatées, transmises et acheminées.
Comprendre un réseau, c'est d'abord comprendre comment il est organisé en couches, comment les machines sont adressées, comment les données circulent par commutation de paquets et sont routées de proche en proche, et enfin comment les communications peuvent être sécurisées par le chiffrement. Ce chapitre présente ces notions, conformément au programme de NSI de terminale.
14.1 Le modèle en couches TCP/IP
L'idée fondatrice des réseaux modernes est la décomposition en couches. Plutôt que de concevoir un système monolithique, on empile des couches indépendantes, chacune rendant un service à la couche supérieure et utilisant les services de la couche inférieure.
Un modèle en couches organise les fonctions d'un réseau en niveaux superposés. Chaque couche ne communique qu'avec les couches immédiatement adjacentes. Cette séparation permet de modifier l'implémentation d'une couche sans toucher aux autres.
Le modèle de référence pour Internet est le modèle TCP/IP, composé de quatre couches.
De la plus haute à la plus basse :
- Couche application : protocoles utilisés par les logiciels (HTTP, DNS, SMTP, FTP).
- Couche transport : transmission de bout en bout entre deux programmes (TCP, UDP).
- Couche réseau (Internet) : acheminement des paquets entre machines distantes grâce à l'adressage IP et au routage (protocole IP).
- Couche liaison (accès réseau) : transmission physique sur un même lien local (Ethernet, Wi-Fi).
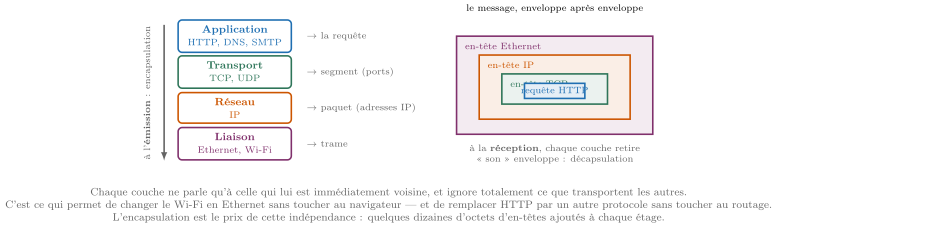
Lorsqu'un navigateur envoie une requête web, le message est progressivement encapsulé. La couche application produit une requête HTTP. La couche transport l'enveloppe dans un segment TCP (en ajoutant les numéros de port). La couche réseau place ce segment dans un paquet IP (en ajoutant les adresses IP source et destination). La couche liaison forme enfin une trame Ethernet. À la réception, chaque couche retire « son » enveloppe : c'est la décapsulation.
14.2 Adressage IP et commutation de paquets
14.2.1 L'adresse IP
Une adresse IP (version 4) identifie de manière unique une interface réseau. Elle est codée sur 32 bits, soit quatre octets, et notée en décimal pointé : quatre nombres entre 0 et 255 séparés par des points, par exemple 192.168.1.10.
L'adresse 192.168.1.10 s'écrit en binaire en convertissant chaque octet :
soit 11000000.10101000.00000001.00001010.
14.2.2 Masque de sous-réseau
Une adresse IP se décompose en deux parties : une partie identifiant le réseau et une partie identifiant la machine (l'hôte) au sein de ce réseau. C'est le masque de sous-réseau qui indique où se situe la frontière.
Le masque de sous-réseau est une suite de 32 bits commençant par une série de 1 (partie réseau) suivie d'une série de 0 (partie hôte). On le note soit en décimal pointé (255.255.255.0), soit en notation CIDR : un /n où est le nombre de bits à 1. Ainsi 255.255.255.0 équivaut à /24.
Méthode : Trouver l'adresse de réseau
Pour obtenir l'adresse du réseau d'une machine, on effectue un ET logique (bit à bit) entre l'adresse IP et le masque. Concrètement, les octets couverts par les 1 du masque sont conservés, les octets couverts par les 0 deviennent 0.
- Écrire l'adresse IP et le masque en binaire.
- Appliquer le ET bit à bit (, sinon ).
- Reconvertir le résultat en décimal pointé.
Soit l'adresse 192.168.1.10 avec le masque 255.255.255.0 (/24). Les trois premiers octets sont couverts par des 1 : ils sont conservés. Le dernier octet est couvert par des 0 : il devient 0. L'adresse de réseau est donc 192.168.1.0. Toutes les machines dont l'adresse commence par 192.168.1. appartiennent au même réseau.
Pour un masque comportant bits à 0 (partie hôte), il existe combinaisons possibles. Mais deux adresses sont réservées : l'adresse de réseau (tous les bits hôte à 0) et l'adresse de diffusion (broadcast, tous les bits hôte à 1). Le nombre de machines réellement adressables est donc :
Par exemple, pour un /24 on a , soit machines.
14.2.3 Commutation de paquets
Dans la commutation de paquets, un message est découpé en petits blocs appelés paquets. Chaque paquet contient les adresses source et destination, et voyage indépendamment sur le réseau, pouvant emprunter des chemins différents. Les paquets sont réassemblés à l'arrivée.
La commutation de paquets s'oppose à la commutation de circuits (utilisée par le téléphone classique, qui réserve une ligne dédiée). Elle offre :
- une meilleure utilisation des liens (plusieurs communications partagent un même câble) ;
- une grande robustesse : si un lien tombe en panne, les paquets peuvent être réacheminés par un autre chemin.
14.3 Les protocoles de transport et d'application
14.3.1 TCP et UDP
TCP est un protocole de transport fiable et orienté connexion. Avant tout échange, une connexion est établie (poignée de main en trois temps). TCP garantit que les données arrivent complètes, dans l'ordre et sans erreur, en numérotant les segments, en demandant la retransmission des paquets perdus et en envoyant des accusés de réception.
UDP est un protocole de transport léger et sans connexion. Il envoie les données sans accusé de réception ni contrôle d'ordre : il est rapide mais ne garantit ni la livraison ni l'ordre. Il convient aux applications tolérant des pertes mais exigeant de la rapidité (streaming vidéo, jeux en ligne, voix sur IP, DNS).
On choisit TCP quand l'intégrité des données prime (page web, courriel, transfert de fichier) et UDP quand la rapidité prime et que quelques pertes sont acceptables (vidéo en direct, jeu temps réel).
14.3.2 HTTP et DNS
HTTP est le protocole de la couche application utilisé pour échanger des pages web entre un client (navigateur) et un serveur. Le client envoie une requête (par exemple GET /index.html), le serveur renvoie une réponse contenant un code d'état (200 pour succès, 404 pour page introuvable) et le contenu demandé. HTTP s'appuie sur TCP.
Le DNS est l'annuaire d'Internet : il traduit les noms de domaine lisibles par l'humain (par exemple www.exemple.fr) en adresses IP utilisables par les machines (par exemple 93.184.216.34). Cette résolution est effectuée par des serveurs DNS interrogés avant toute connexion à un site.
Quand on saisit www.exemple.fr dans un navigateur :
- le DNS traduit
www.exemple.fren une adresse IP ; - le navigateur ouvre une connexion TCP vers cette adresse IP, sur le port 80 (HTTP) ou 443 (HTTPS) ;
- il envoie une requête HTTP
GET; - le serveur renvoie la page, qui s'affiche.
14.4 Le routage
Pour qu'un paquet atteigne une machine située sur un autre réseau, il doit traverser plusieurs équipements intermédiaires appelés routeurs. Le routage est le mécanisme qui choisit, à chaque étape, le prochain routeur vers lequel transmettre le paquet.
Un routeur est une machine reliant plusieurs réseaux. Il possède une table de routage : une liste associant à chaque réseau de destination le prochain saut (l'adresse du routeur voisin vers lequel envoyer le paquet) et un coût. À la réception d'un paquet, le routeur consulte cette table pour décider de la direction à prendre.
| Réseau destination | Prochain saut | Coût |
|---|---|---|
| `192.168.2.0/24` | `10.0.0.2` | 1 |
| `192.168.3.0/24` | `10.0.0.6` | 2 |
| `0.0.0.0/0` (défaut) | `10.0.0.1` | --- |
La dernière ligne est la route par défaut : elle est utilisée lorsque aucune autre route ne correspond à la destination.
14.4.1 Les protocoles de routage RIP et OSPF
Les tables de routage peuvent être construites automatiquement par des protocoles de routage qui font dialoguer les routeurs entre eux.
RIP est un protocole de routage fondé sur le nombre de sauts (nombre de routeurs traversés). Le coût d'une route est simplement le nombre de routeurs à franchir pour atteindre la destination. RIP choisit toujours la route comportant le moins de sauts. Sa limite : un coût maximal de 15 sauts (16 = inaccessible), ce qui le réserve aux réseaux de petite taille, et il ne tient pas compte du débit des liens.
OSPF est un protocole de routage fondé sur le coût de chaque lien, généralement calculé à partir de son débit (un lien rapide a un faible coût). Chaque routeur connaît la carte complète du réseau et calcule le chemin de coût total minimal (algorithme du plus court chemin, type Dijkstra). OSPF est plus performant que RIP sur les grands réseaux car il privilégie les liens rapides plutôt que le simple nombre de sauts.
- RIP : métrique = nombre de sauts ; simple ; adapté aux petits réseaux ; peut choisir un chemin lent s'il a moins de sauts.
- OSPF : métrique = somme des coûts (liée au débit) ; plus complexe ; adapté aux grands réseaux ; choisit le chemin réellement le plus rapide.
14.5 Sécurisation des communications
Sur Internet, les paquets transitent par de nombreux équipements : sans protection, leur contenu peut être lu ou modifié. La cryptographie permet de garantir la confidentialité (seul le destinataire peut lire) et l'intégrité (le message n'a pas été altéré) des échanges.
Dans le chiffrement symétrique, une même clé secrète sert à chiffrer et à déchiffrer le message. Il est très rapide, mais pose un problème : comment transmettre la clé secrète à son correspondant sans qu'elle soit interceptée ? Exemple d'algorithme : AES.
Dans le chiffrement asymétrique, chaque participant possède une paire de clés : une clé publique (diffusable librement) et une clé privée (gardée secrète). Un message chiffré avec la clé publique d'un destinataire ne peut être déchiffré qu'avec sa clé privée. Cela résout le problème d'échange de clé, mais ce chiffrement est lent. Exemple d'algorithme : RSA.
En pratique, on combine les deux méthodes. Le chiffrement asymétrique (lent mais sûr pour l'échange) sert à transmettre de façon sécurisée une clé de session symétrique. Ensuite, toute la communication utilise le chiffrement symétrique (rapide). On profite ainsi de la sécurité de l'un et de la vitesse de l'autre.
HTTPS est la version sécurisée de HTTP. Les données échangées sont chiffrées grâce au protocole TLS, qui repose sur le principe hybride ci-dessus. HTTPS apporte :
- la confidentialité : les données sont chiffrées ;
- l'authentification du serveur grâce à un certificat délivré par une autorité de confiance ;
- l'intégrité : toute altération est détectée.
HTTPS utilise par défaut le port 443.
Lors d'une connexion HTTPS, le client et le serveur procèdent ainsi :
- le serveur envoie son certificat contenant sa clé publique ;
- le client vérifie le certificat puis génère une clé de session symétrique ;
- cette clé de session est transmise au serveur en étant chiffrée avec la clé publique du serveur (chiffrement asymétrique) ;
- la suite des échanges est chiffrée avec la clé de session (chiffrement symétrique).