Calculabilité, décidabilité et paradigmes de programmation
Cours complet · NSI (terminale), chapitre 16 · terminale, spécialité numérique et sciences informatiques
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Depuis le début de l'année, nous avons appris à écrire des programmes qui fonctionnent. La question de ce chapitre est d'une autre nature : nous ne demanderons plus comment résoudre un problème, mais s'il peut l'être. Existe-t-il des problèmes que l'on énonce parfaitement clairement, et qu'aucun programme, dans aucun langage, sur aucune machine, ne résoudra jamais ? La réponse est oui, et la démonstration tient en une page.
Elle repose sur une remarque d'apparence anodine, que nous établirons d'abord : un programme est une donnée. Un fichier .py n'est qu'un texte, un logiciel téléchargé qu'une suite d'octets. Rien n'interdit donc de donner un programme à manger à un autre programme — c'est ce que font en permanence l'interprète Python, un compilateur ou un système d'exploitation — ni de le donner à lui-même. C'est de ce vertige que naît l'indécidabilité du problème de l'arrêt.
Le chapitre poursuit sur les paradigmes de programmation : une même tâche s'écrit de plusieurs manières, selon que l'on décrit des étapes (impératif), que l'on compose des fonctions (fonctionnel) ou que l'on fait dialoguer des objets. Il s'achève sur l'algorithme de Boyer--Moore, qui recherche un motif dans un texte. Le rapprochement n'est pas arbitraire : cet algorithme commence par lire le motif pour en tirer un tableau de décalages, exactement comme un compilateur commence par lire un programme pour en tirer une information exploitable.
16.1 Introduction : ce qu'aucun programme ne pourra jamais faire
Votre professeur doit corriger trente programmes. Il aimerait un outil qui, pour chaque copie, réponde à une seule question : ce programme s'arrête-t-il, ou contient-il une boucle infinie ? La demande semble raisonnable : un logiciel d'analyse de code sait déjà repérer une variable inutilisée ou un indice hors bornes probable.
def f1(n):
    return n * n            # s'arrete toujours

def f2(n):
    while n != 1:           # personne ne sait le prouver
        if n % 2 == 0:
            n = n // 2
        else:
            n = 3 * n + 1
    return "arrivee a 1"

print(f1(7))       # 49
print(f2(27))      # arrivee a 1
Pour f1, la réponse est immédiate. f2 met en œuvre la célèbre suite de Syracuse : le calcul se termine pour tous les entiers essayés depuis 1937, mais personne au monde n'a su démontrer qu'il se termine pour tous les entiers.
Nous allons démontrer bien pire que la difficulté du cas de f2 : la question est impossible. Aucun programme ne peut répondre correctement pour tous les programmes qu'on lui soumet. Ce résultat, dû à Alan Turing en 1936, ne dépend ni de la puissance des machines, ni du langage employé.
Le langage courant confond deux notions. Un problème peut être difficile : le voyageur de commerce se résout, mais au prix d'un temps qui explose avec la taille des données. Un problème peut être impossible : aucun algorithme ne le résout, quel que soit le temps accordé. Le problème de l'arrêt appartient à la seconde catégorie.
16.2 Un programme est une donnée
16.2.1 Le code source n'est qu'un texte
Ouvrez n'importe quel fichier .py avec un éditeur : vous y lisez des caractères, ni plus ni moins. Le fichier ne « contient » pas un programme en un sens mystérieux ; il contient une suite de lettres, de chiffres et de retours à la ligne, rangée sur un disque comme le serait un poème.
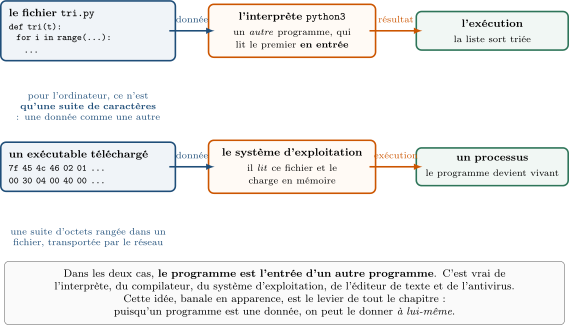
Un programme n'existe pour la machine que sous la forme d'une suite finie de symboles : caractères de son code source, ou octets de son fichier exécutable. Cette suite peut être stockée, copiée, transmise, lue, comptée, comparée et modifiée comme n'importe quelle autre donnée. C'est seulement lorsqu'un autre programme — interprète, système d'exploitation, processeur — la lit et lui obéit qu'elle se comporte comme un programme.
source = "resultat = 0\nfor k in range(1, 5):\n    resultat += k\n"

print(type(source))              # <class 'str'>
print(source.count("resultat"))  # 2
print(source.split("\n")[1])     # for k in range(1, 5):
Rien ici ne distingue source d'une phrase quelconque : on compte des occurrences, on la découpe.
16.2.2 Interpréter, compiler, télécharger, charger
Cette idée n'a rien d'une curiosité de laboratoire : c'est le fonctionnement ordinaire de toute la chaîne logicielle. Quand vous tapez python3 tri.py, le programme python3 ouvre votre fichier et le lit caractère par caractère : votre code est sa donnée d'entrée, comme une image l'est pour une visionneuse. Un compilateur, lui, lit un fichier source et produit un fichier exécutable : c'est un programme qui prend un programme et rend un programme. Ce logiciel, vous l'avez téléchargé sous forme de paquets réseau puis enregistré sur le disque, où il n'était qu'un fichier parmi d'autres ; et pour le lancer, le système d'exploitation a lu ce fichier, copié son contenu en mémoire vive et transféré le contrôle au processeur. Le programme n'est devenu un processus qu'à cet instant.
16.2.3 En Python : exec, eval et compile
Python rend cette dualité particulièrement visible.
Méthode : Exécuter du texte
eval(chaine)évalue une expression et renvoie sa valeur ;exec(chaine)exécute une ou plusieurs instructions ;compile(chaine, nom, mode)traduit le texte en un objet-code réutilisable, sans l'exécuter.
Un second argument optionnel de exec est un dictionnaire où seront rangées les variables créées : on y récupère les résultats.
print(eval("2 ** 10"))            # 1024

source = "resultat = 0\nfor k in range(1, 5):\n    resultat += k\n"
espace = {}
exec(source, espace)
print(espace["resultat"])         # 10

objet = compile("resultat = 6 * 7", "<chaine>", "exec")
print(type(objet))                # <class 'code'>
memoire = {}
exec(objet, memoire)
print(memoire["resultat"])        # 42
La chaîne source a été traitée d'abord comme une donnée — on l'a rangée dans une variable — puis comme un programme.
exec exécute tout ce qu'on lui donne : appliqué à du texte saisi par un utilisateur, il lui offrirait le contrôle de la machine. On l'emploie ici pour comprendre, jamais pour bâtir un vrai logiciel.
Notons au passage qu'un programme peut donc en fabriquer un autre, en construisant son texte par concaténation. C'est le principe du compilateur, et nous nous en servirons deux fois : pour fabriquer un programme du mini-langage, puis pour construire une réduction.
16.3 La calculabilité
16.3.1 Fonctions calculables, problèmes décidables
Une fonction est calculable s'il existe un algorithme qui, pour toute donnée de son domaine, s'arrête au bout d'un nombre fini d'étapes en fournissant .
Un problème de décision est une question dont la réponse est True ou False, posée sur une donnée : « cet entier est-il premier ? », « ce graphe est-il connexe ? », « ce programme s'arrête-t-il ? ».
Il est décidable s'il existe un algorithme qui répond correctement pour toute donnée et qui s'arrête toujours. Il est indécidable sinon.
Les deux exigences comptent autant l'une que l'autre. Un programme qui donne la bonne réponse quand il en donne une, mais qui tourne indéfiniment sur certaines entrées, ne décide rien. La primalité, elle, est bien décidable : l'algorithme qui essaie tous les diviseurs jusqu'à répond juste et s'arrête toujours.
16.3.2 La calculabilité ne dépend pas du langage
Un même calcul s'écrit de mille façons. Le pgcd de deux entiers se programme par divisions ou par soustractions successives, en boucle ou en récursion : quatre algorithmes différents pour une seule fonction calculée.
def pgcd_imperatif(a, b):
    while b != 0:
        a, b = b, a % b
    return a

def pgcd_recursif(a, b):
    if b == 0:
        return a
    return pgcd_recursif(b, a % b)

print(pgcd_imperatif(84, 36))     # 12
print(pgcd_recursif(84, 36))      # 12
Une boucle d'un côté, un appel de fonction de l'autre : deux algorithmes, une seule et même fonction calculée.
Ce constat se généralise bien au-delà des styles d'écriture : il vaut d'un langage à l'autre.
Tous les modèles de calcul raisonnables proposés depuis 1936 — machines de Turing, fonctions récursives, lambda-calcul, langages de programmation usuels — calculent exactement le même ensemble de fonctions.
Par conséquent, une fonction calculable en Python l'est en C, en OCaml, en Java ou sur n'importe quelle machine future ; et une fonction non calculable ne le sera dans aucun d'eux. La calculabilité ne dépend pas du langage de programmation utilisé.
Le langage change la longueur du code, sa lisibilité, sa vitesse d'exécution, le confort du programmeur. Il ne change rien à la frontière entre le calculable et le reste : un problème indécidable le demeure dans tous les langages, sur tous les ordinateurs, aujourd'hui et dans mille ans. Un langage n'a d'ailleurs besoin que de très peu pour atteindre cette pleine puissance — des variables entières, l'affectation et un saut conditionnel suffisent, comme le montrera le mini-langage à six instructions étudié plus loin. On dit d'un tel langage qu'il est Turing-complet.
C'est pourquoi la suite du chapitre peut raisonner en Python sans rien perdre en généralité : ce que nous montrerons impossible en Python est impossible partout.
16.4 Le problème de l'arrêt
16.4.1 L'énoncé
Le problème de l'arrêt est le problème de décision suivant : étant donnés le code source d'un programme et une entrée , déterminer si l'exécution de sur se termine.
Le résoudre, ce serait écrire une fonction arrete(source, entree) renvoyant True si s'arrête sur , False s'il tourne indéfiniment — et qui, elle, s'arrête toujours.
L'énoncé n'a de sens que parce qu'un programme est une donnée : arrete reçoit source comme premier argument, c'est-à-dire du texte.
16.4.2 Pourquoi « essayer pour voir » ne répond pas
Une idée vient naturellement : exécuter le programme et regarder. Elle échoue, et il importe de comprendre pourquoi.
def arrete_naif(n, limite=1000):
    """Suit la suite de Syracuse pendant `limite` tours, au plus."""
    tours = 0
    while n != 1 and tours < limite:
        n = n // 2 if n % 2 == 0 else 3 * n + 1
        tours = tours + 1
    return "s'arrete" if n == 1 else "inconnu"

print(arrete_naif(27))              # s'arrete
print(arrete_naif(27, limite=10))   # inconnu
Si le programme s'arrête avant la limite, on le sait. Sinon on ne sait rien : peut-être s'arrêterait-il au tour suivant, peut-être jamais. Supprimer la limite n'arrange rien — la fonction ne s'arrêterait alors pas elle-même sur les programmes qui bouclent, or un décideur doit toujours s'arrêter. On tourne en rond, et ce n'est pas un hasard.
16.4.3 La démonstration
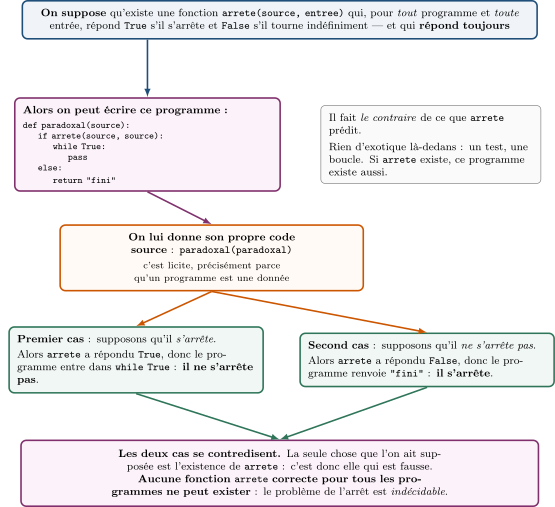
Montrons que arrete ne peut pas exister. Le raisonnement est par l'absurde : on suppose la fonction disponible et on en tire une contradiction.
Méthode : Le plan de la démonstration
- Supposer qu'il existe une fonction
arrete(source, entree)correcte pour tous les programmes et toutes les entrées, et qui s'arrête toujours. - Construire, à l'aide de
arrete, un programmeparadoxalqui fait systématiquement le contraire de ce quearreteprédit. - Lui donner son propre code source — c'est licite, puisqu'un programme est une donnée.
- Constater que les deux réponses possibles mènent chacune à une absurdité, et conclure que l'hypothèse de départ était fausse.
Étape 1 — l'hypothèse. Admettons que la fonction suivante existe et soit toujours correcte :
def arrete(source, entree):
    """HYPOTHESE : renvoie True si le programme dont le texte est `source`
    s'arrete sur l'entree `entree`, et False s'il tourne indefiniment.
    Cette fonction s'arrete toujours."""
    ...
Étape 2 — le programme paradoxal. Rien n'empêche alors d'écrire :
def paradoxal(source):
    if arrete(source, source):
        while True:          # si l'on predit qu'il s'arrete, on boucle
            pass
    else:
        return "fini"        # si l'on predit qu'il boucle, on s'arrete
Ce programme n'a rien d'exotique : un appel de fonction, un test, une boucle. Si arrete existe, paradoxal existe.
Étape 3 — l'auto-application. Exécutons paradoxal en lui donnant son propre code source comme argument, soit paradoxal(paradoxal). L'opération est parfaitement légitime : le texte du programme paradoxal est une chaîne de caractères, donc une entrée acceptable.
Étape 4 — la contradiction. Deux cas, et deux seulement.
- Supposons d'abord que cet appel s'arrête. Alors, par correction de
arrete, celle-ci a réponduTruesur le couple qu'on lui a soumis. Mais dans ce cas la première branche duifest prise et le programme entre dans la bouclewhile True: il ne s'arrête pas. Contradiction. - Supposons au contraire qu'il ne s'arrête pas. Alors
arretea réponduFalsesur ce même couple. Mais la brancheelseest alors prise et le programme renvoie immédiatement"fini": il s'arrête. Contradiction de nouveau.
Les deux seules possibilités sont absurdes. Comme le raisonnement est correct, l'erreur ne peut venir que de l'unique chose supposée : l'existence de arrete.
Le problème de l'arrêt est indécidable : il n'existe aucun algorithme qui, recevant le code source d'un programme quelconque et une entrée quelconque, détermine toujours correctement si l'exécution se termine. Ce résultat ne dépend ni du langage de programmation, ni de la machine, ni de la durée de calcul accordée.
Il ne dit pas qu'on ne peut jamais savoir si un programme s'arrête : pour f1, la réponse est évidente, et les outils d'analyse statique traitent avec succès quantité de cas particuliers. Ce que le théorème interdit, c'est une méthode universelle : un unique programme correct sur tous les cas.
16.4.4 Ce qui en découle
L'indécidabilité de l'arrêt se propage à une foule de questions concrètes, par un raisonnement dit de réduction : si je savais résoudre la question , je saurais résoudre l'arrêt ; comme c'est impossible, est indécidable aussi.
Aucun antivirus n'est parfait : « ce programme va-t-il effacer mes fichiers ? » est indécidable, si bien qu'un antivirus travaille par signatures — des morceaux de code déjà connus — et par heuristiques, avec d'inévitables faux positifs et faux négatifs. De même, aucun compilateur ne garantit l'absence de boucle infinie, et aucun outil ne décide si deux programmes font la même chose ni ne détecte tout le code mort.
On renonce donc à l'universalité, et on récupère beaucoup : on traite des sous-classes décidables (un programme sans boucle while ni récursion s'arrête toujours, et cela se vérifie mécaniquement) ; on accepte de répondre « oui », « non » ou « je ne sais pas », principe de l'analyse statique moderne ; on impose un délai maximal, comme le font les plateformes de correction automatique de code.
16.5 Les paradigmes de programmation
Un paradigme de programmation est une manière de concevoir et d'organiser un programme : ce que l'on prend pour brique de base, la façon de traiter l'état, le vocabulaire dans lequel on pense le problème. Ce n'est pas une propriété du langage, mais un style d'écriture.
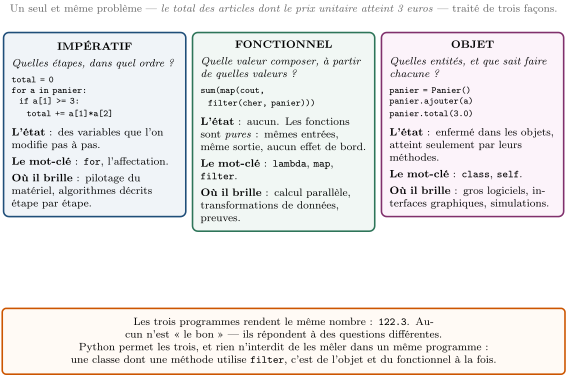
Traitons un même problème dans chacun des trois paradigmes. Le voici : un panier d'achats est donné comme liste de triplets (nom, prix_unitaire, quantite) ; on veut le total des articles dont le prix unitaire atteint un certain seuil.
PANIER = [("stylo", 2.5, 4), ("cahier", 3.0, 6), ("classeur", 7.2, 2),
          ("calculatrice", 89.9, 1), ("gomme", 1.1, 3)]
16.5.1 Le paradigme impératif
La programmation impérative décrit le calcul comme une suite d'instructions qui modifient l'état de la machine. Ses briques sont l'affectation, la séquence, le test et la boucle. C'est le style de la quasi-totalité des programmes écrits depuis la classe de seconde.
def total_imperatif(panier, seuil):
    total = 0.0
    for article in panier:
        prix = article[1]
        quantite = article[2]
        if prix >= seuil:
            total = total + prix * quantite
    return round(total, 2)

print(total_imperatif(PANIER, 3.0))   # 122.3
On lit le programme comme une recette : partir de zéro, parcourir, tester, accumuler. La variable total change de valeur à chaque tour.
16.5.2 Le paradigme fonctionnel
La programmation fonctionnelle décrit le calcul comme la composition de fonctions appliquées à des valeurs. Elle évite les variables modifiables et privilégie les fonctions pures.
Une fonction est pure si elle renvoie toujours le même résultat pour les mêmes arguments et si elle ne modifie rien en dehors d'elle-même. Toute modification extérieure — changer une liste reçue en argument, écrire dans un fichier, afficher — s'appelle un effet de bord.
def remise_impure(panier, taux):        # modifie la liste recue
    for i in range(len(panier)):
        nom, prix, q = panier[i]
        panier[i] = (nom, round(prix * (1 - taux), 2), q)

def remise_pure(panier, taux):          # ne touche a rien
    return [(nom, round(prix * (1 - taux), 2), q)
            for nom, prix, q in panier]

copie = list(PANIER)
nouveau = remise_pure(copie, 0.10)
print(copie[0])      # ('stylo', 2.5, 4)   -> inchange
print(nouveau[0])    # ('stylo', 2.25, 4)  -> nouvelle liste

remise_impure(copie, 0.10)
print(copie[0])      # ('stylo', 2.25, 4)  -> la liste a ete modifiee
Après remise_pure, l'appelant retrouve ses données intactes ; après remise_impure, elles ont changé sous ses pieds. C'est là toute la différence, et la source de bien des bogues.
Méthode : Les outils fonctionnels de Python
lambda x: expressiondéfinit une fonction anonyme ;map(f, iterable)appliquefà chaque élément ;filter(p, iterable)garde les éléments vérifiantp;functools.reduce(f, iterable, initial)replie l'ensemble en une seule valeur ;- une fonction peut être passée en argument ou renvoyée : on parle de fonction d'ordre supérieur. La récursion y joue le rôle que la boucle joue en impératif.
map et filter renvoient des objets paresseux : on les convertit avec list pour les afficher.
from functools import reduce

def cout(article):
    return article[1] * article[2]

def cher(article):
    return article[1] >= 3.0

def total_fonctionnel(panier, seuil):
    chers = filter(lambda a: a[1] >= seuil, panier)
    couts = map(cout, chers)
    return round(reduce(lambda x, y: x + y, couts, 0.0), 2)

print(total_fonctionnel(PANIER, 3.0))      # 122.3
print([round(cout(a), 2) for a in PANIER]) # [10.0, 18.0, 14.4, 89.9, 3.3]
print([a[0] for a in filter(cher, PANIER)])
# ['cahier', 'classeur', 'calculatrice']
Aucune variable n'est modifiée : on décrit ce que l'on veut obtenir — les chers, puis leurs coûts, puis leur somme — plutôt que la manière de l'obtenir pas à pas.
16.5.3 Le paradigme objet
La programmation objet organise le programme autour d'objets réunissant des données (attributs) et les comportements qui les manipulent (méthodes). L'état existe, mais il est encapsulé : on n'y accède qu'au travers de l'interface publique de l'objet.
class Article:
    def __init__(self, nom, prix, quantite):
        self.nom = nom
        self.prix = prix
        self.quantite = quantite

    def cout(self):
        return self.prix * self.quantite

    def __repr__(self):
        return f"{self.nom} x{self.quantite}"

class Panier:
    def __init__(self):
        self.articles = []

    def ajouter(self, article):
        self.articles.append(article)

    def total(self, seuil):
        somme = 0.0
        for a in self.articles:
            if a.prix >= seuil:
                somme += a.cout()
        return round(somme, 2)

panier = Panier()
for nom, prix, q in PANIER:
    panier.ajouter(Article(nom, prix, q))

print(panier.total(3.0))      # 122.3
print(panier.articles[2])     # classeur x2
Le programme ne parle plus de triplets et d'indices, mais d'articles et de panier. La donnée articles est protégée derrière les méthodes.
16.5.4 Choisir un paradigme, et les mêler
Méthode : Choisir selon le champ d'application
- Impératif : quand le problème est une suite d'étapes — pilotage de matériel, systèmes embarqués, algorithmes classiques (tris, parcours de graphes), traitement séquentiel de fichiers.
- Fonctionnel : quand on transforme des données sans état — traitement de listes, calcul parallèle et distribué (chaque fonction pure peut tourner sur une machine différente sans risque), code que l'on veut tester ou prouver facilement, formules d'un tableur.
- Objet : quand le problème comporte des entités durables aux comportements propres — interfaces graphiques, jeux, simulations, gros logiciels développés en équipe, bibliothèques réutilisables.
Avec un même langage on peut utiliser des paradigmes différents : les trois versions ci-dessus sont toutes en Python, et il en va de même de C++, de Java récent, d'OCaml ou de JavaScript. Dans un même programme aussi : une méthode d'objet dont le corps est écrit avec filter et map, un algorithme impératif encapsulé dans une classe — c'est la situation ordinaire du logiciel réel.
class Panier2(Panier):
    def total(self, seuil):                       # objet ...
        chers = filter(lambda a: a.prix >= seuil, self.articles)
        return round(sum(map(Article.cout, chers)), 2)   # ... fonctionnel

p2 = Panier2()
for nom, prix, q in PANIER:                       # ... et imperatif
    p2.ajouter(Article(nom, prix, q))
print(p2.total(3.0))    # 122.3
Une classe, une boucle d'alimentation et un corps de méthode sans état : les trois paradigmes cohabitent sans difficulté.
16.6 Recherche textuelle : l'algorithme de Boyer--Moore
Chercher un motif dans un texte est l'une des opérations les plus courantes de l'informatique : la fonction « rechercher » d'un traitement de texte, le filtrage d'un journal de serveur, la recherche d'une séquence dans un génome, la détection d'une signature de virus dans un fichier — ce dernier exemple nous ramenant au début du chapitre.
Étant donnés un texte de longueur et un motif de longueur , la recherche textuelle consiste à déterminer toutes les positions du texte où le motif apparaît.
16.6.1 La méthode naïve
Méthode : Recherche naïve
On essaie successivement toutes les positions de à . Pour chacune, on compare le motif au texte caractère par caractère, de gauche à droite, et on s'arrête à la première différence.
def recherche_naive(texte, motif):
    n, m = len(texte), len(motif)
    positions = []
    for i in range(n - m + 1):
        j = 0
        while j < m and texte[i + j] == motif[j]:
            j = j + 1
        if j == m:
            positions.append(i)
    return positions

print(recherche_naive("ONCHERCHECHAT", "CHAT"))   # [9]
print(recherche_naive("ABABABA", "ABA"))          # [0, 2, 4]
print(recherche_naive("AAAA", "B")) # []Dans le pire cas, chacune des positions donne lieu à comparaisons : le coût est en . Sur du texte ordinaire il se comporte bien mieux, car les différences arrivent vite ; mais rien ne le garantit — essayez de chercher "AAAAB" dans une longue suite de A.
Le vrai défaut n'est pas le nombre de comparaisons : c'est que la méthode naïve jette toute l'information qu'elle vient d'acquérir. Ayant échoué à la position , elle recommence en comme si elle ne savait rien du texte.
16.6.2 L'idée de Boyer et Moore
En 1977, Robert Boyer et J Strother Moore publient un algorithme fondé sur deux idées simples, dont la seconde est la plus surprenante.
Méthode : Les deux idées de Boyer–Moore
- Comparer de droite à gauche. Le motif est aligné sur le texte, mais on compare d'abord son dernier caractère.
- Se servir du caractère fautif pour sauter. En cas d'échec, le caractère du texte qui a provoqué la différence renseigne sur la position où le motif a une chance de se trouver : on saute directement là, parfois de plusieurs caractères d'un coup.
La seconde idée n'a de sens que grâce à la première : c'est parce qu'on compare par la droite qu'un échec informe sur une portion du texte encore inexplorée.
16.6.3 Le prétraitement : la table du mauvais caractère
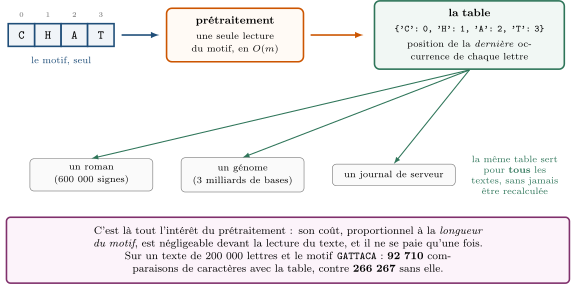
Pour sauter, il faut savoir où chaque caractère apparaît dans le motif. Cette information ne dépend que du motif : on la calcule donc une fois pour toutes, avant même de regarder le texte. C'est le prétraitement.
La table du mauvais caractère d'un motif associe à chaque caractère qui y figure l'indice de sa dernière occurrence dans le motif. Un caractère absent du motif est conventionnellement associé à .
def table_mauvais_caractere(motif):
    dernier = {}
    for k in range(len(motif)):
        dernier[motif[k]] = k       # ecrase : on garde la derniere position
    return dernier

print(table_mauvais_caractere("CHAT"))
# {'C': 0, 'H': 1, 'A': 2, 'T': 3}
print(table_mauvais_caractere("ABRACADABRA"))
# {'A': 10, 'B': 8, 'R': 9, 'C': 4, 'D': 6}
Une seule boucle sur le motif : le prétraitement coûte . Comme on écrase la valeur à chaque rencontre, c'est bien la dernière position qui subsiste.
Méthode : La règle du mauvais caractère
Le motif est aligné à la position ; la comparaison échoue à l'indice du motif, sur le caractère c du texte. Soit l'indice donné par la table pour c (avec si c est absent). On décale le motif de positions. Trois situations se présentent :
cn'est pas dans le motif () : aucune position ne peut convenir tant quecest sous le motif ; on saute de caractères, c'est-à-dire le motif entier lorsque l'échec a lieu sur le dernier caractère ;cest dans le motif, avant () : on aligne cette occurrence surc, soit un décalage de ;cn'apparaît qu'après () : l'aligner reviendrait à reculer ; on se contente d'avancer d'un cran, d'où lemaxavec , qui garantit la terminaison.
16.6.4 L'algorithme
def boyer_moore(texte, motif):
    n, m = len(texte), len(motif)
    if m == 0 or m > n:
        return []
    dernier = table_mauvais_caractere(motif)     # pretraitement
    positions = []
    i = 0
    while i <= n - m:
        j = m - 1
        while j >= 0 and texte[i + j] == motif[j]:   # de droite a gauche
            j = j - 1
        if j < 0:                                # tout a coincide
            positions.append(i)
            i = i + 1
        else:
            c = texte[i + j]                     # le mauvais caractere
            k = dernier.get(c, -1)
            i = i + max(1, j - k)
    return positions

print(boyer_moore("ONCHERCHECHAT", "CHAT"))              # [9]
print(boyer_moore("ABABABA", "ABA"))                     # [0, 2, 4]
print(boyer_moore("GCATCGCAGAGAGTATACAGTACG",
                  "GCAGAGAG"))                           # [5]
Les résultats sont identiques à ceux de la recherche naïve : seul le chemin pour y parvenir diffère. La figure ci-dessous suit ce chemin pas à pas sur le premier exemple, où l'algorithme n'essaie que quatre alignements.
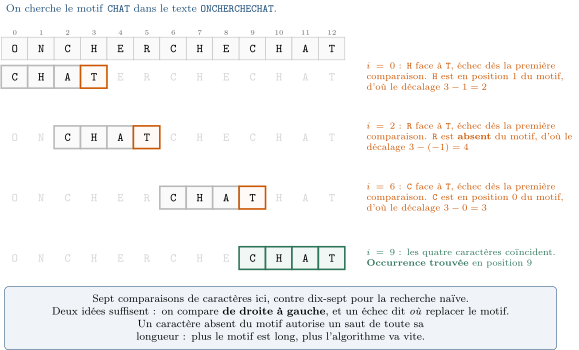
16.6.5 Coût et portée
Le prétraitement coûte et ne se paie qu'une fois, même si l'on cherche le même motif dans mille textes. La recherche est en dans le pire cas, comme la méthode naïve — mais ce pire cas est rare. En pratique, sur du texte réel, Boyer--Moore examine moins de caractères : il en saute. Plus le motif est long et plus l'alphabet est varié, plus les sauts sont grands.
Sur un texte aléatoire de lettres prises dans \{A, C, G, T\} et le motif GATTACA, la recherche naïve effectue comparaisons de caractères et Boyer--Moore : près de trois fois moins, sur un alphabet pourtant réduit à quatre lettres. Sur du texte français, l'écart est bien plus marqué.
L'algorithme original combine la règle du mauvais caractère avec une seconde règle, dite du bon suffixe, qui exploite la portion du motif qui venait de coïncider ; on retient à chaque échec le plus grand des deux décalages proposés. Cette seconde règle demande un prétraitement plus délicat et une analyse de coût difficile, hors programme : la version présentée ici en conserve l'essentiel de l'esprit et de l'efficacité.
16.7 Bilan
- Tout programme est aussi une donnée : son code source est un texte, son exécutable une suite d'octets. L'interprète, le compilateur, le système d'exploitation et l'antivirus prennent tous un programme en entrée.
- Une fonction est calculable s'il existe un algorithme qui la calcule en un temps fini ; un problème de décision est décidable s'il existe un algorithme qui répond correctement et qui s'arrête toujours.
- La calculabilité ne dépend pas du langage : tous les langages usuels calculent exactement les mêmes fonctions. Le langage change le confort, jamais la frontière du possible.
- Le problème de l'arrêt est indécidable. La démonstration suppose une fonction
arrete, construit un programme qui fait le contraire de sa prédiction, et le lui applique à lui-même : les deux cas se contredisent. - Il en découle qu'aucun antivirus n'est parfait et qu'aucun compilateur ne détecte toutes les boucles infinies. En pratique, on répond « je ne sais pas », on se restreint, ou on limite le temps.
- Trois paradigmes : impératif (une suite d'instructions modifiant un état), fonctionnel (une composition de fonctions pures, sans effet de bord), objet (des entités qui portent leur état et leurs comportements). Un même langage, et même un même programme, peuvent les mêler.
- Boyer--Moore compare le motif de droite à gauche et se sert du caractère fautif pour sauter. Un prétraitement en construit la table du mauvais caractère — l'indice de la dernière occurrence de chaque caractère du motif — et le décalage vaut .
Le fil de ce chapitre est plus serré qu'il n'y paraît. Parce qu'un programme est une donnée, on peut le donner à lui-même : de là vient l'indécidabilité. Parce qu'un motif est une donnée que l'on peut lire avant de s'en servir, on peut le prétraiter : de là vient l'efficacité de Boyer--Moore. Dans les deux cas, le levier est le même — accepter de regarder comme une donnée ce que l'on avait l'habitude de considérer comme un outil.