Dictionnaires et tables de hachage
Cours complet · NSI (terminale), chapitre 2 · terminale, spécialité numérique et sciences informatiques
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Le type dictionnaire est l'une des structures de données les plus utilisées en informatique. Contrairement aux tableaux et aux listes, où l'on accède aux éléments par un indice entier, le dictionnaire permet d'associer à une clé arbitraire (chaîne de caractères, nombre, tuple, etc.) une valeur quelconque. Cette association clé valeur, appelée parfois tableau associatif ou map, est rendue remarquablement efficace grâce à une technique fondamentale : le hachage.
Dans ce chapitre, nous étudions d'abord l'interface du type dictionnaire et les opérations disponibles en Python. Nous expliquons ensuite le mécanisme interne qui permet ces performances : la table de hachage, la fonction de hachage et la gestion des collisions. Nous analysons enfin le coût des opérations et présentons plusieurs applications classiques : le comptage d'occurrences, la construction d'index et la mémoïsation.
2.1 Le type dictionnaire
2.1.1 Définition et vocabulaire
Un dictionnaire est une structure de données qui associe à chaque clé une unique valeur. L'ensemble des couples constitue le contenu du dictionnaire. Les clés sont deux à deux distinctes : une même clé ne peut apparaître qu'une seule fois.
En Python, le dictionnaire est un type intégré (dict). On le construit avec des accolades, en séparant chaque clé de sa valeur par le caractère deux-points.
# Un annuaire associant un nom a un numero de telephone
annuaire = {
    "Alice": "06 12 34 56 78",
    "Bob":   "07 98 76 54 32",
    "Chloe": "06 11 22 33 44"
}

# Un dictionnaire vide
vide = {}
print(type(vide)) # <class 'dict'>En Python, une clé de dictionnaire doit être un objet hachable, c'est-à-dire immuable et possédant une valeur de hachage stable : nombres, chaînes de caractères, booléens et tuples (composés d'éléments hachables) sont hachables. Les listes et les dictionnaires, qui sont modifiables, ne peuvent pas servir de clé.
2.1.2 Opérations fondamentales
Méthode : Accès, ajout et modification
On accède à la valeur associée à une clé avec la notation entre crochets d[cle]. La même notation permet d'ajouter un nouveau couple ou de modifier une valeur existante.
annuaire["Alice"]            # lecture  -> "06 12 34 56 78"
annuaire["David"] = "06 00 00 00 00"   # ajout
annuaire["Bob"]   = "07 00 00 00 00"   # modification
L'accès à une clé absente provoque une erreur KeyError.
Méthode : Test d'appartenance et suppression
L'opérateur in teste la présence d'une clé. L'instruction del supprime un couple. La méthode get renvoie une valeur par défaut si la clé est absente, évitant ainsi l'erreur.
"Chloe" in annuaire          # True
"Zoe"   in annuaire          # False

del annuaire["Chloe"]        # suppression du couple

annuaire.get("Zoe", "inconnu")   # "inconnu" (cle absente)
Méthode : Parcours d'un dictionnaire
On peut parcourir les clés, les valeurs ou les couples au moyen des méthodes keys, values et items.
for cle in annuaire:                 # parcourt les cles
    print(cle)

for cle, valeur in annuaire.items(): # parcourt les couples
    print(cle, "->", valeur)

n = len(annuaire) # nombre de couples- Les clés sont uniques : une réaffectation écrase l'ancienne valeur.
- Depuis Python 3.7, l'ordre d'insertion des clés est conservé lors du parcours.
- Le dictionnaire est modifiable (mutable) : on peut ajouter, modifier et supprimer des couples après sa création.
2.2 Tables de hachage
Comment Python parvient-il à retrouver la valeur associée à une clé quasi instantanément, même dans un dictionnaire de plusieurs millions d'entrées ? La réponse tient dans la structure interne appelée table de hachage.
2.2.1 Fonction de hachage
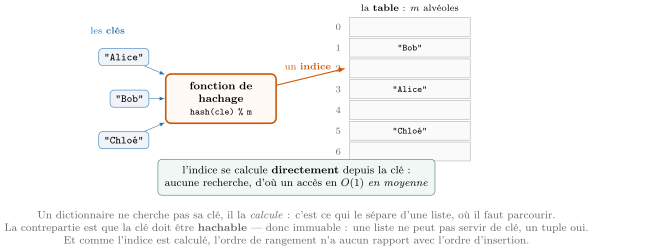
Une fonction de hachage est une fonction qui transforme une clé en un entier appelé empreinte (ou haché). Cet entier est ensuite ramené, typiquement par un reste de division (modulo), à un indice valide dans un tableau de taille fixée. On souhaite qu'une bonne fonction de hachage :
- soit rapide à calculer ;
- renvoie toujours la même empreinte pour une même clé (déterminisme) ;
- répartisse les clés le plus uniformément possible sur les indices.
Python fournit une fonction intégrée hash qui calcule l'empreinte d'un objet hachable.
print(hash("Alice"))     # un grand entier (depend de la session)
print(hash(42))          # 42
print(hash((1, 2)))      # un entier

# Reduction a un indice dans un tableau de taille 8
indice = hash("Alice") % 8
print(indice) # un entier entre 0 et 7Une table de hachage est un tableau de taille , dans lequel le couple est rangé à l'indice . La recherche, l'insertion et la suppression reviennent à calculer cet indice puis à accéder directement à la case correspondante. C'est cette implémentation qui est utilisée pour le type dict de Python.
2.2.2 Collisions
On parle de collision lorsque deux clés distinctes donnent le même indice, c'est-à-dire . Les collisions sont inévitables dès que le nombre de clés dépasse la taille de la table, et plus généralement très probables (paradoxe des anniversaires). Une table de hachage doit donc prévoir une stratégie pour les résoudre.
Méthode : Résolution par chaînage
Dans la méthode du chaînage (chaining), chaque case de la table contient une liste de couples. Toutes les clés tombant sur le même indice sont stockées dans cette liste. Pour rechercher une clé, on calcule son indice puis on parcourt la liste correspondante.
# Table a 4 cases, chaque case est une liste de couples
table = [[] for _ in range(4)]

def inserer(table, cle, valeur):
    i = hash(cle) % len(table)
    for couple in table[i]:          # cle deja presente ?
        if couple[0] == cle:
            couple[1] = valeur       # on met a jour
            return
    table[i].append([cle, valeur])   # sinon on ajoute

def rechercher(table, cle):
    i = hash(cle) % len(table)
    for c, v in table[i]:
        if c == cle:
            return v
    raise KeyError(cle)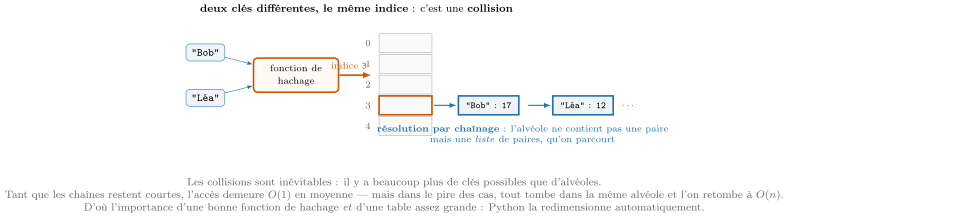
Méthode : Résolution par adressage ouvert
Dans l'adressage ouvert (open addressing), tous les couples sont stockés directement dans le tableau. En cas de collision, on cherche une autre case libre selon une règle de sondage. Le sondage linéaire essaie les cases d'indices (modulo ) jusqu'à en trouver une vide. Cette approche évite les listes auxiliaires mais se dégrade fortement quand la table se remplit.
Le facteur de charge d'une table de hachage est le rapport , où est le nombre de couples stockés et la taille de la table. Plus est grand, plus les collisions sont fréquentes. Pour maintenir de bonnes performances, l'implémentation redimensionne automatiquement la table (on double souvent ) lorsque dépasse un seuil, en réinsérant tous les couples : c'est le rehachage.
2.3 Coût des opérations
En supposant une fonction de hachage qui répartit bien les clés et un facteur de charge maîtrisé, les opérations sur une table de hachage ont un coût moyen constant :
- accès
d[cle]: en moyenne ; - insertion
d[cle] = v: en moyenne ; - suppression
del d[cle]: en moyenne ; - test
cle in d: en moyenne.
Dans le pire des cas (toutes les clés en collision sur la même case), ces opérations dégénèrent en , mais ce cas est extrêmement rare en pratique.
Rechercher un élément dans une liste Python non triée coûte , car il faut la parcourir. La même recherche, transformée en test d'appartenance d'une clé dans un dictionnaire, coûte en moyenne. Le dictionnaire est donc la structure de choix dès que l'on doit faire de nombreuses recherches par clé.
# Recherche dans une liste : O(n)
liste = list(range(1_000_000))
print(999_999 in liste)    # lent : parcours possible de tout

# Recherche dans un ensemble (meme principe que dict) : O(1) moyen
ensemble = set(range(1_000_000))
print(999_999 in ensemble) # quasi immediat
2.4 Applications
2.4.1 Comptage d'occurrences
Méthode : Compter les occurrences
Le dictionnaire est idéal pour compter combien de fois chaque élément apparaît dans une séquence : la clé est l'élément, la valeur est son compteur.
def compter(sequence):
    compteurs = {}
    for element in sequence:
        compteurs[element] = compteurs.get(element, 0) + 1
    return compteurs

print(compter("abracadabra"))
# {'a': 5, 'b': 2, 'r': 2, 'c': 1, 'd': 1}
2.4.2 Mémoïsation
La mémoïsation consiste à mémoriser dans un dictionnaire les résultats déjà calculés d'une fonction, indexés par ses arguments. Lors d'un nouvel appel, si le résultat est déjà connu, on le renvoie directement au lieu de le recalculer. Cette technique transforme certains algorithmes exponentiels en algorithmes de coût linéaire.
def fibo(n, memo={}):
    if n <= 1:
        return n
    if n in memo:            # deja calcule ?
        return memo[n]
    resultat = fibo(n - 1, memo) + fibo(n - 2, memo)
    memo[n] = resultat       # on memorise
    return resultat

print(fibo(50))   # instantane grace a la memoisation
Sans mémoïsation, le calcul naïf de fibo(50) demanderait un nombre exponentiel d'appels ; avec la mémoïsation, il devient .