Les graphes
Cours complet · NSI (terminale), chapitre 4 · terminale, spécialité numérique et sciences informatiques
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Les graphes constituent l'une des structures de données les plus puissantes et les plus universelles de l'informatique. Ils permettent de modéliser un grand nombre de situations du monde réel dès lors que l'on s'intéresse à des objets reliés entre eux par des relations : un réseau social où des personnes sont amies, une carte routière où des villes sont reliées par des routes, un réseau informatique où des machines sont connectées, ou encore les pages du web reliées par des liens hypertextes.
Dans ce chapitre, nous étudierons d'abord le vocabulaire mathématique des graphes (sommets, arêtes, degré, chemin, cycle), puis les deux grandes manières de représenter un graphe en mémoire (matrice d'adjacence et listes d'adjacence). Nous présenterons ensuite les deux algorithmes fondamentaux de parcours, le parcours en largeur (BFS) et le parcours en profondeur (DFS), avant d'aborder la détection de cycle. Le chapitre se termine par des exercices et des problèmes résolus inspirés d'applications concrètes comme les réseaux sociaux et le routage de l'information.
4.1 Définitions et vocabulaire
4.1.1 Notion de graphe
Un graphe est un couple où :
- est un ensemble fini d'éléments appelés sommets (en anglais vertices ou nodes) ;
- est un ensemble de liens reliant des paires de sommets.
On note souvent le nombre de sommets et le nombre de liens.
Dans un graphe non orienté, les liens sont appelés arêtes (en anglais edges). Une arête entre les sommets et est notée : elle ne possède pas de sens, on peut la parcourir de vers comme de vers .
Considérons quatre personnes : Alice, Bob, Chloé et David. Alice est amie avec Bob et Chloé ; Bob est ami avec Chloé ; Chloé est amie avec David. On modélise cette situation par un graphe non orienté à 4 sommets et 4 arêtes : \{Alice, Bob\}, \{Alice, Chloé\}, \{Bob, Chloé\} et \{Chloé, David\}. La relation « être ami avec » est symétrique, ce qui justifie l'emploi d'un graphe non orienté.
Dans un graphe orienté (en anglais directed graph ou digraph), les liens sont appelés arcs. Un arc du sommet vers le sommet est noté : il possède un sens. L'arc ne permet d'aller que de vers , et n'implique pas l'existence de l'arc .
Les pages d'un site web forment un graphe orienté : chaque page est un sommet, et un lien hypertexte de la page vers la page est un arc . Le fait que pointe vers n'implique pas que pointe vers : la relation n'est pas symétrique, d'où l'utilisation d'un graphe orienté.
Un graphe pondéré (ou valué) est un graphe dans lequel chaque lien (arête ou arc) est associé à un nombre appelé poids (ou coût). Le poids peut représenter une distance, une durée, un prix, une capacité, etc.
Une carte routière est un graphe pondéré : les villes sont les sommets, les routes sont les arêtes, et le poids d'une arête est la longueur (en kilomètres) de la route correspondante. Calculer le plus court trajet entre deux villes revient à chercher un chemin de poids minimal dans ce graphe.
4.1.2 Degré, chemin et cycle
Deux sommets et sont dits adjacents (ou voisins) s'ils sont reliés par une arête (graphe non orienté) ou par un arc (graphe orienté). L'ensemble des voisins d'un sommet est appelé son voisinage.
Dans un graphe non orienté, le degré d'un sommet , noté , est le nombre d'arêtes incidentes à , c'est-à-dire le nombre de ses voisins.
Dans un graphe orienté, on distingue :
- le degré entrant : nombre d'arcs arrivant en ;
- le degré sortant : nombre d'arcs partant de .
Dans un graphe non orienté à arêtes, la somme des degrés de tous les sommets vaut le double du nombre d'arêtes :
En effet, chaque arête contribue pour au degré de et pour au degré de , donc pour au total. On en déduit que le nombre de sommets de degré impair est toujours pair.
Un chemin de longueur entre deux sommets et est une suite de sommets telle que , , et que deux sommets consécutifs et soient reliés par une arête (ou un arc). La longueur du chemin est son nombre de liens, c'est-à-dire . Un chemin est dit simple s'il ne passe pas deux fois par le même sommet.
Un cycle est un chemin qui revient à son point de départ () en empruntant au moins un lien, sans répéter d'autre sommet ni de lien. Un graphe sans cycle est dit acyclique. Un graphe orienté acyclique est souvent appelé DAG (Directed Acyclic Graph).
Reprenons le réseau d'amitié précédent. La suite Alice, Bob, Chloé, David est un chemin simple de longueur 3 reliant Alice à David. La suite Alice, Bob, Chloé, Alice est un cycle de longueur 3 : on part d'Alice et on y revient. Ce graphe contient donc au moins un cycle, il n'est pas acyclique.
Un graphe non orienté est connexe s'il existe un chemin entre toute paire de sommets. Autrement dit, on peut atteindre n'importe quel sommet à partir de n'importe quel autre. Les composantes connexes d'un graphe sont ses « morceaux » connexes maximaux.
4.2 Représentation des graphes en Python
Pour manipuler un graphe sur ordinateur, il faut le coder en mémoire. Nous supposerons que les sommets sont numérotés de à (ou identifiés par des chaînes de caractères). Deux représentations dominent : la matrice d'adjacence et les listes d'adjacence.
4.2.1 La matrice d'adjacence
La matrice d'adjacence d'un graphe à sommets numérotés de à est une matrice carrée de taille telle que :
Pour un graphe pondéré, on remplace le par le poids du lien. Pour un graphe non orienté, la matrice est symétrique : .
Voici un petit graphe non orienté à 4 sommets () et aux arêtes , , et , représenté par sa matrice d'adjacence sous forme de liste de listes en Python.
# Matrice d'adjacence d'un graphe non oriente a 4 sommets
M = [
    [0, 1, 1, 0],   # voisins du sommet 0 : 1 et 2
    [1, 0, 1, 0],   # voisins du sommet 1 : 0 et 2
    [1, 1, 0, 1],   # voisins du sommet 2 : 0, 1 et 3
    [0, 0, 1, 0],   # voisins du sommet 3 : 2
]

# Existe-t-il une arete entre 0 et 2 ?
print(M[0][2] == 1)   # True

# Degre du sommet 2 (somme de sa ligne)
print(sum(M[2])) # 3La matrice d'adjacence occupe un espace mémoire de , quel que soit le nombre d'arêtes. Tester l'existence d'un lien entre deux sommets se fait en , mais parcourir tous les voisins d'un sommet coûte . Cette représentation est efficace pour les graphes denses (beaucoup d'arêtes), mais gaspilleuse pour les graphes creux (peu d'arêtes).
4.2.2 Les listes d'adjacence
La représentation par listes d'adjacence associe à chaque sommet la liste de ses voisins. En Python, on l'implémente naturellement avec un dictionnaire dont les clés sont les sommets et les valeurs sont les listes (ou ensembles) de voisins.
Reprenons le même graphe que précédemment avec un dictionnaire.
# Listes d'adjacence d'un graphe non oriente
G = {
    0: [1, 2],
    1: [0, 2],
    2: [0, 1, 3],
    3: [2],
}

# Voisins du sommet 2
print(G[2])           # [0, 1, 3]

# Degre du sommet 2
print(len(G[2]))      # 3

# Existe-t-il une arete entre 0 et 3 ?
print(3 in G[0])      # False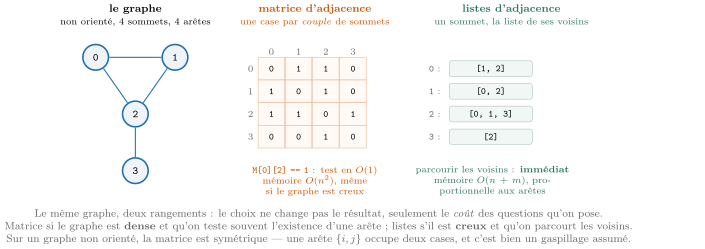
Méthode : Ajouter une arête à un graphe par listes d'adjacence
Pour ajouter une arête dans un graphe non orienté représenté par un dictionnaire, on ajoute chaque sommet à la liste de voisins de l'autre. Pour un graphe orienté, on n'ajoute le lien que dans un seul sens.
def ajouter_arete(G, u, v):
    """Ajoute l'arete {u, v} dans un graphe non oriente."""
    if u not in G:
        G[u] = []
    if v not in G:
        G[v] = []
    G[u].append(v)
    G[v].append(u)

def ajouter_arc(G, u, v):
    """Ajoute l'arc (u, v) dans un graphe oriente."""
    if u not in G:
        G[u] = []
    if v not in G:
        G[v] = []
    G[u].append(v)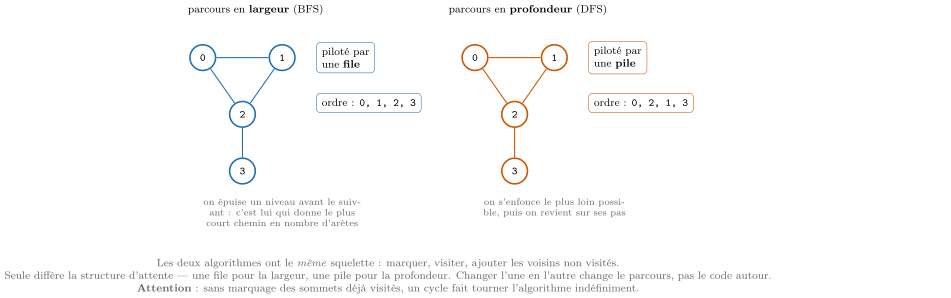
Les listes d'adjacence occupent un espace de , proportionnel au nombre de sommets et de liens. Parcourir tous les voisins d'un sommet coûte , ce qui est optimal. En revanche, tester l'existence d'un lien précis entre deux sommets coûte (parcours de la liste). Cette représentation est privilégiée pour les graphes creux, qui sont les plus fréquents en pratique.
4.3 Le parcours en largeur (BFS)
Parcourir un graphe consiste à visiter tous ses sommets de manière systématique à partir d'un sommet de départ. Le parcours en largeur (en anglais Breadth-First Search, BFS) explore le graphe « par couches » : on visite d'abord le sommet de départ, puis tous ses voisins, puis les voisins des voisins, etc.
Méthode : Algorithme du parcours en largeur
Le BFS utilise une file (structure FIFO, premier entré premier sorti) :
- Marquer le sommet de départ comme visité et l'ajouter à la file.
- Tant que la file n'est pas vide :
- retirer le premier sommet de la file ;
- pour chaque voisin de non encore visité : le marquer comme visité et l'ajouter à la file.
En Python, on utilise collections.deque comme file efficace.
from collections import deque

def bfs(G, depart):
    """Parcours en largeur ; renvoie la liste des sommets dans
    l'ordre de visite."""
    visites = {depart}
    file = deque([depart])
    ordre = []
    while file:
        u = file.popleft()       # retrait en tete (FIFO)
        ordre.append(u)
        for v in G[u]:
            if v not in visites:
                visites.add(v)
                file.append(v)   # ajout en queue
    return ordre

G = {0: [1, 2], 1: [0, 2], 2: [0, 1, 3], 3: [2]}
print(bfs(G, 0)) # [0, 1, 2, 3]Avec une représentation par listes d'adjacence, le BFS visite chaque sommet une fois et chaque lien une fois, d'où une complexité en temps de .
Propriété essentielle : dans un graphe non pondéré, le BFS calcule le plus court chemin (en nombre de liens) du sommet de départ vers tous les autres sommets. C'est pourquoi le BFS est à la base du calcul de distances dans les réseaux sociaux (« degrés de séparation »).
Méthode : BFS calculant les distances
En mémorisant pour chaque sommet sa distance au départ, on obtient les plus courts chemins en nombre d'arêtes.
from collections import deque

def distances_bfs(G, depart):
    """Renvoie un dictionnaire {sommet: distance au depart}."""
    dist = {depart: 0}
    file = deque([depart])
    while file:
        u = file.popleft()
        for v in G[u]:
            if v not in dist:
                dist[v] = dist[u] + 1
                file.append(v)
    return dist
4.4 Le parcours en profondeur (DFS)
Le parcours en profondeur (en anglais Depth-First Search, DFS) explore le graphe en s'enfonçant le plus loin possible le long d'un chemin avant de revenir en arrière (backtracking). Il utilise une pile (structure LIFO), souvent gérée implicitement par la récursivité.
Méthode : Algorithme du parcours en profondeur
Version récursive : pour visiter un sommet , on le marque comme visité, puis on visite récursivement chacun de ses voisins non encore visités. La récursion utilise la pile d'appels du programme comme pile du parcours.
def dfs(G, depart):
    """Parcours en profondeur recursif."""
    visites = set()
    ordre = []

    def explorer(u):
        visites.add(u)
        ordre.append(u)
        for v in G[u]:
            if v not in visites:
                explorer(v)

    explorer(depart)
    return ordre

G = {0: [1, 2], 1: [0, 2], 2: [0, 1, 3], 3: [2]}
print(dfs(G, 0)) # [0, 1, 2, 3]On peut éviter la récursion en gérant explicitement une pile, ce qui évite tout risque de dépassement de la profondeur de récursion sur les très grands graphes.
def dfs_iteratif(G, depart):
    visites = set()
    ordre = []
    pile = [depart]
    while pile:
        u = pile.pop()            # retrait au sommet (LIFO)
        if u not in visites:
            visites.add(u)
            ordre.append(u)
            for v in G[u]:
                if v not in visites:
                    pile.append(v)
return ordreComme le BFS, le DFS visite chaque sommet et chaque lien une seule fois, sa complexité en temps est donc avec des listes d'adjacence. La différence entre BFS et DFS n'est pas la complexité mais l'ordre de visite : largeur (par couches) contre profondeur (en s'enfonçant). Le choix dépend de l'usage : BFS pour les plus courts chemins non pondérés, DFS pour la détection de cycle, le tri topologique ou l'exploration exhaustive.
4.5 Détection de cycle
Détecter la présence d'un cycle est une opération fondamentale : un graphe de dépendances de tâches doit être acyclique pour être ordonnançable, un réseau sans cycle a une structure d'arbre, etc. Les méthodes diffèrent selon que le graphe est orienté ou non.
Méthode : Détection de cycle dans un graphe non orienté
On effectue un DFS en mémorisant pour chaque sommet le sommet parent d'où l'on vient. Si, au cours de l'exploration, on rencontre un voisin déjà visité qui n'est pas le parent, c'est qu'il existe un cycle.
def a_un_cycle_non_oriente(G):
    visites = set()

    def explorer(u, parent):
        visites.add(u)
        for v in G[u]:
            if v not in visites:
                if explorer(v, u):
                    return True
            elif v != parent:
                # voisin deja visite, different du parent : cycle
                return True
        return False

    for sommet in G:
        if sommet not in visites:
            if explorer(sommet, None):
                return True
    return False
On parcourt toutes les composantes connexes pour traiter les graphes non connexes.
Méthode : Détection de cycle dans un graphe orienté
Dans un graphe orienté, l'idée du parent ne suffit pas. On colore chaque sommet selon trois états : blanc (non visité), gris (en cours d'exploration, dans la pile de récursion courante) et noir (totalement exploré). Un arc menant vers un sommet gris (un arc « arrière ») signale un cycle.
def a_un_cycle_oriente(G):
    BLANC, GRIS, NOIR = 0, 1, 2
    couleur = {u: BLANC for u in G}

    def explorer(u):
        couleur[u] = GRIS
        for v in G[u]:
            if couleur[v] == GRIS:
                return True          # arc vers un sommet en cours : cycle
            if couleur[v] == BLANC and explorer(v):
                return True
        couleur[u] = NOIR
        return False

    for sommet in G:
        if couleur[sommet] == BLANC:
            if explorer(sommet):
                return True
return FalseLes deux algorithmes reposent sur un DFS et examinent chaque sommet et chaque lien une fois : leur complexité est donc . La détection s'arrête dès qu'un cycle est trouvé, ce qui peut être plus rapide en pratique.
4.6 Applications
Dans un réseau social, les utilisateurs sont les sommets et les relations d'amitié (ou d'abonnement) sont les liens. Un BFS depuis un utilisateur donne sa distance à tous les autres : c'est la notion de degrés de séparation. La célèbre théorie des « six degrés de séparation » affirme que deux personnes quelconques sont reliées par une chaîne d'au plus six relations. Les suggestions d'amis (« personnes que vous connaissez peut-être ») exploitent souvent les sommets à distance 2, c'est-à-dire les amis d'amis.
Dans un réseau informatique, les routeurs sont les sommets et les liaisons physiques les arêtes, pondérées par un coût (latence, bande passante). Acheminer un paquet d'une machine à une autre revient à trouver un chemin dans ce graphe. Sur un réseau non pondéré, le BFS suffit à trouver la route empruntant le moins de sauts ; sur un réseau pondéré, on emploie des algorithmes de plus court chemin pondéré comme celui de Dijkstra, qui généralisent le BFS.