Diviser pour régner
Cours complet · NSI (terminale), chapitre 6 · terminale, spécialité numérique et sciences informatiques
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
La stratégie diviser pour régner (en anglais divide and conquer) est l'un des grands paradigmes de conception d'algorithmes. Plutôt que d'attaquer un problème de front, on le découpe en sous-problèmes plus petits, de même nature, que l'on résout indépendamment avant de recombiner leurs solutions. Cette idée, déjà présente dans la recherche dichotomique vue en classe de Première, conduit à des algorithmes particulièrement efficaces comme le tri fusion ou le tri rapide.
Dans ce chapitre, nous présentons le principe général, puis nous l'illustrons sur trois algorithmes classiques. Nous analysons leur complexité et nous les comparons aux approches naïves afin de mesurer le gain obtenu.
6.1 Le principe « diviser pour régner »
Un algorithme suit le paradigme diviser pour régner lorsqu'il résout un problème en trois étapes :
- Diviser : découper le problème en un ou plusieurs sous-problèmes de taille plus petite, de même nature ;
- Régner : résoudre chaque sous-problème, le plus souvent de manière récursive ; lorsque la taille devient suffisamment petite, on résout directement (cas de base) ;
- Combiner : assembler les solutions des sous-problèmes pour construire la solution du problème initial.
Méthode : Concevoir un algorithme « diviser pour régner »
Pour appliquer ce paradigme, on se pose systématiquement quatre questions :
- Quel est le cas de base (le plus petit cas, résolu sans récursion) ?
- Comment découper les données en sous-problèmes plus petits ?
- Comment combiner (fusionner) les sous-solutions ?
- La taille décroît-elle strictement à chaque appel, garantissant la terminaison ?
Le caractère récursif de ces algorithmes est essentiel : un problème de taille est ramené à des problèmes de taille (ou ), eux-mêmes ramenés à des problèmes encore plus petits, jusqu'à atteindre le cas de base.
Pour calculer , l'approche naïve effectue multiplications. En remarquant que si est pair, on divise l'exposant par deux à chaque étape.
def puissance(x, n):
    if n == 0:              # cas de base
        return 1
    demi = puissance(x, n // 2)   # diviser + regner
    if n % 2 == 0:
        return demi * demi        # combiner
    else:
        return demi * demi * x
Le nombre de multiplications passe ainsi de à .
6.2 La recherche dichotomique
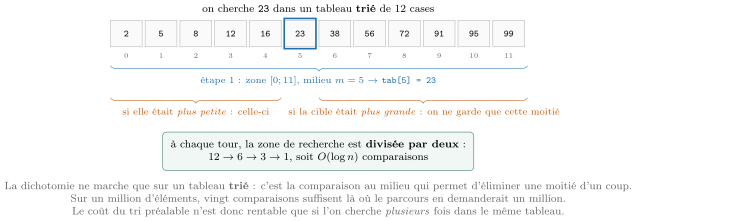
La recherche dichotomique permet de trouver un élément dans un tableau trié bien plus vite qu'une recherche séquentielle.
Soit tab un tableau trié par ordre croissant et cible une valeur recherchée. La recherche dichotomique consiste à comparer cible à l'élément du milieu :
- s'ils sont égaux, l'élément est trouvé ;
- si
cibleest plus petite, on poursuit dans la moitié gauche ; - sinon, on poursuit dans la moitié droite.
À chaque étape, la zone de recherche est divisée par deux : c'est bien une application du paradigme « diviser pour régner ».
def recherche_dichotomique(tab, cible):
    g, d = 0, len(tab) - 1
    while g <= d:
        m = (g + d) // 2
        if tab[m] == cible:
            return m
        elif tab[m] < cible:
            g = m + 1
        else:
            d = m - 1
    return -1   # cible absente
La fonction renvoie l'indice de cible, ou si elle est absente.
La version récursive met en évidence la structure « diviser pour régner ».
def rech_dicho(tab, cible, g, d):
    if g > d:
        return -1            # cas de base : zone vide
    m = (g + d) // 2
    if tab[m] == cible:
        return m
    elif tab[m] < cible:
        return rech_dicho(tab, cible, m + 1, d)   # moitie droite
    else:
return rech_dicho(tab, cible, g, m - 1) # moitie gaucheLa recherche dichotomique sur un tableau de taille s'effectue en comparaisons dans le pire cas, contre pour la recherche séquentielle. En effet, à chaque étape la taille de la zone de recherche est divisée par deux : après étapes il reste environ éléments, et le processus s'arrête lorsque , soit .
6.3 Le tri fusion (merge sort)
Le tri fusion est l'archétype du tri « diviser pour régner ». Il coupe le tableau en deux moitiés, trie chacune récursivement, puis fusionne les deux moitiés triées.
Le tri fusion d'un tableau procède ainsi :
- Diviser : couper le tableau en deux moitiés de tailles (presque) égales ;
- Régner : trier récursivement chacune des deux moitiés ;
- Combiner : fusionner les deux moitiés triées en un seul tableau trié.
Le cas de base est un tableau de zéro ou un élément, déjà trié.
Méthode : Fusionner deux listes triées
La fusion de deux listes triées a et b consiste à parcourir les deux listes simultanément à l'aide de deux indices et à recopier à chaque étape le plus petit des deux éléments courants dans la liste résultat. Lorsqu'une liste est épuisée, on recopie la fin de l'autre. Cette opération est linéaire en la somme des longueurs.
def fusion(a, b):
    res = []
    i, j = 0, 0
    while i < len(a) and j < len(b):
        if a[i] <= b[j]:
            res.append(a[i])
            i += 1
        else:
            res.append(b[j])
            j += 1
    res.extend(a[i:])   # reste de a
    res.extend(b[j:])   # reste de b
    return res

def tri_fusion(tab):
    if len(tab) <= 1:           # cas de base
        return tab
    milieu = len(tab) // 2
    gauche = tri_fusion(tab[:milieu])   # diviser + regner
    droite = tri_fusion(tab[milieu:])
    return fusion(gauche, droite)       # combiner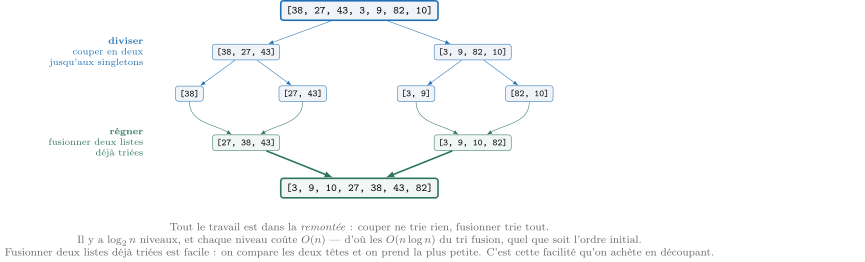
Le tri fusion d'un tableau de taille s'effectue en comparaisons dans tous les cas (meilleur, moyen et pire). En notant le coût du tri, on a la relation
où le terme correspond à la fusion. La récursion comporte niveaux, et chaque niveau effectue un travail total de : d'où le coût . Le tri fusion est stable mais nécessite un espace mémoire supplémentaire en .
Un tri est dit stable s'il préserve l'ordre relatif des éléments de même clé. Grâce au test a[i] <= b[j] (qui privilégie la liste de gauche en cas d'égalité), le tri fusion est stable.
6.4 Le tri rapide (quicksort)
Le tri rapide est un autre tri « diviser pour régner », très efficace en pratique, qui trie le tableau « sur place » autour d'un élément appelé pivot.
Le tri rapide procède ainsi :
- Diviser : choisir un pivot et partitionner le tableau en deux parties, l'une contenant les éléments inférieurs au pivot, l'autre les éléments supérieurs ;
- Régner : trier récursivement chacune des deux parties ;
- Combiner : aucune étape de combinaison n'est nécessaire, car le partitionnement place déjà le pivot à sa position définitive.
La version suivante, lisible mais non « en place », utilise des listes en compréhension.
def tri_rapide(tab):
    if len(tab) <= 1:           # cas de base
        return tab
    pivot = tab[0]
    petits = [x for x in tab[1:] if x <= pivot]   # diviser
    grands = [x for x in tab[1:] if x > pivot]
    return tri_rapide(petits) + [pivot] + tri_rapide(grands)
def partition(tab, g, d):
    pivot = tab[d]
    i = g - 1
    for j in range(g, d):
        if tab[j] <= pivot:
            i += 1
            tab[i], tab[j] = tab[j], tab[i]
    tab[i + 1], tab[d] = tab[d], tab[i + 1]
    return i + 1

def tri_rapide_place(tab, g, d):
    if g < d:
        p = partition(tab, g, d)
        tri_rapide_place(tab, g, p - 1)
tri_rapide_place(tab, p + 1, d)Le tri rapide d'un tableau de taille a une complexité :
- en moyenne , lorsque le pivot partage régulièrement le tableau en deux parties équilibrées ;
- dans le pire cas , lorsque le pivot est systématiquement le plus petit ou le plus grand élément (par exemple sur un tableau déjà trié si l'on choisit toujours le premier élément comme pivot).
Le choix d'un pivot aléatoire ou de la médiane de trois éléments rend le pire cas très improbable. Le tri rapide trie en place avec un faible surcoût mémoire, ce qui le rend souvent plus rapide en pratique que le tri fusion.
6.5 Comparaison avec les approches naïves
Le paradigme « diviser pour régner » améliore nettement la complexité par rapport aux approches naïves :
| Problème | Approche naïve | Diviser pour régner |
|---|---|---|
| Recherche dans un tableau trié | séquentielle | dichotomie |
| Tri | (tri par insertion) | (fusion / rapide) |
| Puissance | exponentiation rapide |
Pour , un tri en demande de l'ordre de opérations, alors qu'un tri en n'en demande qu'environ : le gain est colossal.
import random, time

def tri_insertion(tab):       # approche naive en O(n^2)
    for i in range(1, len(tab)):
        cle = tab[i]
        j = i - 1
        while j >= 0 and tab[j] > cle:
            tab[j + 1] = tab[j]
            j -= 1
        tab[j + 1] = cle

donnees = [random.randint(0, 10000) for _ in range(5000)]

t0 = time.time(); tri_insertion(donnees[:]); t1 = time.time()
t2 = time.time(); tri_fusion(donnees[:]);    t3 = time.time()
print("insertion :", t1 - t0, "s")
print("fusion    :", t3 - t2, "s")
Sur quelques milliers d'éléments, l'écart de temps mesuré illustre concrètement la différence entre et .