Les données en base avec JPA et Spring Data
Cours · Spring Boot : écrire le serveur (école d'ingénieur), chapitre 5 · école d'ingénieur, informatique · le début du chapitre, la suite sur Adloun
Arrêtez le serveur de la Librairie, relancez-le : le livre ajouté par une requête POST a disparu, et le stock revient à sa valeur de départ. Depuis le chapitre 1, le catalogue vit dans une LinkedHashMap, c'est-à-dire dans la mémoire du processus Java : il meurt avec lui. Il ne peut pas non plus être partagé par deux serveurs, ni interrogé autrement que par les méthodes que nous avons écrites (chercher « tous les livres à moins de 10 euros du rayon Littérature » demande d'écrire une boucle de plus).
Une application sérieuse range ses données dans une base de données relationnelle : des tables, des lignes, des colonnes, le langage SQL, et des garanties de durabilité et de cohérence. Reste un écart : nos données sont des objets Java, la base ne connaît que des lignes. Ce chapitre présente l'outil standard qui comble cet écart, JPA, son implémentation Hibernate, et la couche que Spring pose par-dessus, Spring Data JPA, qui écrit pour nous l'essentiel des requêtes. Nous utilisons ici la base H2, qui tourne dans le processus Java lui-même et ne demande aucune installation ; le chapitre 10 passera à PostgreSQL sans changer une ligne de Java.
Objectifs du chapitre
- Expliquer ce qu'est un ORM et ce que font JPA, Hibernate et Spring Data.
- Écrire une entité : identifiant, colonnes, constructeur sans argument.
- Obtenir un dépôt complet en déclarant une simple interface.
- Écrire des requêtes dérivées du nom des méthodes, puis des requêtes JPQL, des projections, une pagination et un tri.
- Lire le SQL qu'émet Hibernate, et comprendre le contexte de persistance (pourquoi une modification est enregistrée sans appel à
save). - Brancher la Librairie sur une base H2, et l'inspecter avec la console H2.
Les exemples des sections 5.1 à 5.6 sont dans le projet code/ch5/demo-jpa : une petite application sans serveur web, qui joue une « étape » choisie au lancement puis s'arrête.
$ cd code/ch5/demo-jpa
$ ./mvnw -q package -DskipTests
$ java -jar target/demo-jpa-0.0.1-SNAPSHOT.jar --demo.etape=2
Toutes les requêtes SQL montrées ont été écrites par Hibernate lui-même lors de ces exécutions.
5.1 Des objets aux tables : l'ORM
Enregistrer un livre en JDBC, l'API de base de Java pour parler à une base, demande d'écrire la requête, de remplir ses paramètres un par un, puis, à la relecture, de recopier chaque colonne dans un objet. Multipliez par le nombre de classes et de requêtes : c'est long, répétitif, et chaque changement de classe oblige à reprendre le SQL.
Un ORM (object-relational mapping, correspondance objet-relationnel) est une bibliothèque qui fait correspondre des classes à des tables et des objets à des lignes. On lui confie des objets ; il écrit et exécute le SQL qui les enregistre, les relit et les modifie.
Trois noms se superposent, qu'il faut savoir distinguer :
- JPA (Jakarta Persistence API) est une spécification : des annotations (
@Entity,@Id…) et des interfaces (EntityManager), dans le paquetjakarta.persistence. Elle dit quoi, pas comment. - Hibernate est l'implémentation de JPA qu'utilise Spring Boot (version 7 ici) : c'est lui qui génère et exécute le SQL.
- Spring Data JPA est une couche de Spring au-dessus de JPA : on déclare une interface de dépôt, Spring en fabrique l'implémentation.
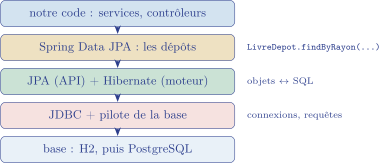
Le starter spring-boot-starter-data-jpa apporte les trois couches, et la dépendance com.h2database:h2 la base. Comme toujours, Spring Boot configure le reste en voyant ces bibliothèques : une source de données (le pool de connexions HikariCP), Hibernate, le gestionnaire de transactions. Avec H2 et sans aucune configuration, il crée même une base en mémoire. Les seules lignes que nous ajoutons fixent son nom et rendent le SQL visible :
spring:
  datasource:
    url: jdbc:h2:mem:demo
  jpa:
    show-sql: true                     # écrire chaque requête SQL sur la console
    properties:
      hibernate.format_sql: false      # une requête par ligne
    defer-datasource-initialization: true   # data.sql APRÈS la création des tables
  main:
    banner-mode: off
    web-application-type: none         # pas de serveur web : un programme qui s'arrête
logging:
  level:
    root: warn
Repère historique : JPA, de Java EE à Jakarta EE
Hibernate est né en 2001, quand les « EJB entités » de Java EE étaient réputées pénibles. Son succès a inspiré la norme JPA, en 2006. En 2017, Oracle a confié Java EE à la fondation Eclipse, qui l'a rebaptisé Jakarta EE ; faute de droits sur le nom « Java », les paquets javax.persistence sont devenus jakarta.persistence. Spring Boot 3 (2022) a fait le saut ; un exemple trouvé en ligne qui importe javax.persistence date donc d'avant, et ne compile plus.
5.2 L'entité : une classe qui devient une table
Une entité est une classe dont les objets sont enregistrés en base. Voici celle de la démonstration :
package fr.librairie.demo;

import jakarta.persistence.Column;
import jakarta.persistence.Entity;
import jakarta.persistence.GeneratedValue;
import jakarta.persistence.GenerationType;
import jakarta.persistence.Id;
import java.math.BigDecimal;

@Entity
public class Livre {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(nullable = false, length = 200)
    private String titre;

    @Column(nullable = false, length = 100)
    private String auteur;

    @Column(nullable = false, length = 50)
    private String rayon;

    @Column(nullable = false, precision = 8, scale = 2)
    private BigDecimal prix;

    protected Livre() {
        // exigé par JPA : Hibernate crée l'objet vide, puis remplit ses champs
    }

    public Livre(String titre, String auteur, String rayon, BigDecimal prix) {
        this.titre = titre;
        this.auteur = auteur;
        this.rayon = rayon;
        this.prix = prix;
    }

    public Long getId() { return id; }
    public String getTitre() { return titre; }
    public String getAuteur() { return auteur; }
    public String getRayon() { return rayon; }
    public BigDecimal getPrix() { return prix; }

    public void changerPrix(BigDecimal nouveauPrix) {
        this.prix = nouveauPrix;
    }

    @Override
    public String toString() {
        return "Livre[" + id + ", " + titre + ", " + prix + " €]";
    }
}- La classe porte
@Entity; par défaut, la table a son nom, converti en minuscules et ensnake_casepar Spring Boot (LigneCommandedevientligne_commande). - Elle a un identifiant marqué
@Id: la clé primaire.@GeneratedValueconfie son choix à la base. - Elle a un constructeur sans argument, au moins
protected: pour relire une ligne, Hibernate crée un objet vide, puis remplit ses champs. - Elle ne peut être ni
final, ni unrecord: les champs d'un record sont définitifs, et Hibernate a besoin de les remplir après la construction. - Chaque champ devient une colonne ;
@Columnen précise le nom, la longueur, la nullité, la précision.
Au démarrage, Hibernate lit les entités et, en mode développement, crée les tables. Le journal le montre :
Hibernate: drop table if exists livre cascade
Hibernate: create table livre (prix numeric(8,2) not null, id bigint generated by default as identity, rayon varchar(50) not null, auteur varchar(100) not null, titre varchar(200) not null, primary key (id))
On y reconnaît chaque décision de la classe : le type varchar(200) not null pour le titre, numeric(8,2) pour le prix (huit chiffres dont deux après la virgule : un montant exact, comme il se doit pour de l'argent, d'où BigDecimal et non double), et generated by default as identity pour l'identifiant : c'est la base qui le numérotera.
Qui crée les tables ?
Avec une base embarquée (H2), Spring Boot règle spring.jpa.hibernate.ddl-auto à create-drop : les tables sont créées au démarrage et détruites à l'arrêt. Pour une vraie base, la valeur par défaut est none. Les autres valeurs sont create, update (Hibernate ajoute ce qui manque) et validate (Hibernate vérifie, sans rien toucher, que les tables correspondent aux entités). En production, on ne laisse jamais Hibernate modifier le schéma : update n'efface pas une colonne renommée, ne migre pas les données, et ne laisse aucune trace de ce qu'il a fait. Le chapitre 10 confie le schéma à des migrations versionnées, et règle Hibernate sur validate (exercice 5.9).
Les données de départ sont dans src/main/resources/data.sql, que Spring Boot exécute au démarrage d'une base embarquée. L'option defer-datasource-initialization le fait passer après la création des tables par Hibernate :
insert into livre (titre, auteur, rayon, prix) values
  ('Programmation Java', 'I. Alame', 'Informatique', 32.00),
  ('Introduction à l''algorithmique', 'T. Cormen et al.', 'Informatique', 89.00),
  ('Analyse MPSI', 'J.-M. Monier', 'Mathématiques', 45.00),
  ('Physique générale', 'H. Benson', 'Physique', 59.00),
  ('Le Petit Prince', 'A. de Saint-Exupéry', 'Littérature', 8.50),
  ('L''Étranger', 'A. Camus', 'Littérature', 7.90);
5.3 Le dépôt : une interface suffit
Au chapitre 2, nous avions écrit une interface de dépôt et son implémentation en mémoire. Avec Spring Data, on n'écrit plus que l'interface :
public interface LivreDepot extends JpaRepository<Livre, Long> {
}
Les deux paramètres de type sont la classe de l'entité et le type de son identifiant. Au démarrage, Spring Data voit cette interface, fabrique une classe qui l'implémente, et en fait un bean injectable. Le journal le signale (ici et dans la suite, les colonnes de date, de niveau et de processus des lignes du journal sont retirées) :
Bootstrapping Spring Data JPA repositories in DEFAULT mode.
Finished Spring Data repository scanning in 16 ms. Found 1 JPA repository interface.
La suite du cours est sur Adloun
Le chapitre en entier, formules et figures comprises, avec le tuteur, les fiches, les QCM et les exercices.
Lire la suite du coursEn accès libre, sans inscription.