informatique (MP2I/MPI) · Chapitre 21 · Exercice de TD
WHERE et HAVING dans la même requête
Bases de données relationnelles et SQL · niveau 2
Énoncé
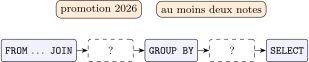
Écrire : « pour la promotion , les élèves ayant au moins deux notes, avec leur moyenne ». Dire quel filtre agit où.
Corrigé
SELECT e.nom, COUNT(*) AS nb, AVG(n.valeur) AS moyenne
FROM Eleve e JOIN Note n ON n.eleve = e.id
WHERE e.promo = 2026            -- sur les LIGNES, avant le regroupement
GROUP BY e.id, e.nom
HAVING COUNT(*) >= 2;           -- sur les PAQUETS, après
Résultat mesuré : Alaoui ( notes, ) et Benali ( notes, ).
Chaque filtre est à sa place, et ne pourrait pas être ailleurs.
| Condition | où | pourquoi |
|---|---|---|
e.promo = 2026 | WHERE | porte sur une colonne de la ligne |
COUNT(*) >= 2 | HAVING | porte sur le paquet, qui n'existe pas avant |
Mettre COUNT(*) >= 2 dans le WHERE est une erreur de syntaxe sur tout moteur : à ce moment de l'évaluation, il n'y a pas de paquet à compter.
Mettre e.promo = 2026 dans le HAVING serait accepté ici — promo figure au GROUP BY par transitivité de e.id — mais c'est une mauvaise idée : le filtre agirait après avoir regroupé toute la table, donc sur des paquets qu'on jette. Le WHERE les écarte avant.
Complexité : Filtrer tôt coûte moins cher
C'est un principe général, et il ne tient pas au langage : le WHERE réduit le volume avant le regroupement, qui est l'opération chère (un tri ou une table de hachage, chapitre chap:hachage). Sur une table de dix millions de lignes dont mille concernent , le WHERE fait travailler le GROUP BY sur mille lignes ; le HAVING le ferait travailler sur dix millions. Même résultat, quatre ordres de grandeur d'écart.
C'est aussi ce que fait l'optimiseur de requêtes tout seul lorsqu'il le peut — mais il ne le peut pas toujours, et l'on n'écrit pas une requête en pariant sur lui.