Listes, statistiques et simulations
Cours complet · algorithmique et programmation (première), chapitre 4 · première, algorithmique et programmation
Travailler ce chapitre sur Adloun
Une série statistique est une liste ; un échantillon simulé aussi. Ce chapitre met les listes au service des chapitres « Probabilités conditionnelles » et « Variables aléatoires » du manuel : calculer les indicateurs, simuler des expériences aléatoires, observer la fluctuation d'échantillonnage, estimer par Monte-Carlo — et analyser les fréquences des lettres d'un texte, l'algorithme du programme.
4.1 Indicateurs d'une série statistique
Méthode : Moyenne, variance, écart type d'une liste
def moyenne(L):
    return sum(L) / len(L)

def variance(L):
    m = moyenne(L)
    return sum([(x - m)**2 for x in L]) / len(L)

def ecart_type(L):
    return variance(L) ** 0.5

notes = [12, 8, 15, 10, 15]
print(moyenne(notes), variance(notes), ecart_type(notes))
# 12.0 7.6 2.756...
La compréhension [(x - m)**2 for x in L] colle à la formule : le code est la définition.
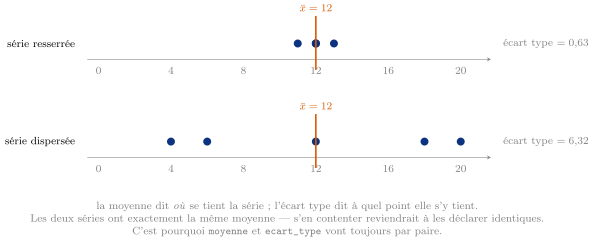
Pourquoi calculer les deux ? Parce que la moyenne seule ne distingue pas ces deux séries :
def mediane(L):
    T = sorted(L)              # copie TRIÉE de L (L n'est pas modifiée)
    n = len(T)
    if n % 2 == 1:
        return T[n // 2]                   # valeur centrale
    return (T[n//2 - 1] + T[n//2]) / 2     # moyenne des deux centrales

def etendue(L):
    return max(L) - min(L)

print(mediane([12, 8, 15, 10, 15]))   # 12
print(mediane([12, 8, 15, 10]))       # 11.0
4.2 Loi d'une variable aléatoire : deux listes
Une loi de probabilité se code naturellement par deux listes parallèles — les valeurs et leurs probabilités, appariées par l'indice :
valeurs = [0, 2, 5]
probas  = [0.2, 0.5, 0.3]        # même longueur, somme 1

def esperance(valeurs, probas):
    E = 0
    for i in range(len(valeurs)):
        E += probas[i] * valeurs[i]
    return E

def variance_loi(valeurs, probas):
    E = esperance(valeurs, probas)
    return sum([probas[i] * (valeurs[i] - E)**2 for i in range(len(valeurs))])

print(esperance(valeurs, probas))       # 2.5
print(variance_loi(valeurs, probas)) # 3.25 -> sigma = 1.803Avant tout calcul, deux vérifications s'imposent — et se codent en une ligne chacune : len(valeurs) == len(probas) et abs(sum(probas) - 1) < 1e-9 (l'égalité exacte à peut échouer avec les flottants : on teste à epsilon près).
4.3 Simuler une variable aléatoire
Méthode
random() renvoie un flottant uniforme dans . Pour simuler une loi quelconque, on découpe en intervalles de longueurs :
from random import random

def simule(valeurs, probas):
    r = random()
    cumul = 0
    for i in range(len(valeurs)):
        cumul += probas[i]
        if r < cumul:              # r est tombé dans le i-ème intervalle
            return valeurs[i]

def echantillon(valeurs, probas, n):
    return [simule(valeurs, probas) for k in range(n)]

E = echantillon([0, 2, 5], [0.2, 0.5, 0.3], 1000)
print(E.count(5) / len(E))   #   0.3 : la fréquence approche la probabilité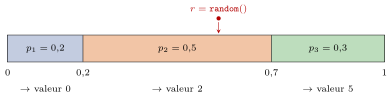
Le segment découpé aux longueurs des probabilités : le tirage uniforme tombe dans l'intervalle de la valeur simulée — ici donne la valeur .
4.4 Fluctuation d'échantillonnage
def moyenne_echantillon(n):
    return moyenne(echantillon([0, 2, 5], [0.2, 0.5, 0.3], n))

# Une liste de 200 moyennes d'échantillons de taille 100 :
M = [moyenne_echantillon(100) for k in range(200)]
print(min(M), max(M))       # par exemple 1.98 et 3.02 : ça fluctue !

# Proportion des moyennes dans [mu - 2s/rac(n), mu + 2s/rac(n)] :
mu, sigma, n = 2.5, 1.803, 100
seuil = 2 * sigma / n**0.5
p = sum([1 for m in M if abs(m - mu) <= seuil]) / len(M)
print(p)                    #   0.95 : la propriété du cours, vérifiée
La compréhension [1 for m in M if …] compte les cas favorables : c'est le motif compter du chapitre 2, version compacte.
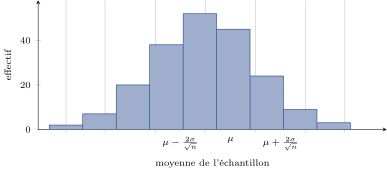
Histogramme des moyennes d'échantillons : elles s'entassent autour de , presque toutes entre — la cloche de la fluctuation d'échantillonnage.
4.5 Monte-Carlo, version compréhensions
L'estimation de du manuel (chapitre Probabilités conditionnelles) tient en deux lignes avec des compréhensions :
from random import random

n = 10**6
points = [(random(), random()) for k in range(n)]
pi_estime = 4 * sum([1 for (x, y) in points if x*x + y*y <= 1]) / n
print(pi_estime)      #   3.1418
La liste points est une liste de couples — le produit cartésien du chapitre de logique, matérialisé. (Pour très grand, on évitera de stocker la liste et l'on comptera au vol, comme au chapitre 1.)
4.6 Fréquences des lettres d'un texte
L'algorithme du programme — et un cas d'école du comptage par liste : on utilise une liste de compteurs, indexée par le rang de la lettre dans l'alphabet (ord(c) - ord("a")). Fidèle à la règle « rien que des listes ».
def frequences_lettres(texte):
    compteurs = [0] * 26                # 26 zéros : un par lettre
    total = 0
    for c in texte.lower():
        i = ord(c) - ord("a")           # rang de la lettre : a -> 0, z -> 25
        if 0 <= i < 26:                 # on ignore espaces, chiffres, accents
            compteurs[i] += 1
            total += 1
    return [compteurs[i] / total for i in range(26)]

francais = frequences_lettres("le petit prince demanda dessine moi un mouton")
lettre_max = francais.index(max(francais))
print(chr(ord("a") + lettre_max))       # 'e' : la lettre reine du français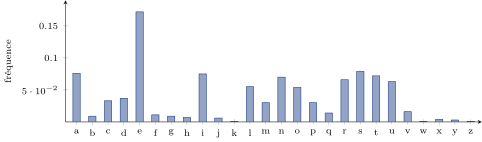
Profil des fréquences du français (grands textes) : le « e » culmine à . En anglais, il ne dépasse pas et le « t » monte à : comparer les profils permet d'identifier la langue d'un texte — et de casser les chiffrements par simple substitution, comme le fit Al-Kindi au IXe siècle.
4.7 Exercices d'entraînement
Difficulté : ★ facile ★ moyen ★ plus difficile.
Exercice
Pour la série [7, 12, 9, 15, 9, 11], calculer à la machine (et vérifier la moyenne à la main) : moyenne, médiane, étendue, écart type.
Solution
Moyenne : . mediane trie en [7, 9, 9, 11, 12, 15] et renvoie . Étendue : . ecart_type donne .
Exercice
Écrire une fonction centrer_reduire(L) qui renvoie la liste des . Vérifier que la liste renvoyée a une moyenne (quasi) nulle et un écart type (quasi) égal à .
Solution
def centrer_reduire(L):
    m, s = moyenne(L), ecart_type(L)
    return [(x - m) / s for x in L]

Z = centrer_reduire([7, 12, 9, 15, 9, 11])
print(moyenne(Z), ecart_type(Z))   #   0.0 (à 1e-16 près) et 1.0
(Les résidus d'ordre sont des arrondis de flottants — d'où les tests « à epsilon près ».)
Exercice
On lance deux dés équilibrés et on note la somme.
- Simuler lancers (liste en compréhension avec
randint). - Construire la liste des fréquences des sommes à et la comparer à la loi théorique du manuel ().
Solution
from random import randint

S = [randint(1, 6) + randint(1, 6) for k in range(10000)]
freq = [S.count(s) / len(S) for s in range(2, 13)]
print(freq[5])    # fréquence de 7 :   0.166 (théorie : 6/36 = 0.1667)
Les onze fréquences dessinent le « toit » symétrique de la loi théorique, à la fluctuation près.
Exercice
Un jeu rapporte € avec probabilité , € avec probabilité , rien sinon ; la mise est €.
- Calculer l'espérance du gain algébrique avec
esperance. - Simuler parties et comparer la moyenne des gains à l'espérance.
Solution
valeurs = [8, 0, -2]            # gains algébriques (recette - mise)
probas  = [0.1, 0.3, 0.6]
print(esperance(valeurs, probas))                     # -0.4
G = echantillon(valeurs, probas, 10000)
print(moyenne(G))                                     #   -0.4
Espérance € : le joueur perd en moyenne centimes par partie, et la simulation le confirme.
Exercice
Reprendre l'expérience de fluctuation du cours avec des tailles d'échantillon , , : pour chaque , calculer l'écart type de la liste des moyennes. Comment cet écart évolue-t-il quand est multiplié par ? Relier au du cours.
Solution
for n in [25, 100, 400]:
    M = [moyenne_echantillon(n) for k in range(200)]
    print(n, ecart_type(M))
# 25    0.36
# 100   0.18
# 400   0.09
Chaque fois que est multiplié par , l'écart type des moyennes est divisé par : il décroît en (ici ), exactement la loi en racine carrée de la propriété du cours.
Exercice
Estimer par Monte-Carlo la probabilité qu'en lançant trois dés, la somme dépasse strictement . Comparer à un calcul exact par triple compréhension :
exact = sum([1 for a in range(1, 7) for b in range(1, 7)
             for c in range(1, 7) if a + b + c > 12]) / 216
Solution
n = 10**5
freq = sum([1 for k in range(n)
            if randint(1,6) + randint(1,6) + randint(1,6) > 12]) / n
print(freq)     #   0.259
print(exact)    # 56/216 = 0.2592...
La triple compréhension énumère les triplets — le produit cartésien — et compte les favorables () : l'exactitude combinatoire contre l'estimation aléatoire, deux méthodes qui se valident mutuellement.
Exercice
Le message suivant a été chiffré en remplaçant chaque lettre par une autre (substitution) : la lettre la plus fréquente du chiffré est « X ». En admettant que le texte d'origine est en français, quelle lettre « X » représente-t-elle probablement ? Écrire une fonction lettre_frequente(texte) qui renvoie la lettre la plus fréquente d'un texte, et expliquer le principe de l'attaque.
Solution
def lettre_frequente(texte):
    F = frequences_lettres(texte)
    return chr(ord("a") + F.index(max(F)))
En français, la lettre dominante est « e » () : « X » chiffre donc probablement « e ». L'analyse de fréquences : la substitution ne change pas les fréquences, seulement les noms des lettres — en appariant le profil du chiffré au profil du français (e, s, a, i, t…), on reconstitue la clé. C'est l'attaque d'Al-Kindi, et la raison pour laquelle la substitution simple n'est plus utilisée.