De la machine de Turing à l'intelligence artificielle
Cours · enseignement scientifique (terminale), chapitre 11 · terminale, enseignement scientifique · le début du chapitre, la suite sur Adloun
11.1 Introduction : une machine peut-elle faire ce qu'on ne lui a pas
appris ?
Une machine à laver exécute un programme de lavage ; elle ne fera jamais le café. Un métier à tisser du début du XIXe siècle reproduit le motif que ses cartes perforées décrivent ; il ne calculera jamais une racine carrée. Pendant des siècles, les machines qui traitent de l'information ont eu ce point commun : chacune ne sait faire qu'une chose, parce que ce qu'elle sait faire est inscrit dans sa mécanique.
En , un mathématicien anglais de vingt-quatre ans, Alan Turing, démontre qu'il peut en aller autrement : il décrit une machine imaginaire d'une simplicité déconcertante, et prouve qu'il en existe une capable de simuler toutes les autres pourvu qu'on lui donne leur description. C'est le concept de machine universelle, que les premiers ordinateurs matérialiseront dix ans plus tard. Si votre téléphone peut à la fois lire de la musique, calculer un itinéraire et traduire un texte, c'est parce qu'il est une machine universelle et que ces trois activités sont, pour lui, trois données différentes.
Ce chapitre suit ce fil, du ruban de Turing jusqu'aux systèmes qui apprennent à partir d'exemples. Il pose trois questions.
- Qu'est-ce qu'une machine qui calcule ? Nous décrirons la machine de Turing avec exactitude, nous la ferons tourner à la main, et nous verrons ce que « le programme est une donnée » veut dire concrètement dans un ordinateur.
- Qu'est-ce qu'apprendre, pour un algorithme ? Le mot est une métaphore et il faut savoir ce qu'il recouvre. Nous distinguerons soigneusement l'apprentissage supervisé et l'apprentissage non supervisé, et nous ferons tourner à la main deux algorithmes d'apprentissage complets.
- Qu'est-ce qui peut mal tourner ? Un bogue, un jeu de données non représentatif, une corrélation prise pour une cause, un test dont on surestime la fiabilité : quatre modes de défaillance normaux, qu'il faut savoir reconnaître.
L'intelligence artificielle est le sujet scientifique sur lequel circule le plus d'affirmations invérifiables — dans les deux sens, celui de la promesse et celui de la catastrophe. Ce chapitre s'en tient donc à une règle stricte : il expose des principes, qui ne vieillissent pas, il ne cite un système particulier que s'il peut le dater, et il ne donne aucun chiffre de performance, puisque ces chiffres changent tous les six mois et dépendent de la tâche exacte sur laquelle on mesure. C'est exactement ce que demande le programme quand il inscrit l'esprit critique parmi les objectifs de l'enseignement scientifique.
11.2 Avant Turing : des machines à une seule tâche
11.2.1 Trois siècles d'automatisation partielle
Jusqu'au début du XXe siècle, les machines traitant l'information étaient limitées à une ou à quelques tâches prédéterminées (tisser grâce à un ruban ou des cartes perforées, trier un jeu de cartes perforées, séparer des cartes selon un critère, sommer des valeurs indiquées sur ces cartes, etc.).
Ces machines n'étaient nullement primitives : certaines étaient d'une grande complexité mécanique et d'une grande fiabilité. Leur limite n'était pas technique, elle était conceptuelle : la tâche était inscrite dans la disposition des engrenages, et changer de tâche voulait dire changer de machine.
- - — Les machines à calculer. Blaise Pascal, âgé de dix-neuf ans, construit une machine à additionner et soustraire pour aider son père dans ses calculs d'impôts : une roue par chiffre, un report automatique de la retenue. Gottfried Wilhelm Leibniz y ajoute en la multiplication et la division ; il est aussi le premier à décrire clairement l'arithmétique binaire, dans un mémoire de — deux siècles et demi avant qu'elle ne devienne l'alphabet des ordinateurs.
- - — Le métier Jacquard. Joseph-Marie Jacquard perfectionne un métier à tisser commandé par une chaîne de cartes perforées : chaque carte décrit une ligne du motif, les trous laissant passer certaines aiguilles. C'est une étape décisive, car le motif n'est plus dans la machine, il est sur un support extérieur qu'on peut remplacer. La machine reste toutefois un métier à tisser : elle ne fera jamais autre chose que du tissu.
- - — La machine analytique et Ada Lovelace. Charles Babbage conçoit — sans jamais la construire — une machine à calculer commandée par cartes perforées, dotée d'une unité de calcul et d'une mémoire séparées, capable de répéter des opérations et de choisir entre deux suites d'actions. En , Ada Lovelace en publie une description accompagnée de notes plus longues que le texte original : la plus longue détaille la marche à suivre pour faire calculer une suite de nombres à la machine, et souligne que celle-ci « n'a nullement la prétention de créer quoi que ce soit » mais seulement d'exécuter ce qu'on sait lui ordonner. La remarque est toujours d'actualité.
- — Les machines de Hollerith. Le recensement américain de avait demandé huit ans de dépouillement ; Herman Hollerith conçoit pour celui de un système de cartes perforées avec perforatrice, trieuse et tabulatrice, qui ramène le dépouillement à quelques années. L'entreprise qu'il fonde deviendra, après plusieurs fusions, la société IBM. C'est le début du traitement industriel de l'information — et de ses questions politiques, car un fichier de population est un instrument de pouvoir.
Méthode : Analyser un document historique sur l'automatisation du traitement de l'information
Devant un texte, une gravure ou un schéma d'une machine ancienne, se poser cinq questions dans l'ordre :
- Quelle est l'information traitée ? Des chiffres, des motifs textiles, des enregistrements de population, des lettres.
- Sous quelle forme est-elle codée ? Position d'une roue, présence ou absence d'un trou, tension électrique. C'est la question centrale : toute machine à information suppose un code.
- Où est inscrite la tâche à effectuer ? Dans la mécanique elle-même, ou sur un support séparé et remplaçable ? C'est ce qui sépare une machine spécialisée d'une machine programmable.
- Qui peut la changer ? Le constructeur seulement, ou l'utilisateur ?
- Qu'est-ce qui a rendu cette machine nécessaire ? Un besoin administratif, commercial, militaire, scientifique. Une machine ne naît jamais seule.
Logique, ordres de grandeur : comparer les durées de traitement avant et après une automatisation donne la mesure du gain.
11.3 La machine de Turing
11.3.1 Ce que Turing cherchait vraiment
Il faut commencer par corriger une idée reçue : Turing n'a pas cherché à inventer l'ordinateur. Il s'attaquait à un problème de logique mathématique posé par David Hilbert, le problème de la décision : existe-t-il une méthode mécanique qui, appliquée à un énoncé mathématique quelconque, dise en un nombre fini d'étapes s'il est démontrable ?
Pour répondre, il fallait d'abord définir ce que « méthode mécanique » veut dire. C'est ce que fait Turing dans son article de : il propose une définition mathématique de ce qu'est un calcul effectué en suivant des règles, sans intelligence ni intuition. Puis il démontre que la réponse à la question de Hilbert est non. La machine universelle, qui allait changer le monde, n'est qu'une étape de cette démonstration.
Une machine de Turing est un objet mathématique, non un appareil. Elle est définie par quatre éléments :
- un ruban illimité, divisé en cases, chacune portant un symbole pris dans un alphabet fini (par exemple , , et le symbole « case vide ») ;
- une tête de lecture et d'écriture, placée sur une case, qui peut lire le symbole de cette case, le remplacer, et se déplacer d'une case vers la gauche ou vers la droite ;
- un état interne, pris dans un ensemble fini d'états ;
- une table de transition qui, pour chaque couple (état courant, symbole lu), indique le symbole à écrire, le sens du déplacement et le nouvel état.
La machine s'arrête lorsqu'elle atteint un état pour lequel la table ne prévoit rien. C'est tout. Il n'y a rien d'autre dans une machine de Turing.
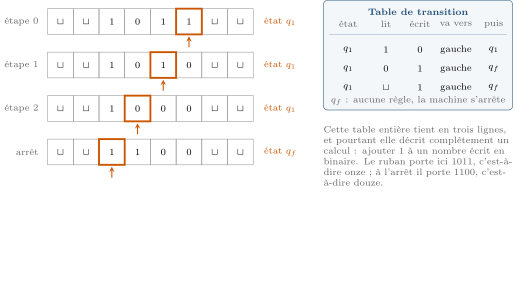
machine ne connaît que deux choses : son état et le symbole de la case encadrée. La table lui dit alors quoi écrire, où aller et dans quel état passer. Aucune vue d'ensemble, aucune mémoire du chemin parcouru : tout ce qu'il faut
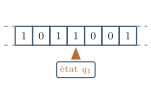
retenir doit être écrit sur le ruban.Reprenons la figure. Le ruban porte et la tête est sur le dernier , dans l'état .
Étape . État , symbole lu . La première ligne de la table s'applique : écrire , aller à gauche, rester en . Le ruban devient .
Étape . État , symbole lu . Même ligne : écrire , aller à gauche, rester en . Le ruban devient .
Étape arrêt. État , symbole lu . Deuxième ligne : écrire , aller à gauche, passer en . Le ruban devient . Aucune règle ne concerne : la machine s'arrête.
Vérification : et . La machine a bien ajouté . Ce que vous venez de faire, c'est exécuter un programme — et vous n'avez, à aucun moment, eu besoin de comprendre ce que le calcul signifiait.
11.3.2 La machine universelle
Une machine de Turing universelle est une machine de Turing particulière qui prend sur son ruban deux choses : la description codée d'une machine quelconque , et la donnée sur laquelle on veut faire travailler . Alors produit exactement le même résultat que appliquée à .
Autrement dit, il n'est pas nécessaire de construire une machine par tâche : une seule machine suffit, à qui l'on fournit la description de la tâche comme une donnée parmi les autres.
Turing a été le premier à proposer le concept de machine universelle, qui a été matérialisé dix ans plus tard avec les premiers ordinateurs. Ceux-ci sont constitués au minimum d'un processeur et d'une mémoire vive.
Les dates concordent : l'article de Turing paraît en ; l'ENIAC, premier grand calculateur électronique polyvalent, est présenté publiquement en février ; le rapport de John von Neumann sur l'EDVAC, en juin , décrit l'architecture où programme et données partagent la même mémoire ; le premier programme enregistré en mémoire est exécuté à Manchester le juin .
Retenez la conséquence : un programme est une donnée. C'est pour cela qu'on peut le stocker sur un disque, l'envoyer par le réseau, le recopier, le modifier, et surtout le traduire — un compilateur est un programme dont la donnée d'entrée est un autre programme. Cette idée, qui paraît banale, était absolument neuve.
Turing démontre dans le même article une limite non moins importante : il n'existe aucune machine capable de dire, pour une machine quelconque et une donnée quelconque, si le calcul finira par s'arrêter. C'est le problème de l'arrêt, et il est indécidable. Cela signifie qu'aucun logiciel ne pourra jamais vérifier automatiquement, dans tous les cas, qu'un programme ne part pas en boucle infinie. Ce n'est pas une question de puissance de calcul : c'est une impossibilité démontrée.
Ce n'est pas un ordinateur, et personne n'en a jamais construit pour calculer : c'est un outil de démonstration mathématique, volontairement dépouillé. Ce n'est pas non plus un modèle du cerveau, ni une machine « lente » : la question du temps de calcul ne se pose pas pour elle. Son intérêt tient à un résultat : tout ce que l'on sait calculer avec un ordinateur d'aujourd'hui peut être calculé par une machine de Turing — plus lentement, mais exactement. La puissance des machines a été multipliée par des milliards depuis ; l'ensemble de ce qu'elles peuvent calculer, lui, n'a pas bougé.
11.4 L'ordinateur : un processeur, une mémoire, et des données
11.4.1 L'architecture minimale
Le processeur exécute les instructions : il lit une instruction en mémoire, l'exécute, passe à la suivante. Il contient une unité de commande, qui décode les instructions, et une unité de calcul, qui effectue les opérations arithmétiques et logiques.
La mémoire vive contient les instructions et les données en cours d'utilisation. Elle est rapide et volatile : son contenu disparaît quand l'alimentation s'arrête.
La mémoire de masse (disque, mémoire flash) conserve les informations en l'absence d'alimentation. Elle est beaucoup plus lente et beaucoup plus grande.
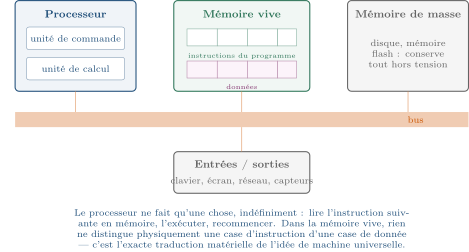
indispensables sont le processeur et la mémoire vive ; tout le reste est du confort, indispensable à l'usage mais pas au concept. Le programme et les
données occupent la même mémoire et voyagent sur le même bus.Un ordinateur peut manipuler des données de natures diverses une fois qu'elles ont été numérisées : textes, images, sons. Les programmes sont également des données : ils peuvent être stockés, transportés et traités par des ordinateurs. En particulier, un programme écrit dans un langage de programmation de haut niveau (Python, Scratch, etc.) peut être traduit en instructions spécifiques à chaque type de processeur.
Un langage de haut niveau est un langage conçu pour être lisible par un être humain : Python, Scratch, Java. Le processeur, lui, ne comprend qu'un jeu d'instructions élémentaires propre à son modèle. Il faut donc traduire, et il y a deux façons de le faire.
La compilation traduit le programme entier, une fois pour toutes, en instructions machine ; on obtient un fichier exécutable, rapide, mais lié à un type de processeur et à un système d'exploitation.
L'interprétation traduit et exécute instruction par instruction, au moment de l'exécution ; le programme reste un simple fichier de texte, transportable partout où l'interpréteur existe, mais s'exécute plus lentement. Python fonctionne principalement ainsi.
Méthode : Distinguer un fichier exécutable des autres fichiers
- Regarder ce que dit le système d'exploitation, pas seulement le nom. Sous Windows, les fichiers
.exe,.bat,.msisont exécutables ; sous macOS, ce sont les paquets.app; sous GNU/Linux, l'exécutabilité n'est pas une extension mais une permission attachée au fichier, que l'on voit avec la commandels -lsous la forme d'unx. - Se rappeler qu'un document peut contenir du code. Un classeur de tableur avec macros, un document de traitement de texte, un fichier PDF peuvent embarquer des instructions. La frontière entre « document » et « programme » est moins nette qu'il n'y paraît.
- Se méfier de l'extension affichée. Un système qui masque les extensions connues peut présenter
photo.jpg.execommephoto.jpg. C'est un procédé classique de diffusion de logiciels malveillants. - Conclure sur la conséquence pratique : ouvrir un document, c'est le lire ; exécuter un fichier, c'est lui confier les commandes de la machine, avec vos propres droits.
11.5 Tout numériser : bits, octets et ordres de grandeur
11.5.1 Le codage
Un bit est la plus petite quantité d'information : le choix entre deux possibilités, notées et . Un octet est un groupe de bits ; il permet donc combinaisons différentes. Les multiples usuels sont le kilooctet ( ko octets), le mégaoctet (), le gigaoctet () et le téraoctet ().
Attention : l'informatique emploie parfois des multiples de plutôt que de , notés alors kio, Mio, Gio. C'est la raison pour laquelle un disque vendu pour To affiche environ Gio une fois branché : rien n'a été volé, ce sont deux comptages différents.
Méthode : Calculer la taille d'un fichier et situer un ordre de grandeur
- Compter les caractères, espaces et retours à la ligne compris. Pour une page dactylographiée ordinaire : environ lignes de caractères, soit caractères.
- Multiplier par la taille d'un caractère. En codage ASCII, non compressé, chaque caractère occupe un octet. La page pèse donc environ octets, soit ko.
- Vérifier l'ordre de grandeur : une page à ko, un livre de pages à ko. Le texte est, de très loin, le contenu le plus léger.
- Signaler les hypothèses. L'ASCII ne code que caractères et ignore les accents ; en UTF-8, les caractères accentués occupent deux octets, ce qui alourdit un texte français d'environ . Et un fichier de traitement de texte contient bien davantage que le texte : mise en forme, polices, historique.
- Pour une image, un son ou une vidéo, retenir les ordres de grandeur de la figure ci-dessous plutôt qu'une formule : photographie quelques Mo ; minute de son compressé Mo, non compressé Mo ; heure de vidéo compressée quelques Go. Une seconde de son non compressé se calcule directement : .
Ordres de grandeur, proportionnalité, puissances de .
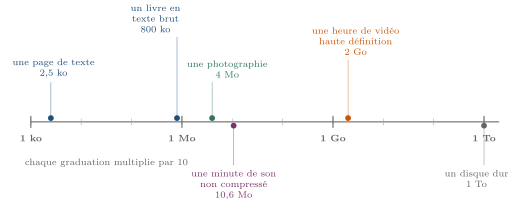
où chaque graduation multiplie la taille par dix. Un livre entier en texte brut pèse moins qu'une seule photographie, et une heure de vidéo pèse mille fois plus qu'un livre. Cette hiérarchie explique à elle seule la structure des réseaux et
le coût de leur usage.11.6 Les bogues
Un programme peut comporter jusqu'à plusieurs centaines de millions de lignes de code, ce qui rend très probable la présence d'erreurs appelées bogues (ou bugs). Ces erreurs peuvent conduire un programme à avoir un comportement inattendu et entraîner des conséquences graves.
Un système d'exploitation courant compte plusieurs dizaines de millions de lignes, et le logiciel embarqué d'une automobile récente se chiffre en dizaines, voire en centaines de millions. Aucune relecture humaine ne peut couvrir de tels volumes, et le problème de l'arrêt interdit d'espérer un vérificateur automatique universel.