SQL : jointures, agrégation et requêtes imbriquées
Cours complet · informatique (tronc commun des prépas scientifiques), chapitre 16 · prépas scientifiques, tronc commun
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
<i class="fa-solid fa-compass mr-2" style="color:#9A563B"></i>16.1 Introduction et motivation
Le chapitre 15 a séparé pour bien ranger : les auteurs d'un côté, les livres de l'autre, les emprunts dans leur table d'association — chaque fait en un seul endroit. Mais les questions, elles, ignorent les frontières : « qui a emprunté Guerre et paix ? » traverse trois tables. Il faut donc l'opération inverse de la séparation : la jointure, qui recolle les tables le long de leurs clés — née au chapitre précédent du produit cartésien filtré, elle reçoit ici sa syntaxe officielle et ses usages, jusqu'à l'autojointure d'une table avec elle-même.
Deuxième puissance de SQL : compter, sommer, moyenner — l'agrégation. Une médiathèque ne veut pas la liste des emprunts, elle veut le palmarès des livres, le total par usager, la moyenne par auteur : les fonctions COUNT, SUM, AVG, MIN, MAX, démultipliées par GROUP BY qui calcule par groupe, et filtrées par HAVING — le WHERE des groupes. Avec les requêtes imbriquées en clef de voûte, ce chapitre complète la panoplie SQL du programme : de quoi poser à une base à peu près n'importe quelle question raisonnable — en trois lignes déclaratives.
16.2 La jointure interne
16.2.1 Recoller ce que la modélisation a séparé
La jointure interne de deux tables s'écrit
SELECT ... FROM t1 JOIN t2 ON conditionet produit toutes les combinaisons d'une ligne de t1 et d'une ligne de t2 qui satisfont la condition — exactement le produit cartésien filtré de l'exercice 8 du chapitre 15, en mieux dit. Conformément au programme, la condition est une équi-jointure : une conjonction d'égalités, presque toujours « clé étrangère clé primaire » :
SELECT titre, nom, annee
FROM livre JOIN auteur ON livre.id_auteur = auteur.id_auteur
WHERE naissance = 1828
ORDER BY annee;
De la Terre à la Lune            | Verne   | 1865
Guerre et paix                   | Tolstoï | 1869
Vingt mille lieues sous les mers | Verne   | 1870
Michel Strogoff                  | Verne   | 1876
Anna Karénine                    | Tolstoï | 1877
Les cinq livres des deux auteurs nés en . La condition du ON apparie chaque livre à son auteur ; le WHERE peut alors mêler librement des attributs des deux tables — la ligne jointe les porte tous.
Méthode : Vérifier une sortie de jointure à la main
Trois contrôles mécaniques, ligne par ligne, comme on déroulait les boucles du chapitre 1 : (1) chaque ligne du résultat satisfait-elle le ON (le bon auteur sur le bon livre) ? (2) le WHERE (ici : Orgueil et préjugés, Austen , doit être absent) ? (3) l'ORDER BY ( en tête) ? Et un quatrième, global : le compte — une jointure clé étrangère clé primaire rend exactement une ligne par ligne de la table côté qui passe les filtres (chapitre 15, exercice 8). Tout résultat de jointure qui surprend par sa taille — surtout en trop — trahit presque toujours une condition de ON incomplète : le fantôme du produit cartésien.
« Qui a emprunté quoi, et quand ? » traverse usager, emprunt et livre — on joint de proche en proche, en suivant les flèches de clés étrangères du schéma :
SELECT usager.nom, livre.titre, emprunt.jour
FROM emprunt
     JOIN usager ON emprunt.id_usager = usager.id_usager
     JOIN livre  ON emprunt.id_livre  = livre.id_livre
WHERE jour >= '2025-10-01'
ORDER BY jour;
Chloé | Le Blé en herbe | 2025-10-01
Chloé | Anna Karénine   | 2025-10-02
Bruno | Michel Strogoff | 2025-10-05
Emma  | Guerre et paix  | 2025-10-06
Alice | Orgueil et préjugés | 2025-10-08
La table d'association est le pivot : chaque ligne d'emprunt attrape son usager d'un côté, son livre de l'autre. Les préfixes usager.nom, livre.titre lèvent les ambiguïtés ; on peut abréger avec des alias de table : FROM emprunt AS e JOIN usager AS u ON e.id_usager = u.id_usager.
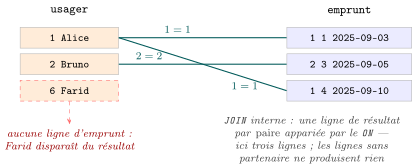
Interne signifie : une ligne sans partenaire disparaît du résultat. Farid (jamais d'emprunt) est absent de toute jointure passant par emprunt ; Les Vrilles de la vigne (jamais emprunté) aussi. Conséquence sournoise sur les statistiques : « le nombre d'emprunts par usager » calculé à travers cette jointure omet les zéros — Farid n'y a pas zéro emprunt, il n'y est pas du tout. Quand les absents comptent, il faut les réintroduire (l'EXCEPT du chapitre 15, ou les jointures externes — hors programme, mais leur raison d'être est maintenant claire).
16.2.2 L'autojointure
Rien n'interdit de joindre une table avec elle-même — à condition de la renommer pour distinguer ses deux exemplaires :
SELECT a1.nom, a2.nom
FROM auteur AS a1 JOIN auteur AS a2 ON a1.naissance = a2.naissance
WHERE a1.id_auteur < a2.id_auteur;
Verne | TolstoïLes paires d'auteurs nés la même année. Le filtre a1.id_auteur < a2.id_auteur élimine deux parasites du produit : les paires d'un auteur avec lui-même (, toujours nés la même année !) et les doublons symétriques (Verne–Tolstoï et Tolstoï–Verne) — c'est très exactement l'astuce du comptage de triangles (chapitre 12, exercice 7), revenue par la fenêtre SQL.
16.3 L'agrégation
16.3.1 Résumer une table en un nombre
Une fonction d'agrégation avale une colonne de valeurs et rend une valeur : COUNT (effectif), SUM (somme), AVG (moyenne), MIN et MAX. Employées dans le SELECT, elles font s'effondrer le résultat en une seule ligne :
SELECT COUNT(*), SUM(pages), AVG(pages), MIN(annee), MAX(annee)
FROM livre;
8 | 4608 | 576.0 | 1813 | 1923COUNT() compte les lignes ; COUNT(attribut) compte les valeurs de l'attribut — pour nous, c'est pareil (la distinction n'a d'intérêt qu'avec les valeurs manquantes, hors programme). Les agrégats se combinent au WHERE, qui filtre avant* le calcul :
SELECT COUNT(*) AS nb, AVG(pages) AS moyenne
FROM livre WHERE id_auteur = 1;
3 | 426.66666666666...16.3.2 Agréger par groupe : GROUP BY
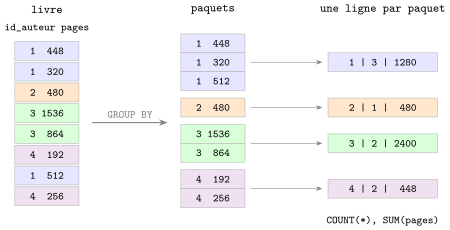
La clause GROUP BY expr partage les lignes en groupes — un par valeur de l'expression — et applique les agrégats à chaque groupe : le résultat a une ligne par groupe.
SELECT id_auteur, COUNT(*) AS nb_livres, SUM(pages) AS total
FROM livre
GROUP BY id_auteur
ORDER BY nb_livres DESC, id_auteur;
1 | 3 | 1280
3 | 2 | 2400
4 | 2 |  448
2 | 1 |  480
La règle d'or (SQL99) : dans le SELECT d'une requête à GROUP BY, chaque colonne est soit dans le GROUP BY, soit sous un agrégat. Écrire SELECT titre, COUNT() … GROUP BY id_auteur est un non-sens : le groupe de Verne contient trois* titres — lequel afficher ? La règle interdit la question.
Le palmarès lisible exige les noms : on joint d'abord, on groupe ensuite.
SELECT nom, COUNT(*) AS nb_emprunts
FROM emprunt JOIN usager ON emprunt.id_usager = usager.id_usager
GROUP BY usager.id_usager, nom
ORDER BY nb_emprunts DESC, nom;
Alice | 3
Chloé | 3
Bruno | 2
David | 1
Emma  | 1
Grouper par id_usager (la clé !) plutôt que par nom seul prémunit contre les homonymes — deux Alices distinctes feraient deux groupes, comme il se doit ; le nom accompagne dans le GROUP BY pour avoir le droit d'être projeté. Et Farid manque à l'appel : jointure interne (le piège du cours — son zéro n'existe pas dans emprunt).
16.3.3 Filtrer les groupes : HAVING
WHERE filtre les lignes, avant la formation des groupes ; HAVING filtre les groupes, après le calcul des agrégats — c'est le seul endroit où une condition peut porter sur un agrégat :
SELECT id_auteur, COUNT(*) AS nb
FROM livre
GROUP BY id_auteur
HAVING COUNT(*) >= 2;
1 | 3
3 | 2
4 | 2
Les auteurs d'au moins deux livres — la condition COUNT() >= 2 n'a aucun sens ligne à ligne, elle n'existe qu'à l'échelle du groupe : WHERE COUNT() >= 2 est rejeté par le moteur.
Méthode : L'ordre logique d'une requête
Une requête complète s'évalue conceptuellement dans cet ordre — qui n'est pas l'ordre d'écriture :
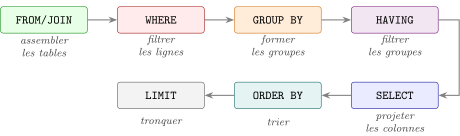
D'abord assembler les tables, puis filtrer les lignes, puis former les groupes, puis filtrer les groupes, puis projeter, enfin trier et tronquer. Pour écrire une requête, suivre ce fil dans l'ordre ; pour déboguer, le remonter — et pour choisir entre WHERE et HAVING, une seule question : la condition parle-t-elle d'une ligne, ou d'un groupe ?
16.4 Les requêtes imbriquées
Une requête peut s'employer à l'intérieur d'une autre — entre parenthèses — partout où sa valeur a un sens. Le cas le plus utile : la sous-requête scalaire (un résultat d'une ligne et une colonne), comparable comme un nombre :
SELECT titre, pages
FROM livre
WHERE pages > (SELECT AVG(pages) FROM livre);
Guerre et paix | 1536
Anna Karénine  |  864
« Plus long que la moyenne » : impossible en un seul SELECT plat — la moyenne () doit être calculée avant de servir de seuil. La sous-requête s'évalue d'abord, sa valeur remplace la parenthèse, la requête externe s'exécute ensuite : une composition de fonctions, au sens du cours de mathématiques.
Quel auteur a écrit le livre le plus ancien ? Le réflexe MIN jointure :
SELECT nom, titre, annee
FROM livre JOIN auteur ON livre.id_auteur = auteur.id_auteur
WHERE annee = (SELECT MIN(annee) FROM livre);
Austen | Orgueil et préjugés | 1813Noter que SELECT nom, MIN(annee) sans sous-requête serait un contresens (la règle d'or : nom ni groupé ni agrégé) — le superlatif « le … le plus … » se dit en SQL par l'égalité avec une sous-requête agrégée, et cette tournure rend aussi tous les ex æquo, ce qui est la bonne réponse quand le minimum est atteint deux fois.
<i class="fa-solid fa-dumbbell mr-2" style="color:#2E7559"></i>16.5 Exercices résolus
Niveau (Application directe du cours)
Écrire et exécuter : (a) chaque titre avec le nom de son auteur, par année croissante ; (b) les titres empruntés par Alice (id_usager ) ; (c) les noms des usagers ayant emprunté un livre de Tolstoï.
Démonstration (Solution)
SELECT titre, nom FROM livre                                        -- (a)
JOIN auteur ON livre.id_auteur = auteur.id_auteur ORDER BY annee;

SELECT titre FROM emprunt                                           -- (b)
JOIN livre ON emprunt.id_livre = livre.id_livre
WHERE id_usager = 1;

SELECT DISTINCT usager.nom FROM emprunt                             -- (c)
JOIN usager ON emprunt.id_usager = usager.id_usager
JOIN livre  ON emprunt.id_livre  = livre.id_livre
WHERE livre.id_auteur = 3;
(a) Huit lignes, d'Orgueil et préjugés () au Blé en herbe (). (b) Vingt mille lieues sous les mers, Guerre et paix, Orgueil et préjugés. (c) Alice et Emma (Guerre et paix), Chloé (Anna Karénine) — le DISTINCT protège du doublon si quelqu'un empruntait deux Tolstoï. (Chaque jointure suit une flèche du schéma : avant d'écrire, tracer le chemin de tables qui mène des données dont on dispose à celles qu'on veut — ici ; une requête à jointures se planifie comme un itinéraire, chapitre 14.)
Calculer en une requête chacun : (a) le nombre d'usagers ; (b) le nombre d'emprunts d'octobre ; (c) l'année moyenne de parution des livres de Verne ; (d) le nombre de pages du plus gros livre emprunté en septembre.
Démonstration (Solution)
SELECT COUNT(*) FROM usager;                                        -- (a) 6
SELECT COUNT(*) FROM emprunt WHERE jour >= '2025-10-01';            -- (b) 5
SELECT AVG(annee) FROM livre WHERE id_auteur = 1;                   -- (c) 1870.33...
SELECT MAX(pages) FROM emprunt                                      -- (d)
JOIN livre ON emprunt.id_livre = livre.id_livre
WHERE jour <= '2025-09-30';                                         --     1536
(b) profite du format de dates : octobre « après le 1er octobre », aucune fonction calendaire requise. (d) compose tout le chapitre en une ligne : jointure (pour avoir les pages), filtre (septembre), agrégat (MAX). (Vérifier (d) à la main : cinq emprunts de septembre, livres , pages — maximum ✓ ; sur une base-jouet, l'agrégat se contrôle par énumération, et c'est tout l'intérêt pédagogique des bases-jouets.)
(a) Le nombre d'usagers par ville. (b) Le nombre d'emprunts par jour, trié par jour. (c) Pour chaque auteur (par identifiant), l'année de son livre le plus récent.
Démonstration (Solution)
SELECT ville, COUNT(*) FROM usager GROUP BY ville;                  -- (a)
SELECT jour, COUNT(*) FROM emprunt GROUP BY jour ORDER BY jour;     -- (b)
SELECT id_auteur, MAX(annee) FROM livre GROUP BY id_auteur;         -- (c)
(a) Lyon , Nantes , Paris — l'égalité parfaite, qui se voit d'un coup d'œil là où la table brute la cachait. (b) Dix jours, un emprunt chacun : un GROUP BY peut rendre des groupes de taille , et ce n'est pas une erreur. (c) Verne , Austen , Tolstoï , Colette . (Relire (c) avec la règle d'or : id_auteur est groupé, MAX(annee) agrégé — licite ; ajouter titre pour savoir quel livre serait illicite, et c'est l'objet de l'exercice 7.)
Niveau (Application avec raisonnement intermédiaire)
Établir le nombre d'emprunts de chaque livre (titre, effectif), du plus emprunté au moins emprunté. Quels livres manquent au tableau, pourquoi, et comment les recenser quand même ?
Démonstration (Solution)
SELECT titre, COUNT(*) AS nb
FROM emprunt JOIN livre ON emprunt.id_livre = livre.id_livre
GROUP BY livre.id_livre, titre
ORDER BY nb DESC, titre;
Guerre et paix                   | 2
Orgueil et préjugés              | 2
Vingt mille lieues sous les mers | 2
Anna Karénine                    | 1
De la Terre à la Lune            | 1
Le Blé en herbe                  | 1
Michel Strogoff                  | 1
Sept lignes pour huit livres : Les Vrilles de la vigne, jamais emprunté, n'a aucune ligne dans emprunt — la jointure interne l'efface, lui et son zéro (le piège du cours, en chair et en os). Pour le recenser : l'EXCEPT du chapitre 15 (SELECT id_livre FROM livre EXCEPT SELECT id_livre FROM emprunt) en requête d'appoint — le tableau de bord complet est en deux requêtes, et l'honnêteté consiste à publier les deux. (Tout classement « par nombre de » construit sur une table d'association a ce angle mort ; les sondages, les statistiques de ventes, les comptages de citations aussi — savoir demander « et qui est à zéro ? » est une compétence d'analyste, pas de syntaxe.)
Sur la table emprunt jointe à usager : écrire (a) le nombre d'emprunts par usager ; (b) le nombre d'emprunts d'octobre par usager ; (c) les usagers ayant fait au moins emprunts ; (d) les usagers ayant fait au moins emprunts en octobre. Identifier, pour chacune, ce qui relève de WHERE et de HAVING.
Démonstration (Solution)
SELECT nom, COUNT(*) AS nb FROM emprunt                             -- (a)
JOIN usager ON emprunt.id_usager = usager.id_usager
GROUP BY usager.id_usager, nom;

-- (b) : ajouter  WHERE jour >= '2025-10-01'           (filtre de lignes)
-- (c) : ajouter  HAVING COUNT(*) >= 2                 (filtre de groupes)
-- (d) : ajouter  les deux clauses à la fois
Résultats : (a) Alice , Bruno , Chloé , David , Emma ; (b) Alice , Bruno , Chloé , Emma — David disparaît (aucune ligne d'octobre) ; (c) Alice, Bruno, Chloé — David et Emma disparaissent (leur groupe échoue) ; (d) Chloé seule. La grammaire est limpide : « emprunts d'octobre » qualifie chaque ligne WHERE ; « au moins 2 » qualifie le total d'un groupe HAVING. (Le contresens classique — WHERE après coup sur l'agrégat ou HAVING sur une condition de ligne — produit au mieux une erreur, au pire un résultat faux-plausible ; en cas de doute, rejouer l'ordre logique de la méthode du cours : le WHERE s'exécute avant que les groupes n'existent.)
(a) Les paires de livres du même auteur (titres, sans doublon ni paire d'un livre avec lui-même). (b) Les paires d'usagers de la même ville. (c) Les livres parus la même année qu'un livre d'un autre auteur — y en a-t-il ?
Démonstration (Solution)
SELECT l1.titre, l2.titre FROM livre AS l1                          -- (a)
JOIN livre AS l2 ON l1.id_auteur = l2.id_auteur
WHERE l1.id_livre < l2.id_livre;

SELECT u1.nom, u2.nom FROM usager AS u1                             -- (b)
JOIN usager AS u2 ON u1.ville = u2.ville
WHERE u1.id_usager < u2.id_usager;

SELECT l1.titre, l2.titre, l1.annee FROM livre AS l1                -- (c)
JOIN livre AS l2 ON l1.annee = l2.annee
WHERE l1.id_auteur <> l2.id_auteur AND l1.id_livre < l2.id_livre;
(a) Cinq paires : trois chez Verne (), une chez Tolstoï, une chez Colette. (b) Alice–Chloé, Bruno–Emma, David–Farid. (c) Résultat vide : aucune année ne porte deux livres d'auteurs différents dans notre base — et une requête au résultat vide est une réponse, pas un échec (le « zéro ligne » se lit : « la situation décrite n'existe pas »). (Compter avant d'exécuter, à la : l'autojointure filtrée par < rend exactement les paires non ordonnées — le lien combinatoire rend les vérifications immédiates, et un compte inattendu signale presque toujours un < oublié : paires doublées, ou diagonale parasite.)
Pour chaque auteur, on veut le titre de son livre le plus récent. (a) Montrer que SELECT nom, titre, MAX(annee) … GROUP BY nom viole la règle d'or, et expliquer ce qu'un moteur laxiste rendrait. (b) Construire la solution légale avec une autojointure de livre sur sa propre agrégation (sous-requête dans le FROM ou comparaison par couple) — au programme : une sous-requête par auteur dans le WHERE.
Démonstration (Solution)
(a) titre n'est ni dans le GROUP BY ni agrégé : pour le groupe Verne, trois titres candidats, la requête est ambiguë — SQL99 la rejette. Les moteurs laxistes (certains, hors norme) rendent un titre arbitraire du groupe, pas forcément celui de l'année maximale : le pire des comportements, plausible et faux (le LIMIT sans ORDER BY du chapitre 15, en pire). (b) La tournure légale : garder les livres dont l'année égale le maximum de leur propre auteur —
SELECT nom, titre, annee
FROM livre AS l JOIN auteur ON l.id_auteur = auteur.id_auteur
WHERE annee = (SELECT MAX(annee) FROM livre AS l2
               WHERE l2.id_auteur = l.id_auteur);
Verne   | Michel Strogoff     | 1876
Austen  | Orgueil et préjugés | 1813
Tolstoï | Anna Karénine       | 1877
Colette | Le Blé en herbe     | 1923
La sous-requête est corrélée : elle mentionne l.id_auteur, la ligne en cours d'examen — elle se réévalue pour chaque ligne, comme une fonction appelée dans une boucle. (C'est la requête la plus subtile du chapitre, et un grand classique d'épreuve ; la retenir comme un schéma : « le superlatif par groupe égalité avec l'agrégat corrélé » — et noter qu'elle rend tous les ex æquo, le bon comportement.)
Niveau (Raisonnement subtil ou plusieurs étapes)
Quelles villes totalisent au moins emprunts ? Construire la requête pas à pas selon l'ordre logique (jointures nécessaires, filtre, groupe, filtre de groupe, projection, tri), donner le résultat, et vérifier à la main.
Démonstration (Solution)
Le chemin : l'emprunt connaît l'usager, l'usager connaît la ville — deux tables suffisent. Puis grouper par ville, sommer les lignes, filtrer les groupes :
SELECT ville, COUNT(*) AS nb
FROM emprunt JOIN usager ON emprunt.id_usager = usager.id_usager
GROUP BY ville
HAVING COUNT(*) >= 3
ORDER BY nb DESC;
Lyon  | 6
Paris | 3
Vérification manuelle : Lyon Alice () Chloé () ✓ ; Paris Bruno () Emma () ✓ ; Nantes David () Farid () , éliminé par le HAVING — et noter que le zéro de Farid, invisible dans la jointure, n'a ici aucune conséquence : il ne manquait que pour les classements par usager, pas pour les totaux par ville (l'absence d'une ligne nulle ne fausse pas une somme). (Ce distinguo — quand l'angle mort de la jointure interne est inoffensif et quand il est fatal — est le genre de raisonnement qui sépare l'utilisateur du concepteur de requêtes : toujours se demander qui devrait être là avec un zéro, et si ce zéro change la réponse.)
(a) Calculer la moyenne globale des pages des livres, puis la moyenne par auteur, puis la moyenne de ces moyennes (à la main, à partir du résultat GROUP BY). (b) Les deux nombres diffèrent : expliquer pourquoi, dire lequel répond à « combien de pages fait un livre typique ? » et lequel à « quel est le volume typique d'une œuvre d'auteur ? ». (c) Quand coïncideraient-ils ?
Démonstration (Solution)
(a) Globale : . Par auteur : Verne ; Austen ; Tolstoï ; Colette . Moyenne des moyennes : . (b) La moyenne globale pondère chaque livre également ; la moyenne des moyennes pondère chaque auteur également — les trois livres de Verne, courts, pèsent de la première et de la seconde. « Un livre typique » : la globale. « Une œuvre d'auteur typique » : celle des moyennes. Les deux questions sont légitimes ; les confondre est l'erreur statistique la plus répandue de la presse (le « salaire moyen par entreprise » moyenné sur les entreprises, où la PME de trois personnes pèse autant que la multinationale). (c) Si tous les groupes ont le même effectif — ou si toutes les moyennes de groupes sont égales. (SQL exécute docilement les deux calculs : c'est l'analyste qui choisit la pondération en choisissant son GROUP BY — l'agrégation n'est pas neutre, et la requête est déjà une décision de modélisation, chapitre 4 : la moyenne n'a de sens qu'accompagnée de ce sur quoi elle moyenne.)
Livrer le rapport mensuel en cinq requêtes commentées : (1) volume — nombre d'emprunts du mois d'octobre ; (2) palmarès — les livres les plus empruntés (toutes dates) avec leurs auteurs ; (3) fidélité — les usagers au-dessus de la moyenne d'emprunts par emprunteur ; (4) alerte — les livres jamais empruntés ; (5) démographie — le nombre d'emprunteurs distincts par ville, villes sans emprunteur comprises. Pour chaque requête : le résultat, et la subtilité qu'elle illustre.
Démonstration (Solution)
SELECT COUNT(*) FROM emprunt WHERE jour >= '2025-10-01';            -- (1) 5

SELECT titre, nom, COUNT(*) AS nb                                   -- (2)
FROM emprunt
JOIN livre  ON emprunt.id_livre  = livre.id_livre
JOIN auteur ON livre.id_auteur = auteur.id_auteur
GROUP BY livre.id_livre, titre, nom
ORDER BY nb DESC, titre LIMIT 3;

SELECT nom, COUNT(*) AS nb                                          -- (3)
FROM emprunt JOIN usager ON emprunt.id_usager = usager.id_usager
GROUP BY usager.id_usager, nom
HAVING COUNT(*) > 2.0;        -- la moyenne 10/5 = 2, calculée en (3')

SELECT id_livre FROM livre EXCEPT SELECT id_livre FROM emprunt;     -- (4) 8

SELECT ville, COUNT(DISTINCT emprunt.id_usager) AS emprunteurs      -- (5)
FROM usager JOIN emprunt ON emprunt.id_usager = usager.id_usager
GROUP BY ville;
(2) Guerre et paix (Tolstoï), Orgueil et préjugés (Austen), Vingt mille lieues (Verne) — emprunts chacun, le ORDER BY total (titre en second critère) rend le podium reproductible malgré les ex æquo. (3) Alice et Chloé () ; en toute rigueur le seuil devrait être une sous-requête (la moyenne des effectifs par emprunteur), que la norme autorise mais qu'on a chiffrée ici pour la lisibilité — l'honnêteté du rapport exige la requête (3') qui calcule ce . (4) Les Vrilles de la vigne : la requête-vigie, à publier avec le palmarès (exercice 4). (5) Lyon , Nantes , Paris (DISTINCT dans un agrégat : au-delà de la liste officielle, signalé) — mais Nantes-sans-Farid illustre la limite : une ville de purs non-emprunteurs disparaîtrait entièrement ; le « villes sans emprunteur comprises » de l'énoncé exige l'EXCEPT d'appoint sur les villes, et le rapport le signale. (Un rapport n'est pas cinq requêtes : c'est cinq requêtes, leurs angles morts déclarés, et les requêtes-vigies qui les couvrent — la sixième compétence du programme, communiquer, appliquée aux données.)
- Jointure interne
t1 JOIN t2 ON cond: produit cartésien filtré ; équi-jointures (égalités, typiquement clé étrangère clé primaire) ; se chaîne (JOIN … JOIN …) en suivant les flèches du schéma ; préfixestable.attributet aliasAScontre les ambiguïtés. Interne les lignes sans partenaire disparaissent (Farid, le livre jamais emprunté) — les zéros manquent aux classements : requête-vigieEXCEPT. - Autojointure : joindre une table à elle-même via deux alias ; filtre
id1 < id2pour les paires non ordonnées (ni diagonale, ni doublons symétriques) — l'astuce du chapitre 12. - Agrégats
COUNT(),SUM,AVG,MIN,MAX: une colonne une valeur ;WHEREfiltre avant.GROUP BY: une ligne par groupe ; règle d'or SQL99 — toute colonne projetée est groupée ou agrégée (grouper par la clé*, projeter le nom en l'ajoutant auGROUP BY). HAVING: le filtre des groupes, seul endroit pour une condition sur agrégat ;WHEREcondition de ligne,HAVINGcondition de groupe. Ordre logique :FROM/JOINWHEREGROUP BYHAVINGSELECTORDER BYLIMIT— écrire dans ce fil, déboguer à rebours.- Sous-requêtes : scalaire comme seuil (
pages > (SELECT AVG(pages) …)) ; superlatif exact égalité avec l'agrégat (annee = (SELECT MIN(annee) …), rend les ex æquo) ; superlatif par groupe sous-requête corrélée (leMAXde son auteur). - Lire les résultats en statisticien : moyenne globale moyenne des moyennes (pondération par ligne ou par groupe — le
GROUP BYest un choix de modélisation) ; résultat vide une réponse ; tout classement se publie avec ses absents.
16.6 Exercices d'entraînement
Cette banque d'exercices, classée par thème, couvre l'intégralité du chapitre. La numérotation prolonge celle des dix exercices résolus. Légende : application directe, raisonnement intermédiaire, approfondissement ; le symbole signale un classique incontournable. Les requêtes portent sur la base médiathèque.
A. Jointures
- () Les titres et noms d'auteurs des livres empruntés en septembre, par jour croissant.
- () Les villes d'où provient au moins un emprunt d'un livre de Verne (avec
DISTINCT). - ( ) Reconstituer la jointure en Python pur : tables en listes de dictionnaires, double boucle filtrée — puis avec un dictionnaire d'index sur la clé primaire (chapitre 2 !) qui fait tomber le coût de à ; c'est ce que fait le moteur.
- () Les couples d'emprunts du même livre par deux usagers différents (autojointure d'
emprunt) — qui a des lectures communes ? - () Une jointure sans clé : les paires (livre, usager) où l'usager porte un nom alphabétiquement antérieur au titre — syntaxiquement licite, sémantiquement absurde ; en tirer la règle « une équi-jointure suit une flèche du schéma, sinon justifier ».
B. Agrégation
- () Le nombre de livres, de pages totales et la moyenne par auteur (nom affiché) ; l'écart entre l'auteur le plus prolifique et le moins prolifique.
- () Le nombre d'emprunts par mois (grouper par
substr(jour, 1, 7)si le moteur le permet (fonction de chaîne hors programme — préférer la comparaison de bornes), sinon par comparaison de bornes en deux requêtes). - ( ) Pour chaque ville : le nombre d'usagers, le nombre d'emprunts, et le ratio emprunts par usager — trois requêtes ou une seule ? Discuter le piège du ratio avec la jointure interne (Farid compte-t-il au dénominateur ?).
- () Trouver les jours de pointe : les jours portant strictement plus d'emprunts que la moyenne par jour actif (sous-requête scalaire sur un agrégat d'agrégat — décomposer en deux temps).
- () La règle d'or à l'épreuve : pour chacune de ces cinq requêtes plausibles, dire si SQL99 l'accepte et sinon pourquoi —
SELECT ville, nom, COUNT() GROUP BY ville;SELECT MAX(annee), MIN(annee) FROM livre;SELECT id_auteur, COUNT() FROM livre(sansGROUP BY) ;SELECT ville FROM usager GROUP BY ville HAVING COUNT() > 1;SELECT ville, COUNT() FROM usager WHERE COUNT(*) > 1 GROUP BY ville.
C. Sous-requêtes et superlatifs
- () Les livres plus anciens que la moyenne des années de parution ; les usagers de la ville d'Alice (sous-requête scalaire sur
usager). - ( ) L'usager le plus actif (nombre maximal d'emprunts) — par sous-requête sur l'agrégat des effectifs ; gérer les ex æquo (Alice et Chloé).
- () Pour chaque usager, son emprunt le plus récent (titre et jour) — la sous-requête corrélée de l'exercice 7, transposée.
- () Le livre le plus emprunté de chaque auteur : superlatif par groupe au carré (corrélation sur l'auteur, agrégat sur les emprunts) — à décomposer méthodiquement avant d'écrire.
D. Études
- () Prédire puis vérifier le résultat des dix requêtes du chapitre sur la base modifiée : Farid emprunte Les Vrilles de la vigne le
2025-10-15— quelles réponses changent, lesquelles sont stables, et pourquoi ? - ( ) Réécrire en SQL les statistiques du chapitre 4 (moyenne, min, max, effectifs par classe) sur une table de relevés météo — et comparer ligne à ligne le programme Python d'alors et les requêtes : ce que chacun dit, ce que chacun tait.
- () Le moteur sous le capot : pour la requête de l'exercice 8, proposer un plan d'exécution en pseudo-code Python (dictionnaire d'index pour la jointure, dictionnaire d'accumulation pour le
GROUP BY— chapitre 2 partout) et donner sa complexité. - ( ) Dossier complet « la base du festival » (chapitre 15, exercice 7) : peupler les tables d'un jeu de données cohérent (sur papier), puis écrire et dérouler les requêtes — taux de remplissage par séance, film le plus réservé, spectateurs multi-séances, salles sous-utilisées — selon les six compétences du programme.