Les dictionnaires dévoilés : le hachage
Cours complet · informatique (tronc commun des prépas scientifiques), chapitre 17 · prépas scientifiques, tronc commun
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
<i class="fa-solid fa-compass mr-2" style="color:#9A563B"></i>17.1 Introduction et motivation
Depuis le chapitre 2, le dictionnaire est notre meilleur allié — comptages, déjà-vu, index, mémoires de toutes sortes — et nous l'utilisons sur parole : insertion, recherche et suppression « en ». Une promesse stupéfiante, à y regarder de près : retrouver une clé parmi un million sans en examiner qu'une poignée, là où la liste exige et le tableau trié avec l'obligation de rester trié. Ce chapitre ouvre enfin la boîte noire : le mécanisme s'appelle le hachage, et c'est l'une des plus belles idées de l'informatique — transformer la clé elle-même en adresse, pour que la donnée dise où elle habite.
Comprendre le mécanisme n'est pas un luxe de curiosité : il explique les conditions du contrat. Pourquoi une liste ne peut-elle pas servir de clé (TypeError: unhashable type) ? Pourquoi le est-il « en moyenne » et que devient-il dans le pire cas ? Pourquoi l'ordre d'un dictionnaire ne doit-il rien au hasard ni au tri ? Toutes ces questions ont la même réponse, et elle tient en une image : des casiers, une règle d'adressage, et l'art de gérer les inévitables collisions.
17.2 L'idée du hachage
17.2.1 La clé devient adresse
Une table de hachage range ses données dans un tableau de cases appelées alvéoles (buckets). Une fonction de hachage transforme chaque clé en un entier, et la clé est rangée dans l'alvéole d'indice
Chercher une clé refait le même calcul et va voir directement dans la bonne alvéole : ni parcours, ni tri — un calcul arithmétique et un accès de tableau, si l'alvéole est peu peuplée. En Python, la fonction de hachage est hash :
>>> hash(42), hash("info"), hash((3, "a"))
(42, 4949054158308671837, 3068460814) # valeurs indicatives : voir plus basPrenons alvéoles et, pour des clés-chaînes, la fonction artisanale « somme des codes des caractères » (sum(ord(c) for c in cle)). Insérons des prénoms avec leurs notes : "Ana" (), "Bob" (), "Eva" (), "Lou" () :
| alvéole | 0 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|---|
| contenu | — | — | Bob | Lou | Eva | — | Ana |
Chercher "Lou" : calculer , regarder l'alvéole — trouvé en un coup, que la table contienne quatre clés ou quatre millions (avec assez d'alvéoles). L'adresse n'est pas stockée : elle est recalculée à chaque fois, et c'est pour cela que le calcul doit être déterministe — même clé, même alvéole, toujours.
17.2.2 Les collisions
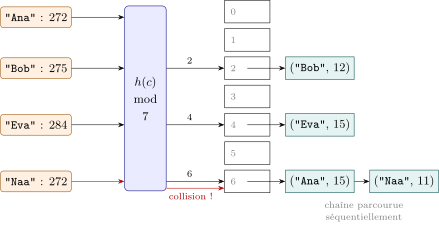
Deux clés distinctes peuvent tomber dans la même alvéole — une collision : avec notre fonction artisanale, "Ana" et "Naa" ont la même somme (les anagrammes du chapitre 2, revenus en saboteurs !). Les collisions sont inévitables dès que les clés possibles sont plus nombreuses que les alvéoles — le principe des tiroirs. La parade standard est le chaînage : chaque alvéole contient une liste de couples (clé, valeur), parcourue séquentiellement :
def creer(m: int) -> list:
    return [[] for _ in range(m)]            # m alvéoles vides (pas [[]] * m !)

def inserer(table: list, cle, valeur) -> None:
    alv = table[hash(cle) % len(table)]
    for couple in alv:
        if couple[0] == cle:
            couple[1] = valeur               # clé déjà là : mise à jour
            return
    alv.append([cle, valeur])

def chercher(table: list, cle):
    alv = table[hash(cle) % len(table)]
    for couple in alv:
        if couple[0] == cle:
            return couple[1]
    return None                              # absente
Une table de hachage chaînée, complète, en quinze lignes — le dictionnaire de Python est un parent industriel de ce prototype.
Complexité : Le contrat, conditions comprises
Le coût d'une opération est où est la longueur de l'alvéole visitée. Si la fonction de hachage disperse bien — les clés se répartissent comme au hasard — et si l'on maintient le facteur de charge borné (en pratique , en agrandissant la table au besoin), alors vaut en moyenne : c'est le en moyenne promis depuis le chapitre 2. Le pire cas reste : si toutes les clés s'entassent dans la même alvéole (fonction de hachage naïve clés malveillantes ou malchanceuses), la table dégénère en liste — l'exercice 6 le met en scène. Moyenne excellente, pire cas médiocre, et tout repose sur la qualité de la dispersion : voilà le contrat complet.
Quand dépasse le seuil, on alloue une table plus grande (typiquement ) et l'on réinsère tout — car change avec : toutes les adresses sont à recalculer.
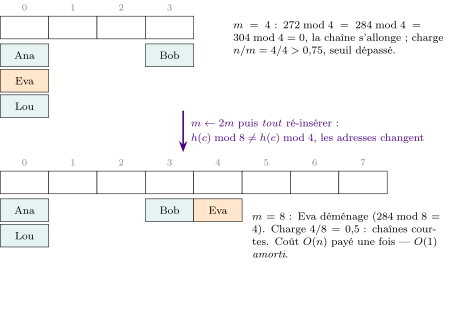
Ce grand déménagement coûte , mais il est rare (déclenché après insertions environ) : étalé sur les insertions qui l'ont provoqué, son coût amorti est par insertion — le même argument que la file à deux piles (chapitre 13, banque). Les à-coups existent (une insertion sur est lente), la moyenne tient.
17.3 Ce qui peut servir de clé
Le mécanisme impose deux exigences à toute clé :
- des clés égales doivent avoir le même haché — sinon deux exemplaires de « la même » clé iraient dans deux alvéoles, et la recherche deviendrait une loterie ;
- le haché d'une clé ne doit jamais changer — une clé rangée dans l'alvéole qui, mutée, hacherait désormais vers l'alvéole , serait introuvable : ni perdue ni effacée, simplement cherchée au mauvais endroit, à jamais.
D'où l'interdit de Python : les objets mutables — listes, dictionnaires, ensembles — ne sont pas hachables (hash([1, 2]) lève TypeError). Sont hachables les immuables : nombres, chaînes, et tuples d'objets hachables — (3, "a") oui, ([1], "a") non, la mutabilité se propage. La limitation n'est pas un caprice du langage : c'est la condition de survie du hachage, et l'exercice 7 montre la catastrophe qu'elle prévient. (Le contournement honnête : convertir — la liste en tuple, l'ensemble en frozenset — c'est-à-dire geler la clé.)
Le haché des chaînes Python change d'une exécution à l'autre (hash("info") ce matin ce soir) : une randomisation volontaire, qui empêche un adversaire de fabriquer à l'avance des milliers de clés en collision pour effondrer les serveurs (l'attaque par dégradation du pire cas — l'exercice 6 en montre le principe). Dans une exécution, le haché est stable, et c'est tout ce que la table exige. Conséquence : la case où tombe une clé ne signifie rien — ne jamais écrire de programme qui en dépend. (Depuis Python 3.7, un dictionnaire se parcourt dans l'ordre d'insertion des clés, garanti par le langage et sans rapport avec les hachés ; un set, lui, n'offre aucun ordre garanti.)
17.4 Le dictionnaire Python, bilan d'utilisateur averti
Méthode : L'essentiel du dictionnaire, révision outillée
d = {"Ana": 15, "Bob": 12}        # littéral
d["Lou"] = 17                     # insertion / mise à jour : O(1) moyen
"Ana" in d                        # appartenance (sur les CLÉS) : O(1) moyen
d.get("Zoe", 0)                   # lecture avec défaut (pas d'erreur)
del d["Bob"]                      # suppression
for cle in d: ...                 # parcours des clés
for cle, val in d.items(): ...    # parcours des couples
list(d.values())                  # les valeurs
Et les trois réflexes hérités des chapitres précédents, maintenant justifiés : le comptage (d[c] = d.get(c, 0) + 1), le déjà-vu (un set, qui est une table de hachage sans valeurs), l'index (clé enregistrement, la jointure rapide du chapitre 16, banque). Chacun troque de la mémoire ( d'alvéoles) contre du temps — l'échange espace-temps du chapitre 10, dont la table de hachage est l'incarnation la plus rentable.
<i class="fa-solid fa-dumbbell mr-2" style="color:#2E7559"></i>17.5 Exercices résolus
Niveau (Application directe du cours)
Avec alvéoles et somme des codes (ord) des caractères : insérer successivement "as" (), "sa" (), "or" (), "ro" (), "un" (). Donner l'état des alvéoles, les collisions, et le coût (en comparaisons de clés) d'une recherche de "sa", de "un", et de "il" (, absente).
Démonstration (Solution)
Indices : , , , , . État : alvéole : ; alvéole : ; alvéoles : vides. Deux paires d'anagrammes sont entrées en collision (même somme, fatalement), et "un" a rejoint l'alvéole par coïncidence arithmétique. Recherches : "sa" alvéole , deuxième de la chaîne : comparaisons ; "un" : comparaisons ; "il" , alvéole vide : comparaison — l'absence se constate immédiatement. (Le déséquilibre saute aux yeux : cinq clés, deux alvéoles occupées sur cinq — la fonction-somme disperse mal, et l'exercice 6 chiffrera le prix ; noter aussi que l'absence est souvent moins chère que la présence : on ne parcourt que l'alvéole désignée, pas la table.)
Prédire, pour chaque candidat-clé, si Python l'accepte : 3.14 ; "abc" ; [1, 2] ; (1, 2) ; (1, [2]) ; ((1,), "a") ; {1, 2} ; frozenset({1, 2}). Justifier par la règle du cours, et proposer pour chaque refusé le « gel » adéquat.
Démonstration (Solution)
Acceptés : 3.14, "abc", (1, 2), ((1,), "a") (tuple de hachables, récursivement), frozenset({1, 2}) (l'ensemble gelé, donc immuable). Refusés — TypeError : [1, 2] (liste, mutable), (1, [2]) (le tuple est immuable mais son contenu liste ne l'est pas : la mutabilité se propage de l'intérieur), {1, 2} (ensemble mutable). Gels : liste tuple([1, 2]) ; tuple contaminé (1, (2,)) ; ensemble frozenset. (Le critère opérationnel : « cette clé pourrait-elle changer pendant qu'elle est dans le dictionnaire ? » — si oui, l'adressage par contenu n'a plus de sens, et Python préfère l'interdire à la source que vous laisser perdre vos données en silence ; on a déjà utilisé des clés-tuples sans le savoir : les sommets-cases des grilles du chapitre 12.)
Avec notes = {"Ana": 15, "Bob": 12, "Eva": 15, "Lou": 17} : (a) calculer la moyenne des valeurs ; (b) construire le dictionnaire inverse note liste des prénoms ; (c) trouver les clés de valeur maximale — en un seul parcours chacun.
Démonstration (Solution)
moyenne = sum(notes.values()) / len(notes)            # (a) 14.75

inverse = {}                                          # (b)
for nom, note in notes.items():
    if note not in inverse:
        inverse[note] = []
    inverse[note].append(nom)
# {15: ["Ana", "Eva"], 12: ["Bob"], 17: ["Lou"]}

meilleurs, record = [], None                          # (c)
for nom, note in notes.items():
    if record is None or note > record:
        meilleurs, record = [nom], note
    elif note == record:
        meilleurs.append(nom)
# (["Lou"], 17)
(b) est le motif d'indexation inverse — regrouper par valeur — déjà vu pour les anagrammes (chapitre 2) et le GROUP BY (chapitre 16) : c'est partout le même geste, accumuler dans un dictionnaire de listes. (c) reprend le champion du chapitre 2, enrichi des ex æquo. (L'inverse d'un dictionnaire n'est un dictionnaire simple que si les valeurs sont distinctes — sinon, valeur liste, et l'oublier écrase silencieusement Ana par Eva : le bogue d'écrasement, cousin de celui des tris non stables.)
Niveau (Application avec raisonnement intermédiaire)
Compléter la table du cours avec supprimer(table, cle) et taille(table), écrire le jeu de tests par partitionnement (chapitre 10 : clé présente / absente / en collision ; alvéole vide ; mise à jour), et vérifier qu'une mise à jour ne crée pas de doublon.
Démonstration (Solution)
def supprimer(table: list, cle) -> None:
    alv = table[hash(cle) % len(table)]
    for k in range(len(alv)):
        if alv[k][0] == cle:
            alv.pop(k)
            return                            # au plus une occurrence : invariant

def taille(table: list) -> int:
    return sum(len(alv) for alv in table)

T = creer(3)                                  # petite table : collisions garanties
inserer(T, "as", 1); inserer(T, "sa", 2); inserer(T, "or", 3)
assert chercher(T, "sa") == 2                 # présente, en collision
assert chercher(T, "il") is None              # absente
inserer(T, "as", 9)                           # mise à jour...
assert chercher(T, "as") == 9 and taille(T) == 3   # ...sans doublon !
supprimer(T, "or"); assert chercher(T, "or") is None and taille(T) == 2
supprimer(T, "il")                            # supprimer une absente : sans effet
L'invariant de structure — chaque clé apparaît au plus une fois dans toute la table — est ce que le test de mise à jour vérifie : c'est lui que la boucle d'inserer protège en cherchant la clé avant d'ajouter. (Choisir , minuscule, pour le test est un art : on veut des collisions dans le jeu de tests, sinon la moitié du code — le parcours de chaîne — n'est jamais exercée ; tester une table de hachage sur une grande table presque vide, c'est tester un parapluie par beau temps.)
Insérer clés aléatoires dans alvéoles (facteur de charge ) et mesurer : la proportion d'alvéoles vides, la longueur moyenne des chaînes non vides, la longueur maximale. Comparer aux prédictions du hasard uniforme ( de vides) et commenter pour le coût des opérations.
Démonstration (Solution)
import random
m = 1000
longueurs = [0] * m
for _ in range(1000):
    longueurs[random.randrange(m)] += 1       # l'alvéole d'une clé "au hasard"

vides = longueurs.count(0) / m                #   0.368
occupees = [l for l in longueurs if l > 0]
moyenne_nv = sum(occupees) / len(occupees)    #   1.58
maxi = max(longueurs)                         #   5 à 7
Mesures typiques : d'alvéoles vides (la prédiction du cours de probabilités), chaînes occupées de en moyenne, maximum à . Lecture pour le coût : à charge , une recherche parcourt en moyenne moins de deux couples — le moyen est très concret — mais quelques clés malchanceuses coûtent à comparaisons : le est une moyenne, pas une garantie uniforme. (Ce maximum croît très lentement avec — en , dit la théorie — c'est pourquoi les tables réelles tolèrent la charge sans drame ; et ce petit modèle « boules dans des urnes » est exactement celui des anniversaires partagés : les collisions arrivent bien plus tôt qu'on croit, d'où l'obligation de les gérer plutôt que de les espérer rares.)
Avec la table du cours mais somme des codes : (a) fabriquer clés deux à deux en collision parfaite (même somme), les insérer, et chronométrer recherches — comparer aux mêmes clés sous hash. (b) Expliquer la dégradation, et pourquoi la fonction-somme est structurellement fautive. (c) Relier à la randomisation du haché des chaînes de Python.
Démonstration (Solution)
(a) Les anagrammes fournissent les collisions en série : les chaînes "a" k + "b" + "a" (199 - k) ont toutes la même somme. Insérées avec la fonction-somme, elles tombent dans la même alvéole : la table est une liste déguisée, et recherches y coûtent comparaisons — des millisecondes contre des microsecondes avec hash (qui les disperse, l'ordre des caractères comptant dans son calcul) : un facteur à , mesuré. (b) La somme est commutative : elle ignore l'ordre des caractères, donc identifie toutes les permutations — une classe entière de clés naturelles (les anagrammes !) s'effondre sur une valeur. Une bonne fonction de hachage doit être sensible à tout : contenu, ordre, longueur — le moindre invariant ignoré devient un gisement de collisions. (c) Même avec une bonne fonction, un adversaire qui la connaît peut calculer hors ligne des milliers de clés en collision et les soumettre à un serveur (formulaires, paramètres web) : chaque requête coûte alors , le service s'effondre. La parade de Python : une graine secrète tirée au lancement, qui rend le haché imprévisible de l'extérieur — la dispersion redevient un pari sûr. (Moralité en deux temps : la complexité « en moyenne » suppose que les entrées ne conspirent pas contre vous ; quand elles le peuvent — le pire cas est choisi, pas tiré au sort — c'est la conception qui doit restaurer le hasard. Le tri rapide a le même talon d'Achille, chapitre 9 : pire cas sur entrée triée, pivot aléatoire en parade.)
Notre table-jouet, contrairement à Python, accepte n'importe quelle clé — y compris une liste. (a) Insérer cle = [1, 2] avec la valeur "x" (en utilisant hash(tuple(cle)) pour l'adressage), puis muter cle.append(3) et chercher [1, 2, 3] puis [1, 2] : que se passe-t-il ? (b) Énoncer précisément l'invariant de structure violé. (c) Conclure sur l'interdit de Python.
Démonstration (Solution)
(a) L'insertion calcule — disons l'alvéole — et y range . Après cle.append(3), l'objet dans la table est devenu (c'est le même objet, partagé — chapitre 10 !). Chercher : l'adressage calcule — une autre alvéole, vide ou étrangère : introuvable. Chercher : retour à l'alvéole … où la comparaison couple[0] == [1, 2] échoue, la clé stockée valant désormais : introuvable aussi. La valeur "x" est orpheline : présente en mémoire, inaccessible par toute recherche — ni un bogue de la table, ni une erreur d'exécution : un état incohérent silencieux.
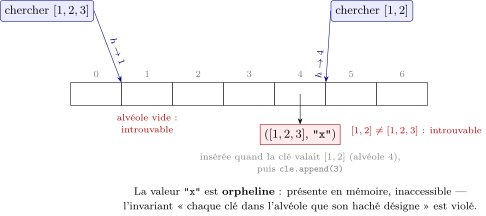
(b) L'invariant « toute clé stockée se trouve dans l'alvéole que son haché désigne » — vrai à l'insertion, falsifié de l'extérieur par la mutation : aucune ligne de code de la table n'a fauté, et aucune ne peut s'en apercevoir sans tout re-parcourir. (c) Python interdit donc le problème à la racine : refuser les clés mutables, c'est rendre cet état inatteignable — un invariant garanti par construction plutôt que par discipline, le choix de conception le plus robuste du chapitre 10. (La table-jouet qui « accepte tout » paraissait plus libérale ; elle était seulement plus dangereuse — toute la différence entre une contrainte arbitraire et une contrainte qui encode une nécessité.)
Niveau (Raisonnement subtil ou plusieurs étapes)
Équiper la table d'un agrandissement automatique : si le facteur de charge dépasse après insertion, doubler et tout réinsérer. (a) Implémenter. (b) Chronométrer insertions une à une et tracer le temps cumulé : quelle forme a la courbe, et où sont les redimensionnements ? (c) Démontrer que le coût total des redimensionnements pour insertions est .
Démonstration (Solution)
(a)
def inserer_auto(table: list, cle, valeur) -> list:
    """Insère et renvoie la table (la même, ou une neuve agrandie)."""
    inserer(table, cle, valeur)
    if taille(table) > 0.75 * len(table):
        neuve = creer(2 * len(table))
        for alv in table:
            for c, v in alv:
                inserer(neuve, c, v)          # re-hachage : les adresses changent
        return neuve
    return table
(b) La courbe du temps cumulé est une droite — pente par insertion — décorée de petites marches verticales aux tailles : chaque doublement se paie d'un à-coup en , de plus en plus rare. (c) Si la table finit avec alvéoles, les redimensionnements ont réinséré successivement couples : la série géométrique borne le tout par — soit amorti par insertion, exactement l'argument de la file à deux piles (chapitre 13, banque) et pour la même raison : chaque élément n'est déménagé qu'un nombre de fois borné par la géométrie des doublements. (C'est le doublement qui fait tout : agrandir de alvéoles à chaque seuil donnerait total — la croissance multiplicative est la signature des coûts amortis constants, et la liste Python elle-même grandit ainsi sous vos append depuis le premier chapitre.)
(a) Implémenter un ensemble par table de hachage : ens_creer, ens_ajouter, ens_contient — et réécrire avec lui le déjà-vu du chapitre 2 (premiere_repetition(t)). (b) Comparer au déjà-vu par liste () sur : chronométrer. (c) En quoi set et dict sont-ils « le même objet » ? Que devient l'union de deux ensembles dans cette vision ?
Démonstration (Solution)
(a) C'est la table du cours, délestée des valeurs : les alvéoles stockent des clés nues, ens_ajouter ne fait rien si la clé est déjà là, ens_contient parcourt l'alvéole. Le déjà-vu :
def premiere_repetition(t: list):
    vus = ens_creer(2 * len(t))               # charge finale <= 0.5
    for x in t:
        if ens_contient(vus, x):
            return x
        ens_ajouter(vus, x)
    return None
(b) Sur éléments sans répétition (le pire cas) : la version liste fait comparaisons — de l'ordre de la seconde ; la version table, opérations d'alvéoles courtes — quelques millisecondes. Le facteur est la promesse du chapitre 2, désormais expliquée de bout en bout : on sait ce qui se passe dans chaque alvéole. (c) Un set est un dict dont seules les clés existent — mêmes exigences (éléments hachables), mêmes coûts, même mécanique ; l'union de deux ensembles est une double insertion ( en moyenne), l'intersection un filtre du petit par appartenance au grand. (D'où la règle d'or des collections, maintenant fondée : « ai-je besoin d'associer une valeur ? » — oui : dict ; non, seulement d'appartenir : set ; et l'ordre, lui, n'appartient à aucun des deux — il est la spécialité des listes, et le hachage l'a sacrifié en échange du .)
Construire l'index inverse d'un texte : pour chaque mot, la liste des positions où il apparaît. (a) Implémenter avec le dictionnaire Python, donner le coût. (b) Répondre avec l'index aux requêtes « positions de tel mot » et « les mots apparaissant plus de fois », et comparer au coût sans index. (c) Estimer la mémoire de l'index, et conclure sur l'échange espace-temps. (d) En quoi l'index inverse est-il l'idée des moteurs de recherche ?
Démonstration (Solution)
(a)
def index_inverse(mots: list) -> dict:
    index = {}
    for i in range(len(mots)):
        if mots[i] not in index:
            index[mots[i]] = []
        index[mots[i]].append(i)
    return index
Un parcours, une opération de dictionnaire par mot : en moyenne pour mots — le motif d'indexation inverse de l'exercice 3, aux positions près. (b) « Positions de m » : index.get(m, []), en moyenne — contre par re-parcours du texte à chaque requête. « Mots de plus de occurrences » : un parcours de l'index, — c'est un GROUP BY … HAVING COUNT > k (chapitre 16) exécuté à la main, et l'index est le groupement, déjà fait. (c) L'index stocke chaque position une fois plus le vocabulaire : — le texte en double, environ. L'échange est typique : payer d'espace et de préparation une fois, pour des requêtes en à volonté ; rentable dès la deuxième requête, comme l'index du moteur SQL (chapitre 16, banque) et pour la même raison. (d) Un moteur de recherche est cet index à l'échelle du web : mot liste de pages (et positions), construit par les robots d'indexation, interrogé en par milliard de requêtes — l'intersection des listes de plusieurs mots donnant les pages qui les contiennent tous. (Que la recherche dans tout le web réponde plus vite que la recherche dans un fichier local non indexé n'est pas un paradoxe : c'est la différence entre avoir, ou non, déplacé le travail avant la question — la leçon finale du hachage, et de tout ce chapitre.)
- Hachage : la clé devient adresse — dans un tableau de alvéoles ; l'adresse est recalculée, jamais stockée ;
hashen Python. - Collisions : inévitables (tiroirs) ; chaînage : chaque alvéole est une liste de couples, parcourue séquentiellement ; coût — en moyenne si bonne dispersion et facteur de charge borné (), au pire (tout dans une alvéole : fonction commutative anagrammes, ou clés adverses — d'où la randomisation du haché des chaînes).
- Redimensionnement : doubler et tout re-hacher quand la charge dépasse le seuil — l'à-coup, amorti (série géométrique : la croissance multiplicative est la clé, comme l'
appenddes listes). - Clés hachables : égales même haché, et haché immuable — sinon clé introuvable et valeur orpheline (l'invariant « chaque clé dans son alvéole » violé de l'extérieur). Python interdit les clés mutables par construction : nombres, chaînes, tuples de hachables,
frozenset— oui ; listes, dict, set — non (geler :tuple,frozenset). - Conséquences d'usage : la case où tombe une clé ne porte aucun sens (un
dictse parcourt dans l'ordre d'insertion, unsetsans ordre garanti) ;setdictionnaire sans valeurs (appartenance pure) ; motifs fondamentaux — comptage, déjà-vu, index/indexation inverse (valeur liste : attention à l'écrasement) — tous de préparation pour des requêtes : l'échange espace-temps roi. - Tester une table : petite () pour forcer les collisions ; invariant « chaque clé au plus une fois » (mise à jour sans doublon) ; l'absence se teste aussi.
17.6 Exercices d'entraînement
Cette banque d'exercices, classée par thème, couvre l'intégralité du chapitre. La numérotation prolonge celle des dix exercices résolus. Légende : application directe, raisonnement intermédiaire, approfondissement ; le symbole signale un classique incontournable.
A. Mécanique du hachage
- () Avec et somme des codes : placer
"chat","tach","chien","niche","poule"; lister les collisions et leur cause. - () Pour clés parfaitement dispersées dans alvéoles : longueur moyenne des chaînes, coût moyen d'une recherche présente et d'une recherche absente — en fonction du facteur de charge.
- ( ) Le test d'une fonction de hachage : écrire
histogramme(cles, h, m)qui affiche la distribution des longueurs d'alvéoles, et comparer trois fonctions sur les mots d'un texte français — somme des codes, somme pondérée par la position,hash. - () Pourquoi premier est-il traditionnellement préféré ? Tester avec des clés toutes paires et contre (la moitié des alvéoles meurt avec pair).
- () Le paradoxe des anniversaires : combien de clés aléatoires avant la première collision dans alvéoles (réponse ) ? Mesurer pour puis , et en tirer la loi : les collisions arrivent en , pas en .
B. Le dictionnaire en action
- () Réécrire avec un dictionnaire : la fréquence des lettres d'un texte ; le test d'anagrammes (chapitre 2) ; les degrés entrants d'un graphe (chapitre 12).
- ()
d.get(c, 0) + 1contreif c in d: montrer l'équivalence et compter les recherches de chaque version. - ( ) La mémoire associative à clés composées : compter les emprunts par couple (usager, mois) de la base du chapitre 16, en Python avec des clés-tuples — le
GROUP BYmulti-colonnes à la main. - () Détecter si deux listes ont un élément commun : trois méthodes (double boucle , tri parcours , ensemble ) — implémenter et chronométrer.
- () Un dictionnaire à deux sens (bijection) : maintenir simultanément clé valeur et valeur clé, avec l'invariant de cohérence et son jeu de tests — que faire si une insertion casse la bijectivité ?
C. Sous le capot
- () Ajouter à la table-jouet le parcours :
couples(table)renvoyant tous les (clé, valeur) — dans quel ordre sortent-ils, et pourquoi cet ordre est-il un artefact ? - ( ) Mesurer le pire cas : construire clés en collision pour la fonction-somme, chronométrer la dégradation, puis vérifier que
hashles disperse — l'expérience de l'exercice 6 en autonomie. - () Implémenter la table avec adressage ouvert (au-delà du programme : en cas de collision, essayer l'alvéole suivante) : insertion et recherche ; identifier le problème de la suppression — pourquoi le chaînage est plus simple.
- () Estimer la mémoire d'un dictionnaire d'un million de couples (alvéoles, listes, objets) et la comparer à deux listes parallèles triées : quantifier ce que coûte le .
D. Études
- () La mémoïsation manuelle : équiper
fib(chapitre 6) d'un dictionnaire des résultats déjà calculés et mesurer le passage de à — l'antichambre du chapitre 18. - ( ) Le cache d'une fonction coûteuse : écrire
avec_cache(f)qui mémorise les appels defdans un dictionnaire (clés arguments, gelés au besoin) ; discuter ce qui se passe sifa des effets de bord (chapitre 10 !). - () L'index inversé multi-fichiers : étendre l'exercice 10 à un répertoire de textes (mot liste de (fichier, position)), avec requête conjonctive « les fichiers contenant tous ces mots » par intersection d'ensembles.
- ( ) Dossier « le dictionnaire dans tous ses états » : recenser dans les chapitres 1 à 16 chaque usage d'un dictionnaire ou d'un ensemble (comptage, déjà-vu, marquage de parcours, mémo, index…), classer par motif, et rédiger la fiche de choix « liste / ensemble / dictionnaire » selon les six compétences du programme.