Bases de données et travaux pratiques
Cours complet · mathématiques appliquées (ECG 2e année), chapitre 13 · prépa ECG, 2e année
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
L'informatique de deuxième année se partage en deux : un objet nouveau, les bases de données, et la mise en pratique des chapitres de mathématiques — systèmes différentiels, statistiques bivariées, chaînes de Markov, estimation.
Le premier sujet est celui des banques, des assurances et de la gestion : des données trop nombreuses pour tenir dans un tableau, interrogées par un langage fait pour cela, SQL.
Le programme n'exige que SELECT ... FROM, WHERE, INSERT INTO, DELETE FROM, UPDATE, CREATE TABLE et INNER JOIN. Il précise même : « aucune autre notion de jointure n'est dans ce programme ». Les fonctions d'agrégation, ORDER BY et DISTINCT sont explicitement non exigibles.
13.1 Le modèle relationnel
Une table (ou relation) est un tableau dont les colonnes sont les attributs (ou champs) et les lignes les enregistrements. Chaque attribut a un domaine : INTEGER pour un entier, TEXT pour une chaîne.
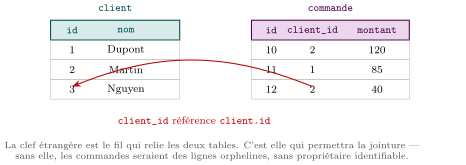
La clef primaire (PRIMARY KEY) est un attribut qui identifie chaque ligne de façon unique. Une clef étrangère (FOREIGN KEY) est un attribut qui référence la clef primaire d'une autre table.
Python : Créer une table
CREATE TABLE client (
    id      INTEGER PRIMARY KEY,
    nom     TEXT,
    ville   TEXT
);

CREATE TABLE commande (
    id         INTEGER PRIMARY KEY,
    client_id  INTEGER,
    montant    INTEGER,
    FOREIGN KEY (client_id) REFERENCES client(id)
);
Le schéma décrit la forme des données, pas leur contenu. Il se déclare une fois, avant toute insertion.
13.2 Interroger et modifier
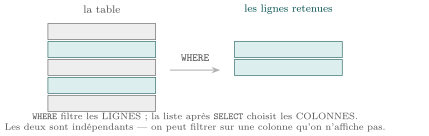
SELECT…FROM…WHERE… : lire ;INSERT INTO…VALUES… : ajouter ;UPDATE…SET…WHERE… : modifier ;DELETE FROM…WHERE… : supprimer.
Les trois dernières changent la base. Un DELETE sans WHERE vide la table entière.
Python : Lire, avec et sans condition
SELECT nom FROM client;

SELECT nom, ville FROM client
WHERE ville = 'Lyon';

SELECT id, montant FROM commande
WHERE montant > 50 AND client_id = 2;
Les opérateurs de comparaison sont =, <>, <, <=, >, >=, et les connecteurs AND, OR, NO. Noter <> pour « différent », et non !=.
Python : Ajouter, modifier, supprimer
INSERT INTO client VALUES (4, 'Bernard', 'Lille');

UPDATE commande
SET montant = montant + 10
WHERE client_id = 1;

DELETE FROM commande
WHERE montant < 50;
Attention : UPDATE commande SET montant = 0; sans WHERE met TOUTES les lignes à zéro. La clause WHERE n'est pas une décoration.
13.3 Jointure
SELECT * FROM commande
INNER JOIN client ON commande.client_id = client.id;
Elle recolle chaque commande avec son client. La condition après ON est une conjonction d'égalités, et le programme n'en demande pas d'autre forme.
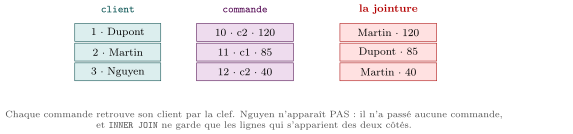
Les lignes sans correspondance disparaissent. Un client sans commande n'apparaît pas dans le résultat, et une commande dont le client_id ne correspond à personne non plus. C'est le comportement voulu — mais il faut le savoir avant de conclure « il n'y a que trois clients ».
13.4 Travaux pratiques
13.4.1 Systèmes différentiels
Python : Tracer une trajectoire
import numpy as np
import matplotlib.pyplot as plt

A = np.array([[0., -0.5], [0.8, -1.3]])
# valeurs propres -0.8 et -0.5, vecteurs propres (1, 1.6) et (1, 1)
c1, c2 = -5/3, 8/3
t = np.linspace(0, 12, 400)
X = (c1*np.exp(-0.8*t)[:, None]*np.array([1., 1.6])
     + c2*np.exp(-0.5*t)[:, None]*np.array([1., 1.]))

plt.plot(t, X[:, 0], label="prix")
plt.plot(t, X[:, 1], label="stock")
plt.legend(); plt.show()
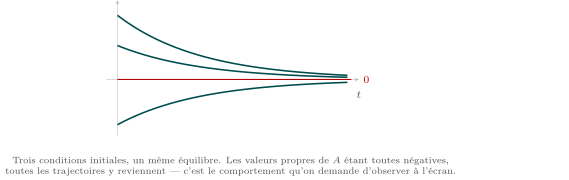
Le programme précise que « la discrétisation d'une équation différentielle n'est pas au programme » : on trace la solution exacte, obtenue par la diagonalisation du chapitre 4.
13.4.2 Statistiques bivariées
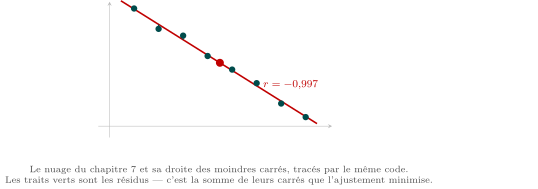
Python : Nuage et droite de régression
import numpy as np

x = np.array([0.5, 1.0, 1.5, 2.0, 2.5, 3.0, 3.5, 4.0])
y = np.array([0.9, 0.6, 0.5, 0.2, 0.0, -0.2, -0.5, -0.7])

xb, yb = x.mean(), y.mean()
sxy = ((x - xb)*(y - yb)).mean()
a = sxy/((x - xb)**2).mean()
b = yb - a*xb
r = sxy/(x.std()*y.std())

print(round(a, 6), round(b, 6), round(r, 6))
# -0.452381 1.117857 -0.997406
x.std() divise par , comme le chapitre 7. D'autres bibliothèques divisent par et donneraient un autre nombre : vérifier la convention avant de comparer deux résultats.
13.4.3 Chaînes de Markov
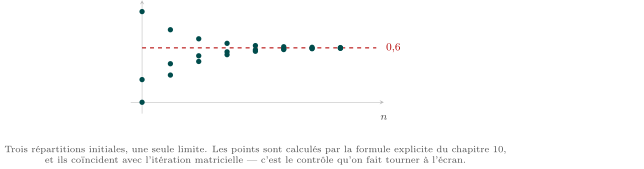
Python : Itérer jusqu'à l'état stable
import numpy as np

M = np.array([[0.8, 0.2], [0.3, 0.7]])
V = np.array([1.0, 0.0])

for n in range(6):
    print(n, V.round(6))
    V = V @ M                      # ATTENTION : V a GAUCHE
# 0 [1. 0.]        1 [0.8 0.2]     2 [0.7 0.3]
# 3 [0.65 0.35]    4 [0.625 0.375] 5 [0.6125 0.3875]
Le programme suggère d'appliquer cela à « l'indice de popularité d'une page web (PageRank), la mobilité sociale, ou les systèmes de bonus-malus en assurances ». Le calcul est le même dans les trois cas.
13.4.4 Estimation
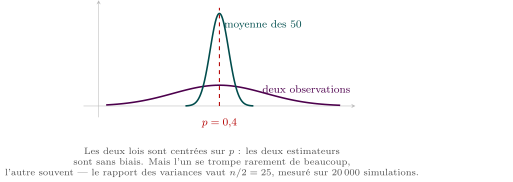
Python : Comparer deux estimateurs
import random, statistics

random.seed(0)
p, n, N = 0.4, 50, 20000
moyenne, deux = [], []
for _ in range(N):
    e = [1 if random.random() < p else 0 for _ in range(n)]
    moyenne.append(sum(e)/n)          # tout l'echantillon
    deux.append((e[0] + e[-1])/2)     # deux observations seulement

for nom, ech in (("moyenne", moyenne), ("deux obs.", deux)):
    print(nom, round(statistics.mean(ech), 4),
                round(statistics.pvariance(ech), 5))
# moyenne   0.3998  0.00479
# deux obs. 0.4004  0.11985
Les deux estimateurs sont sans biais — les moyennes valent — mais leurs variances diffèrent d'un facteur , exactement . C'est la variance qui départage, jamais le biais seul.
Python : Comparer deux intervalles de confiance
import random, math

random.seed(1)
p, n, N = 0.4, 200, 20000
c_tch = c_asy = 0
l_tch = l_asy = 0.0
for _ in range(N):
    f = sum(1 for _ in range(n) if random.random() < p)/n
    d_tch = 1/(2*math.sqrt(n*0.05))       # Bienayme-Tchebychev
    d_asy = 1.96*math.sqrt(f*(1-f)/n)     # asymptotique
    c_tch += (abs(f - p) <= d_tch)
    c_asy += (abs(f - p) <= d_asy)
    l_tch += 2*d_tch; l_asy += 2*d_asy

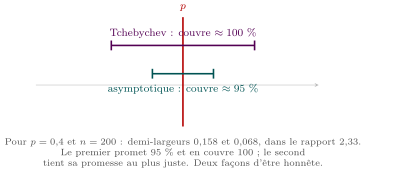
print(round(c_tch/N, 4), round(l_tch/N, 4))   # 1.0    0.3162
print(round(c_asy/N, 4), round(l_asy/N, 4))   # 0.9482 0.1355
Tchebychev couvre toujours — bien au-delà des promis — avec des intervalles fois plus larges. L'intervalle asymptotique tient sa promesse au plus juste. C'est exactement la comparaison que le programme demande.