Les types construits
Cours complet · NSI (première), chapitre 4 · première, spécialité numérique et sciences informatiques
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Les types vus jusqu'ici — entiers, flottants, booléens, chaînes — ont un point commun : une valeur, une donnée. Or les problèmes intéressants portent sur des collections : les notes d'une classe, les pixels d'une image, les coordonnées d'un point, les lignes d'un fichier. Il faut donc des types qui construisent de nouvelles valeurs à partir des valeurs de base. Le programme en présente trois, « au fur et à mesure qu'ils sont nécessaires » : les p-uplets, les tableaux, les dictionnaires. Ce chapitre traite les deux premiers ; le suivant est consacré aux dictionnaires.
Hors programme : Le vocabulaire de Python n'est pas celui de tout le monde
Le programme prévient : « en pratique, on utilise les appellations de Python, qui peuvent être différentes de celles d'autres langages ». Ce que ce chapitre appelle tableau s'écrit en Python avec le type list — le programme note d'ailleurs que « Python identifie listes et tableaux ». Dans d'autres langages, liste et tableau désignent deux structures très différentes, aux coûts opposés. Retenez la notion, pas seulement le mot.
4.1 Les p-uplets
4.1.1 Définition
Un p-uplet (en anglais tuple) est une suite finie et ordonnée de valeurs, éventuellement de types différents. On le note entre parenthèses, les composantes séparées par des virgules.
point = (3, 7)                       # un couple d'entiers
eleve = ("Nour", 17, 15.5)           # un triplet : chaîne, entier, flottant
Deux traits le caractérisent, et les deux comptent :
- l'ordre est significatif : et sont deux p-uplets différents ;
- on ne le modifie pas : une fois construit, un p-uplet ne change plus. Écrire
point[0] = 5provoque une erreur.
Cette dernière propriété n'est pas une gêne, c'est une garantie. Un p-uplet sert à représenter une valeur composite dont les composantes forment un tout — des coordonnées, un résultat à deux volets — et qu'on remplace en bloc plutôt que par morceaux. Pour une collection qu'on veut modifier élément par élément, on emploie un tableau : c'est l'objet de la section suivante.
4.1.2 Renvoyer plusieurs valeurs à la fois
Capacité attendue
« Écrire une fonction renvoyant un p-uplet de valeurs. »
C'est l'usage principal du p-uplet. Une fonction ne renvoie qu'une seule valeur — mais si cette valeur est un p-uplet, elle en renvoie autant qu'on veut.
def division_euclidienne(a, b):
    """Quotient et reste de la division euclidienne de a par b.

    Précondition  : b > 0.
    Postcondition : a == b * q + r et 0 <= r < b.
    """
    assert b > 0, "le diviseur doit etre strictement positif"
    q = a // b
    r = a - b * q
    assert a == b * q + r and 0 <= r < b
return q, rOn serait tenté d'écrire assert b != 0 : c'est insuffisant. Pour , la division entière de Python arrondit vers le bas et le reste devient négatif — la postcondition n'a alors plus de sens. Une précondition trop large laisse passer des appels que la fonction ne sait pas honorer. Exiger n'est pas une restriction arbitraire : c'est le domaine où la promesse tient.
Côté appelant, on récupère les composantes d'un coup — c'est l'affectation multiple, ou déballage :
q, r = division_euclidienne(17, 5) # q vaut 3, r vaut 2Méthode : Échanger deux variables
L'affectation multiple donne l'échange le plus court qui soit :
a, b = b, aLe membre de droite est évalué entièrement avant la moindre affectation : c'est le p-uplet qui est construit, puis déballé. Aucune variable temporaire n'est nécessaire, et l'ordre n'a pas d'importance. Nous nous en servirons à chaque tri du chapitre 7.
4.1.3 Les p-uplets nommés
Le triplet ("Nour", 17, 15.5) pose un problème dès qu'il circule : rien ne dit ce que sont et . Un âge ? un rang ? une moyenne ? Il faut lire le code qui l'a produit pour le savoir — et ce code changera.
Un p-uplet nommé est un p-uplet dont chaque composante porte un nom de champ. On accède aux composantes par leur nom plutôt que par leur rang.
from collections import namedtuple

Eleve = namedtuple("Eleve", ["nom", "age", "moyenne"])
nour = Eleve("Nour", 17, 15.5)

nour.moyenne          # 15.5 — sans équivoque
nour[2] # 15.5 également : un p-uplet nommé reste un p-upletLe gain n'est pas cosmétique. nour.moyenne reste juste si l'on insère un champ au milieu ; nour[2] devient faux silencieusement. Nommer, c'est se protéger d'une classe entière d'erreurs — celles qui ne provoquent aucun message.
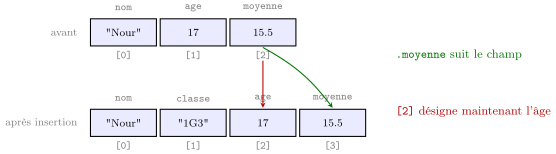
et sans le moindre message. C'est toute la valeur de l'enregistrement à champs nommés.</div>
Le programme signale qu'« en Python, les p-uplets nommés sont implémentés par des dictionnaires ». On peut en effet représenter le même enregistrement par {"nom": "Nour", "age": 17, "moyenne": 15.5}. C'est l'objet du chapitre 5, et c'est la forme que prendront les lignes d'une table au chapitre 6.
4.2 Les tableaux
4.2.1 L'accès calculé direct
Un tableau est une collection ordonnée d'éléments, chacun repéré par un entier appelé index ou indice. En Python, le premier élément porte l'indice ; un tableau de éléments a donc des indices de à .
Capacité attendue
« Lire et modifier les éléments d'un tableau grâce à leurs index. »
notes = [12, 15, 8, 17, 11]

notes[0]              # 12  : lecture du premier
notes[4]              # 11  : lecture du dernier
len(notes)            # 5   : nombre d'éléments
notes[2] = 10         # modification en place : notes vaut [12, 15, 10, 17, 11]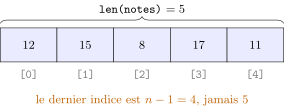
permet de calculer l'adresse de la case au lieu de la chercher.</div>
Le mot index n'est pas anodin. Le programme parle de tableaux « qui permettent un accès calculé direct aux éléments » : les éléments occupent des emplacements consécutifs en mémoire, tous de même taille, si bien que l'adresse du -ième se calcule
Atteindre t[10000] ne coûte donc pas plus cher que t[0] — une multiplication et une addition, quelle que soit la taille du tableau. C'est la propriété qui fera toute la différence au chapitre 8, quand la recherche dichotomique en tirera parti.
L'erreur la plus fréquente du chapitre. Un tableau de 5 éléments n'a pas d'élément d'indice 5 : notes[5] lève IndexError. De même, for i in range(len(t)) parcourt bien à , tandis que range(1, len(t)) saute le premier élément — ce qui est parfois voulu, et souvent non.
Repère historique : Pourquoi compter à partir de zéro
Le choix de numéroter à partir de déroute, et il n'est pas arbitraire. En 1982, dans une note manuscrite restée célèbre — Why numbering should start at zero —, Edsger Dijkstra le justifie : avec des indices allant de à , un intervalle se décrit par sa borne inférieure incluse et sa borne supérieure exclue, deux intervalles consécutifs se recollent sans , et un intervalle vide s'écrit sans cas particulier. C'est exactement la convention de range.
L'idée du tableau, elle, est plus ancienne : elle apparaît dans les premiers langages de haut niveau des années 1950, quand il devient possible de désigner le millième élément sans écrire mille noms de variables.
4.2.2 Itérer sur un tableau
Capacité attendue
« Itérer sur les éléments d'un tableau. »
Deux façons de parcourir, et le choix n'est pas indifférent.
# par élément : quand on n'a besoin que des valeurs
somme = 0
for note in notes:
    somme = somme + note

# par indice : quand on a besoin de la POSITION, ou qu'on veut modifier
for i in range(len(notes)):
    notes[i] = notes[i] + 1        # un point de plus pour tout le monde
Méthode : Lequel choisir ?
Parcourir par élément chaque fois que c'est possible : c'est plus court, plus lisible, et l'on ne peut pas se tromper d'indice. Passer par indice seulement quand on a besoin de la position — pour la renvoyer, pour comparer deux tableaux rang par rang — ou pour modifier le tableau en place, car for note in notes ne donne qu'une copie de la valeur : y affecter note = note + 1 ne changerait rien au tableau.
Hors programme : Ce que le programme écarte, et il en écarte beaucoup
Quatre limites explicites, toutes utiles à connaître :
- « Seuls les tableaux dont les éléments sont du même type sont présentés. » Python accepterait
[1, "deux", 3.0]; le programme ne le fait pas, et les langages où tableau signifie vraiment tableau l'interdisent. - « Aucune connaissance des tranches (slices) n'est exigible. » On n'écrira donc pas
t[2:5]. - « L'aspect dynamique des tableaux de Python n'est pas évoqué. » On raisonne à taille fixe, comme dans un vrai tableau.
- « Il n'est pas fait référence aux tableaux de la bibliothèque NumPy. »
4.3 Les tableaux par compréhension
Capacité attendue
« Construire un tableau par compréhension. »
Un tableau donné par compréhension est décrit par la propriété de ses éléments plutôt que par leur énumération. La notation calque celle des ensembles en mathématiques : s'écrit [i**2 for i in range(10)].
La notation se lit dans un ordre qui n'est pas celui de l'écriture — c'est la seule vraie difficulté, et elle disparaît une fois qu'on l'a vue :
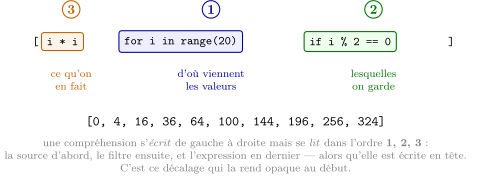
carres = [i * i for i in range(10)]
# [0, 1, 4, 9, 16, 25, 36, 49, 64, 81]

pairs = [i for i in range(20) if i % 2 == 0]      # avec condition
majorees = [min(n + 2, 20) for n in notes]        # à partir d'un autre tableau
Toute compréhension se réécrit en boucle, et réciproquement :
| Par compréhension | Par ajouts successifs |
|---|---|
| `[i * i for i in range(10)]` |
|
Les deux sont corrects. La compréhension dit ce que contient le tableau ; la boucle dit comment le remplir. Préférez la première quand elle tient sur une ligne lisible : on y voit l'intention d'un coup d'œil, et il n'y a pas d'accumulateur à initialiser — donc pas d'oubli possible.
4.4 Les matrices : des tableaux de tableaux
Capacité attendue
« Utiliser des tableaux de tableaux pour représenter des matrices : notation a[i][j]. »
Rien n'empêche les éléments d'un tableau d'être eux-mêmes des tableaux. On obtient un tableau à deux dimensions, dont chaque élément est repéré par deux indices : la ligne, puis la colonne.
m = [[1, 2, 3],
     [4, 5, 6]]        # 2 lignes, 3 colonnes

m[0][2]                # 3 : ligne 0, colonne 2
m[1][0] = 40           # modification : la ligne 1 devient [40, 5, 6]

len(m)                 # 2 : le nombre de LIGNES
len(m[0])              # 3 : le nombre de COLONNES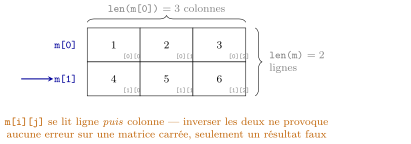
tableau ; m[i][j] une case.</div>
m[i][j] se lit « ligne , colonne », dans cet ordre — et m[i] désigne la ligne entière, qui est un tableau. Inverser les deux indices est l'erreur classique ; sur une matrice carrée elle ne provoque aucune erreur d'exécution, elle donne seulement un résultat faux.
4.4.1 Parcourir une matrice
def somme_matrice(m):
    """Somme de tous les coefficients de la matrice m.

    Précondition : m est un tableau non vide de tableaux de même longueur.
    """
    assert len(m) > 0
    assert all(len(ligne) == len(m[0]) for ligne in m), "lignes de longueurs inegales"
    total = 0
    for i in range(len(m)):
        for j in range(len(m[i])):
            total = total + m[i][j]
    return total
Deux boucles imbriquées : la première choisit la ligne, la seconde la parcourt. Sur une matrice de lignes et colonnes, le corps s'exécute fois — le coût est proportionnel au nombre de cases, ce qui paraît évident ici et le sera moins au chapitre 7.
4.4.2 Construire une matrice, et le piège qui va avec
Pour créer une grille de zéros à 2 lignes et 3 colonnes, on est tenté d'écrire :
grille = [[0] * 3] * 2        # NE JAMAIS ÉCRIRE CELA
grille[0][0] = 5
print(grille)                 # [[5, 0, 0], [5, 0, 0]]   <- les DEUX !
L'opérateur ne recopie* pas la ligne : il répète la même ligne deux fois. Le tableau extérieur contient deux références vers un unique tableau intérieur — modifier « une » ligne les modifie toutes.
La construction correcte passe par une compréhension, qui évalue [0] * 3 à chaque tour et crée donc des lignes distinctes :
grille = [[0] * 3 for _ in range(2)]
grille[0][0] = 5
print(grille)                 # [[5, 0, 0], [0, 0, 0]]   <- correct
Ce défaut ne provoque aucun message. Il produit des résultats faux, souvent longtemps après. Le seul moyen de s'en prémunir est de l'avoir vu une fois — c'est chose faite.
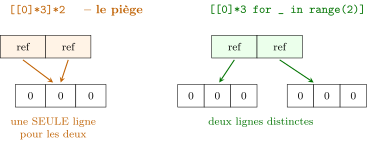
même tableau, et modifier l'une modifie l'autre. À droite, la compréhension évalue [0]*3 à chaque tour et crée deux tableaux.</div>
def matrice_nulle(nb_lignes, nb_colonnes):
    """Matrice de zéros. Précondition : dimensions strictement positives."""
    assert nb_lignes > 0 and nb_colonnes > 0
    return [[0] * nb_colonnes for _ in range(nb_lignes)]


def transposee(m):
    """Transposée de m : la case (i, j) du résultat vaut m[j][i].

    Précondition  : m est non vide, à lignes de même longueur.
    Postcondition : le résultat a len(m[0]) lignes et len(m) colonnes.
    """
    assert len(m) > 0 and all(len(l) == len(m[0]) for l in m)
    t = [[m[j][i] for j in range(len(m))] for i in range(len(m[0]))]
    assert len(t) == len(m[0]) and len(t[0]) == len(m)
    return t
Piste de projet : Un jeu sur grille
Les matrices sont le support naturel d'un premier projet à trois : morpion, puissance 4, jeu de la vie, démineur. Le cahier des charges minimal : une fonction qui crée la grille, une qui l'affiche, une qui teste si un coup est légal, une qui applique un coup, une qui détecte la fin de partie — chacune avec ses préconditions et son jeu de tests, comme au chapitre 3.
Le jeu de la vie a un mérite particulier : il oblige à construire la génération suivante dans une nouvelle matrice, sans quoi les cellules déjà mises à jour faussent le calcul des suivantes. C'est une leçon d'algorithmique déguisée en jeu.