Les dictionnaires
Cours complet · NSI (première), chapitre 5 · première, spécialité numérique et sciences informatiques
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Le tableau du chapitre précédent repère ses éléments par un entier : le premier, le deuxième, le millième. C'est commode quand la position a un sens — les pixels d'une ligne, les termes d'une suite. Mais bien des données ne se rangent pas ainsi. L'âge d'un élève n'est pas « le troisième âge » : c'est l'âge de Nour. Le nombre d'occurrences de la lettre e n'est pas à la case 4 : il est à la case "e".
Le dictionnaire répond exactement à ce besoin : repérer une valeur non par un rang, mais par une autre valeur.
5.1 Clés et valeurs
Un dictionnaire est une collection de couples dans laquelle chaque clé apparaît au plus une fois, et donne accès à la valeur qui lui est associée. On le note entre accolades, les couples séparés par des virgules et écrits clé : valeur.
ages = {"Nour": 17, "Camille": 16, "Yanis": 17}

ages["Nour"]          # 17 : accès par la CLÉ, pas par un rang
len(ages)             # 3  : nombre de couples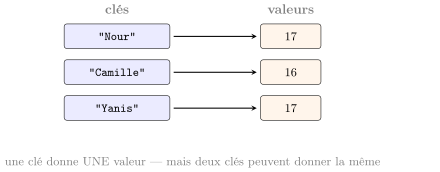
sont pas — ici, deux élèves ont 17 ans.</div>
Deux remarques immédiates, et les deux comptent :
- les clés sont uniques, les valeurs non. Ici, deux élèves ont 17 ans : la valeur apparaît deux fois, mais
"Nour"n'apparaît qu'une. - il n'y a pas d'ordre à exploiter. On ne demande pas « le deuxième élément » d'un dictionnaire : la question n'a pas de sens dans la structure.
Depuis Python 3.7, un dictionnaire restitue ses couples dans l'ordre où ils ont été insérés. C'est une commodité de Python, pas une propriété des dictionnaires : dans d'autres langages, et dans la notion elle-même, l'ordre est arbitraire. N'écrivez jamais un programme dont la correction dépend de cet ordre — il n'aurait de sens que sur Python, et il en dépendrait sans le dire.
5.2 Construire, lire, modifier
Capacité attendue
« Construire une entrée de dictionnaire. »
ages = {}                       # dictionnaire vide
ages["Nour"] = 17               # création d'une entrée
ages["Camille"] = 16
ages["Nour"] = 18               # la MÊME clé : la valeur est remplacée, pas ajoutée

"Nour" in ages                  # True  : test d'appartenance, porte sur les CLÉS
"Yanis" in ages                 # False
del ages["Camille"] # suppression d'une entréeages["Nour"] = 18 crée l'entrée si la clé est absente, et remplace la valeur si elle est présente. Rien ne distingue les deux cas à l'écriture — c'est commode, et c'est dangereux : une faute de frappe dans une clé ne provoque aucune erreur, elle crée une entrée de plus. Un dictionnaire censé avoir trois clés en a alors quatre, et le programme continue.
ages["Inconnu"] lève KeyError — contrairement à l'écriture, qui aurait créé l'entrée. Quand l'absence est un cas normal, deux réflexes :
if "Inconnu" in ages:           # tester avant de lire
    ...
ages.get("Inconnu", 0)          # ou demander une valeur par défaut
get ne crée rien : il renvoie la valeur par défaut sans toucher au dictionnaire.
5.2.1 Quelles valeurs peuvent servir de clés ?
positions = {}
positions[(2, 3)] = "tour"      # un p-uplet peut être une clé
positions[[2, 3]] = "tour" # TypeError: unhashable type: 'list'Une clé doit être non modifiable. La raison est simple : le dictionnaire range la valeur à un emplacement calculé à partir de la clé. Si la clé changeait après coup, la valeur resterait là où l'ancienne clé l'avait mise, et deviendrait introuvable.
C'est ici que l'immuabilité du p-uplet, présentée au chapitre 4 comme une contrainte, se révèle être un pouvoir : un couple de coordonnées peut servir de clé, un tableau non. Une grille creuse — un plateau d'échecs où l'on ne stocke que les cases occupées — s'écrit naturellement {(2, 3): "tour", (7, 0): "roi"}.
5.3 Itérer sur un dictionnaire
Capacité attendue
« Itérer sur les éléments d'un dictionnaire. »
Le programme demande explicitement de connaître les trois méthodes keys(), values() et items().
ages = {"Nour": 17, "Camille": 16, "Yanis": 17}

for cle in ages:                    # par défaut, on parcourt les CLÉS
    print(cle)                      # Nour, Camille, Yanis

for cle in ages.keys():             # explicite, et strictement équivalent
    print(cle)

for age in ages.values():           # les VALEURS seules
    print(age)                      # 17, 16, 17

for cle, age in ages.items():       # les COUPLES, déballés à la volée
    print(cle, "a", age, "ans")
Méthode : Lequel choisir ?
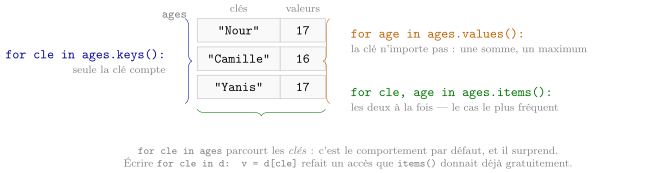
items() dès qu'on a besoin des deux — c'est le cas le plus fréquent, et il évite le d[cle] superflu à l'intérieur de la boucle. values() quand la clé n'importe pas : une somme, un maximum. keys() quand seule la clé compte. Écrire for cle in d: v = d[cle] fonctionne, mais refait un accès que items() donnait gratuitement.
Les trois méthodes ne diffèrent que par la part du dictionnaire qu'elles livrent :
Ajouter ou supprimer une entrée pendant qu'on itère lève RuntimeError: dictionary changed size during iteration. Pour supprimer selon un critère, on constitue d'abord la liste des clés à retirer, puis on retire.
5.4 Le dictionnaire comme enregistrement
Le chapitre 4 a présenté le p-uplet nommé — un enregistrement à champs nommés. Le programme signale qu'« en Python, les p-uplets nommés sont implémentés par des dictionnaires », et c'est bien la forme la plus courante :
photo = {"largeur": 4032, "hauteur": 3024, "iso": 200,
         "date": "2026-08-07", "appareil": "Pixel"}

photo["iso"] # 200Le programme cite explicitement cet exemple. Tout appareil photo numérique enregistre, à côté des pixels, un ensemble de champs nommés : dimensions, date de prise de vue, sensibilité ISO, temps de pose, parfois les coordonnées GPS. Ce sont les données EXIF, et leur structure est exactement celle d'un enregistrement — des champs nommés, de types différents.
Elles fournissent aussi une leçon qui n'est pas technique : une photographie publiée en ligne transporte, sauf effacement délibéré, la date, l'appareil et parfois le lieu où elle a été prise.
Un tableau de dictionnaires partageant les mêmes clés, c'est précisément une table — une liste d'enregistrements aux mêmes descripteurs. C'est l'objet du chapitre 6, et la forme sous laquelle arrivent les données d'un fichier CSV.
5.5 Pourquoi c'est rapide
"Nour" in ages          # dictionnaire : coût indépendant du nombre de clés
"Nour" in noms # tableau : il faut parcourir, jusqu'à n comparaisonsChercher une clé dans un dictionnaire ne coûte pas plus cher qu'il y ait dix entrées ou un million ; chercher une valeur dans un tableau exige de le parcourir. Sur un tableau de d'éléments, la différence n'est pas d'un facteur deux : elle est d'un facteur .
Le mécanisme : la position est calculée à partir de la clé, comme l'adresse d'une case de tableau était calculée à partir de son indice au chapitre 4. C'est la même idée, appliquée à une clé qui n'est pas un entier.
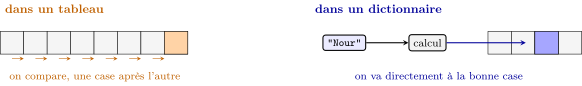
dépend pas. Sur un million d'entrées, l'écart n'est pas d'un facteur deux.</div>
Hors programme : Le mécanisme n'est pas au programme
Ce calcul s'appelle le hachage, et son étude — fonction de hachage, collisions, table de hachage — relève de la classe terminale. En première, on retient le résultat : l'accès par clé est direct, et c'est ce qui justifie de choisir un dictionnaire plutôt qu'un tableau quand on interroge souvent par un identifiant.
Repère historique : Calculer l'emplacement plutôt que le chercher
L'idée de déduire l'adresse d'une donnée à partir de son contenu, au lieu de la chercher, remonte au tout début des années 1950 ; on l'attribue généralement à Hans Peter Luhn, chez IBM, vers 1953. Elle est aujourd'hui partout : les dictionnaires de Python, les tables des bases de données, les index des moteurs de recherche, la vérification des mots de passe.
Le tableau associatif fait d'ailleurs partie de ces notions que presque tous les langages proposent sous un nom différent : dictionary en Python, map en C++ et en Java, object en JavaScript, table de hachage en OCaml. Le nom change, la notion non — c'est l'unité des langages du chapitre 3.
5.6 L'usage qui revient partout : compter
def occurrences(t):
    """Nombre d'occurrences de chaque élément de t.

    Précondition  : les éléments de t peuvent servir de clés (non modifiables).
    Postcondition : la somme des valeurs du résultat vaut len(t), et chaque
                    clé du résultat apparaît dans t.
    """
    compte = {}
    for x in t:
        if x in compte:
            compte[x] = compte[x] + 1
        else:
            compte[x] = 1
    assert sum(compte.values()) == len(t)
    return compte
>>> occurrences("anticonstitutionnellement")
{'a': 1, 'n': 5, 't': 5, 'i': 3, 'c': 1, 'o': 2, 's': 1,
 'u': 1, 'e': 3, 'l': 2, 'm': 1}
Méthode : La variante en une ligne
Le motif « si la clé existe, incrémenter ; sinon, initialiser » est si fréquent que get le condense :
compte[x] = compte.get(x, 0) + 1La valeur par défaut tient lieu de cas d'initialisation. Les deux versions sont correctes ; la première montre le raisonnement, la seconde s'écrit une fois qu'on l'a compris.
def plus_frequent(t):
    """Un élément le plus fréquent de t, et son nombre d'occurrences.

    Précondition : t est non vide.
    Renvoie un couple (element, effectif). En cas d'ex aequo, l'un d'eux.
    """
    assert len(t) > 0, "t doit etre non vide"
    compte = occurrences(t)
    meilleur = None
    effectif = 0
    for x, n in compte.items():
        if n > effectif:
            meilleur, effectif = x, n
return meilleur, effectifEn cas d'ex aequo, cette fonction renvoie le premier maximum rencontré — c'est-à-dire, en Python, celui qui a été inséré le premier. Le cas n'a rien de théorique : dans "anticonstitutionnellement", les lettres n et t apparaissent cinq fois chacune, et plus_frequent renvoie n parce qu'elle a été rencontrée d'abord. La docstring dit « l'un d'eux » plutôt que de promettre lequel. Une spécification ne doit pas promettre plus que ce que l'algorithme garantit : sinon la promesse sera fausse le jour où l'ordre de parcours changera.
Piste de projet : Analyser un texte
À partir d'un fichier texte — un roman du domaine public convient très bien —, produire : la fréquence de chaque lettre, celle de chaque mot, les vingt mots les plus employés, et un graphique. Prolongements possibles : comparer deux auteurs, comparer deux langues, et confronter les fréquences de lettres obtenues à celles qui servent au déchiffrement des messages codés.
Le projet mobilise les chapitres 2 (encodage du fichier), 4 (tableaux) et 5, et se prête à un groupe de deux à quatre.