Traiter des données en tables
Cours · NSI (première), chapitre 6 · première, spécialité numérique et sciences informatiques · le début du chapitre, la suite sur Adloun
Les deux chapitres précédents ont donné deux structures. En les combinant, on obtient celle qui porte la quasi-totalité des données du monde réel : un tableau de dictionnaires partageant les mêmes clés. Le programme le dit ainsi — « les données organisées en table correspondent à une liste de p-uplets nommés qui partagent les mêmes descripteurs ».
Résultats sportifs, relevés météo, catalogues, horaires de transport, données ouvertes des administrations : tout cela arrive en tables, et le plus souvent dans un fichier CSV.
Hors programme : Ce n'est pas encore une base de données
Le programme est net : cette rubrique « permet de préparer les élèves à aborder la notion de base de données qui ne sera présentée qu'en classe terminale », et il s'agit de travailler « dans un langage de programmation ordinaire et non dans un système de gestion de bases de données ». Aucun SQL ici, aucun SGBD : du Python, des tableaux et des dictionnaires.
6.1 Ce qu'est une table
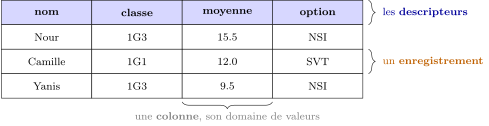
Une table est un tableau d'enregistrements qui possèdent tous les mêmes champs. Le nom d'un champ s'appelle un descripteur — c'est le titre de la colonne ; un enregistrement est une ligne.
eleves = [
    {"nom": "Nour",    "classe": "1G3", "moyenne": 15.5,  "option": "NSI"},
    {"nom": "Camille", "classe": "1G1", "moyenne": 12.0,  "option": "SVT"},
    {"nom": "Yanis",   "classe": "1G3", "moyenne": 9.5,   "option": "NSI"},
]
Deux façons de désigner une case, et le programme les autorise toutes deux : le tableau de p-uplets nommés ci-dessus — eleves[0]["moyenne"] — ou le tableau doublement indexé du chapitre 4 — t[0][2]. La première est préférable dès que les colonnes ont un sens : ["moyenne"] reste juste si l'on insère une colonne, [2] devient faux en silence. C'est l'argument du chapitre 4 sur les p-uplets nommés, appliqué à des milliers de lignes.
6.2 Importer une table
Capacité attendue
« Importer une table depuis un fichier texte tabulé ou un fichier CSV. »
Un fichier CSV (comma-separated values) est un fichier texte où chaque ligne est un enregistrement et où les champs sont séparés par un caractère convenu — le plus souvent la virgule, parfois le point-virgule ou une tabulation. La première ligne porte généralement les descripteurs.
nom,classe,moyenne,option
Nour,1G3,15.5,NSI
Camille,1G1,12.0,SVT
Yanis,1G3,9.5,NSI
Sofia,1G2,17.25,NSI
Adam,1G1,13.0,SES
import csv

def importer(chemin, separateur=","):
    """Table lue depuis un fichier CSV à ligne d'en-tête.

    Précondition  : le fichier existe, est encodé en UTF-8, et sa première
                    ligne porte les descripteurs.
    Postcondition : toutes les lignes renvoyées ont exactement les mêmes clés.
    """
    with open(chemin, "r", encoding="utf-8", newline="") as f:
        table = [dict(ligne) for ligne in csv.DictReader(f, delimiter=separateur)]
    if len(table) > 0:
        descripteurs = set(table[0].keys())
        assert all(set(l.keys()) == descripteurs for l in table), "lignes heterogenes"
return tableC'est le piège numéro un du chapitre. Un fichier texte ne contient que des caractères : après l'import, ligne["moyenne"] vaut la chaîne "15.5", pas le nombre . Les conséquences sont silencieuses et fausses :
"9.5" > "15.5"          # True  <- chaines : '9' vient apres '1'
9.5 > 15.5              # False <- la verite
Une table triée par moyenne sans conversion place donc les mauvais élèves en tête, sans le moindre message d'erreur. Convertir les colonnes numériques fait partie de l'import, pas des finitions.
Exercices du chapitre
- Écrire projection(table, colonnes) qui renvoie la table réduite aux… corrigé
- Écrire moyenne colonne(table, colonne) corrigé
- Écrire groupe par(table, colonne) , qui rend un dictionnaire associant… corrigé
- Écrire agreger(table, cle, colonne, fonction) qui applique fonction… corrigé
- Écrire un contrôle de cohérence complet de la table corrigé
- Un tableur français a exporté la colonne moyenne avec des virgules… corrigé