Parcourir, trier, prouver
Cours complet · NSI (première), chapitre 7 · première, spécialité numérique et sciences informatiques
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Jusqu'ici, on a écrit des programmes et on les a testés. Le chapitre 3 disait déjà pourquoi cela ne suffit pas : « le succès d'un jeu de tests ne garantit pas la correction d'un programme ». Un test porte sur une entrée ; un programme doit être juste sur toutes.
Ce chapitre franchit le pas. On y écrit les algorithmes classiques du programme — parcours, recherche, tris — et surtout on apprend à démontrer qu'ils sont corrects et qu'ils s'arrêtent, à l'aide de deux outils : l'invariant et le variant. C'est le moment où l'informatique cesse d'être une affaire d'essais pour devenir une science.
7.1 Le parcours séquentiel
Capacité attendue
« Écrire un algorithme de recherche d'une occurrence sur des valeurs de type quelconque. Écrire un algorithme de recherche d'un extrémum, de calcul d'une moyenne. »
7.1.1 Rechercher une occurrence
def recherche(t, v):
    """Indice de la PREMIÈRE occurrence de v dans t, ou -1 si v n'y figure pas.

    Précondition  : les éléments de t sont comparables à v par ==.
    Postcondition : si le résultat r vaut -1, aucun élément de t n'est égal
                    à v ; sinon 0 <= r < len(t) et t[r] == v.
    """
    for i in range(len(t)):
        if t[i] == v:
            return i
return -1Le programme précise « sur des valeurs de type quelconque » : rien dans cette fonction ne suppose des nombres. Elle cherche aussi bien une chaîne, un p-uplet ou un booléen — seule l'égalité est requise. C'est ce qui la rend réutilisable, et c'est un trait à rechercher dans tout algorithme.
Complexité : Coût de la recherche séquentielle
Dans le pire cas — la valeur absente, ou placée en dernier — la boucle effectue comparaisons sur un tableau de éléments. Le coût est linéaire : doubler la taille du tableau double le travail. Le programme le formule ainsi : « on montre que le coût est linéaire ».
7.1.2 Extrémum et moyenne
def indice_maximum(t):
    """Indice d'un plus grand élément de t.

    Précondition  : t est non vide.
    Postcondition : t[r] >= t[k] pour tout k. En cas d'ex aequo, l'indice
                    du PREMIER maximum rencontré.
    """
    assert len(t) > 0, "tableau vide"
    m = 0
    for i in range(1, len(t)):
        if t[i] > t[m]:
            m = i
    return m


def moyenne(t):
    """Moyenne arithmétique de t. Précondition : t est un tableau non vide
    de nombres. La postcondition est celle du chapitre 3, avec sa tolérance."""
    assert len(t) > 0, "tableau vide"
    total = 0
    for x in t:
        total = total + x
    return total / len(t)
Attention à la notation : dans le code ci-dessus, m = 0 est correct, car m y désigne un indice — celui du premier élément. L'erreur du chapitre 3 était tout autre : y initialiser la valeur du maximum à , ce qui donne le maximum entre et le tableau, et renvoie si tous les éléments sont négatifs.
La règle est la même dans les deux cas : on part du premier élément, jamais d'une constante choisie d'avance. D'où la précondition « t est non vide », sans laquelle ni t[0] ni l'indice n'auraient de sens. Elle n'est pas là pour faire joli : elle rend l'initialisation légitime.
7.2 Prouver qu'une boucle est correcte : l'invariant
Un invariant de boucle est une propriété qui est vraie avant d'entrer dans la boucle et qui reste vraie après chaque tour. Si l'on montre de plus que, à la sortie, l'invariant entraîne le résultat voulu, on a prouvé la correction de la boucle — sur toutes les entrées à la fois.
La démonstration se fait toujours en trois temps, et il faut les trois :
- Initialisation : l'invariant est vrai avant le premier tour.
- Conservation : s'il est vrai avant un tour, il l'est encore après.
- Terminaison : quand la boucle s'arrête, l'invariant plus la condition d'arrêt donnent le résultat cherché.
Invariant : avant le tour d'indice , la variable m contient l'indice d'un plus grand élément parmi t[0..i-1].
Initialisation. Avant le premier tour, et m vaut : c'est bien l'indice du maximum de t[0..0], qui n'a qu'un élément.
Conservation. Supposons l'invariant vrai avant le tour . Le tour compare t[i] à t[m]. Si t[i] est plus grand, m devient ; sinon m ne change pas. Dans les deux cas, m désigne un plus grand élément de t[0..i] — donc l'invariant est vrai avant le tour .
Terminaison. La boucle s'arrête pour . L'invariant dit alors que m est l'indice d'un plus grand élément de t[0..n-1], c'est-à-dire du tableau entier. C'est exactement la postcondition.
L'invariant se voit bien si l'on dessine la frontière qu'il déplace :
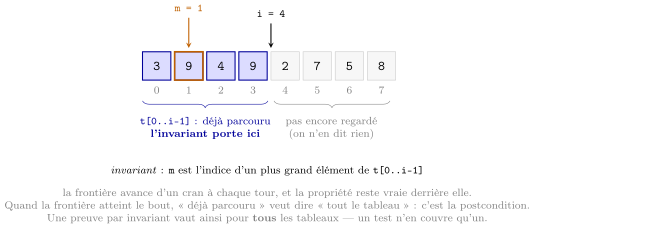
Remarquez ce que cette preuve a de plus qu'un test : elle ne parle d'aucun tableau particulier. Elle vaut pour tous les tableaux non vides, de toutes tailles, de tous contenus — y compris ceux auxquels on n'a pas pensé. C'est là toute la différence.
7.3 Le tri par sélection
Capacité attendue
« Écrire un algorithme de tri. Décrire un invariant de boucle qui prouve la correction des tris par insertion, par sélection. »
Le principe : chercher le plus petit élément de la partie non triée, et l'amener à sa place définitive.
def tri_selection(t):
    """Trie le tableau t par ordre croissant, SUR PLACE.

    Postcondition : t est croissant et contient exactement les mêmes
                    éléments qu'au départ.
    """
    n = len(t)
    for i in range(n - 1):
        # invariant : t[0..i-1] est trié et contient les i plus petits
        #             éléments du tableau initial
        m = i
        for j in range(i + 1, n):
            if t[j] < t[m]:
                m = j
        t[i], t[m] = t[m], t[i]        # l'échange du chapitre 4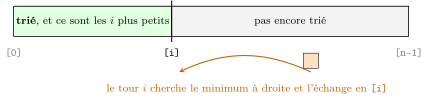
est à gauche ne bouge plus jamais.</div>
Démonstration (Correction)
Invariant : avant le tour , t[0..i-1] est trié par ordre croissant et contient les plus petits éléments du tableau, tandis que t[i..n-1] contient les autres.
Initialisation. Pour , la partie t[0..-1] est vide : elle est triée et contient les plus petits éléments. Vrai.
Conservation. La boucle interne calcule l'indice m d'un plus petit élément de t[i..n-1] — c'est l'invariant de la section précédente, appliqué à un sous-tableau. L'échange place cet élément en position . Comme, par hypothèse, tous les éléments de t[0..i-1] sont plus petits que ceux de t[i..n-1], le nouvel élément en position est supérieur ou égal à tous ceux qui le précèdent : t[0..i] est donc trié et contient les plus petits éléments.
Terminaison. À la sortie, : t[0..n-2] est trié et contient les plus petits éléments. Le dernier élément restant est donc le plus grand, et il est déjà à sa place — c'est pourquoi la boucle s'arrête à et non à .
Enfin, la seule opération qui modifie le tableau est un échange : le contenu est donc préservé, ce qui établit la seconde moitié de la postcondition.
Complexité : Coût du tri par sélection
Au tour , la boucle interne effectue comparaisons. Le total vaut
Le coût est quadratique : il croît comme le carré de la taille. Doubler le tableau multiplie le travail par quatre.
Ce nombre ne dépend pas du contenu : un tableau déjà trié coûte exactement autant qu'un tableau en désordre. Le tri par sélection n'a ni meilleur ni pire cas.
7.4 Le tri par insertion
Le principe est celui du joueur de cartes : prendre les cartes une à une et insérer chacune à sa place parmi celles déjà en main.
def tri_insertion(t):
    """Trie le tableau t par ordre croissant, SUR PLACE.

    Postcondition : t est croissant et contient exactement les mêmes
                    éléments qu'au départ.
    """
    for i in range(1, len(t)):
        # invariant : t[0..i-1] est trié
        x = t[i]                       # la carte que l'on insère
        j = i
        while j > 0 and t[j - 1] > x:  # variant : j décroît strictement
            t[j] = t[j - 1]            # on décale vers la droite
            j = j - 1
        t[j] = x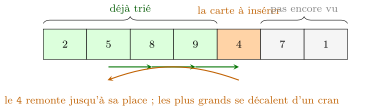
carte s'arrête tout de suite : c'est pourquoi ce tri devient linéaire dans son meilleur cas.</div>
Démonstration (Correction)
Invariant : avant le tour , t[0..i-1] est trié et contient les mêmes éléments que les premiers du tableau initial.
Initialisation. Pour , t[0..0] n'a qu'un élément : il est trié.
Conservation. La boucle interne décale vers la droite tous les éléments de t[0..i-1] strictement supérieurs à x, puis dépose x dans le trou. Les éléments décalés restent dans le même ordre relatif, ceux qui précèdent x lui sont inférieurs ou égaux, ceux qui le suivent lui sont supérieurs : t[0..i] est donc trié, et contient les mêmes éléments qu'avant plus x.
Terminaison. À la sortie, : t[0..n-1] est trié. C'est la postcondition.
7.4.1 La terminaison ne va plus de soi
Le tri par sélection n'emploie que des boucles for : elles font un nombre de tours connu d'avance, donc elles s'arrêtent — c'est acquis depuis le chapitre 3. Le tri par insertion contient une boucle while : rien ne garantit a priori qu'elle s'arrête. Il faut le prouver.
Un variant de boucle est une quantité entière, positive ou nulle, qui décroît strictement à chaque tour. Une telle quantité ne peut pas décroître indéfiniment en restant positive : la boucle s'arrête donc nécessairement, après un nombre fini de tours.
Démonstration (Terminaison de la boucle interne)
Prenons la variable j comme variant.
Elle est entière et positive : la condition j > 0 garantit qu'on n'entre dans le corps que si j , et le corps la ramène à j .
Elle décroît strictement : le corps exécute j = j - 1, sans aucune autre affectation à j.
Une suite d'entiers positifs strictement décroissante est finie : la boucle s'arrête en au plus tours.
La condition s'écrit while j > 0 and t[j - 1] > x — dans cet ordre. Inversée, elle évaluerait t[j - 1] avec j valant , donc t[-1] : en Python, le dernier élément du tableau, ce qui ne provoque aucune erreur mais compare n'importe quoi. C'est l'évaluation en court-circuit du chapitre 2, et c'est ici qu'elle protège la correction de l'algorithme.
Complexité : Coût du tri par insertion
Contrairement au tri par sélection, il dépend du contenu.
Meilleur cas — tableau déjà trié. La condition t[j-1] > x est fausse d'emblée à chaque tour : une seule comparaison par élément, soit au total. Le coût est linéaire.
Pire cas — tableau trié à l'envers. Chaque élément doit remonter jusqu'au début : comparaisons. Le coût est quadratique, comme le tri par sélection.
Les deux sont quadratiques dans le pire cas, et le programme n'en demande pas davantage. Une différence mérite pourtant d'être connue : sur des données presque triées — le cas fréquent en pratique — le tri par insertion est très rapide, alors que le tri par sélection paie toujours le plein tarif. C'est pour cette raison qu'il sert encore, à l'intérieur d'algorithmes de tri plus élaborés, sur les petits sous-tableaux.
Repère historique : La preuve avant la machine
L'idée qu'un programme se démontre plutôt qu'il ne s'essaie est aussi ancienne que l'informatique elle-même : elle apparaît dès la fin des années 1940 chez Alan Turing, et elle est formalisée en 1969 par Tony Hoare, qui propose une logique où l'on écrit — « si est vraie avant l'exécution de , alors est vraie après ». Vos préconditions et postconditions du chapitre 3 sont exactement ce et ce ; les invariants de ce chapitre sont ce qui permet de franchir une boucle.
Hoare est aussi l'auteur, en 1961, du tri rapide (quicksort) — dont l'étude viendra plus tard. Un même chercheur aura donc donné à la fois un algorithme célèbre et le moyen de prouver qu'un algorithme est juste.
7.5 Mesurer plutôt que croire
def tri_selection_compte(t):
    """Comme tri_selection, mais renvoie le nombre de comparaisons."""
    n = len(t)
    comparaisons = 0
    for i in range(n - 1):
        m = i
        for j in range(i + 1, n):
            comparaisons = comparaisons + 1
            if t[j] < t[m]:
                m = j
        t[i], t[m] = t[m], t[i]
return comparaisons| Sélection | Insertion | |||
|---|---|---|---|---|
| tous les cas | trié | aléatoire | trié à l'envers | |
| 10 | 45 | 9 | 30 | 45 |
| 100 | 4 950 | 99 | 2 565 | 4 950 |
| 200 | 19 900 | 199 | 10 144 | 19 900 |
Les colonnes « trié » et « trié à l'envers » sont exactes ; la colonne « aléatoire » est une moyenne sur 400 tirages, et elle vaut environ la moitié du pire cas — ce qui se comprend : en moyenne, un élément doit remonter la moitié de la partie déjà triée.
Deux enseignements. La colonne « sélection » ne bouge jamais, et vaut exactement — pour . Et quand double, de 100 à 200, ce nombre est multiplié par quatre : c'est cela, un coût quadratique. La colonne « trié » du tri par insertion, elle, ne fait que doubler.
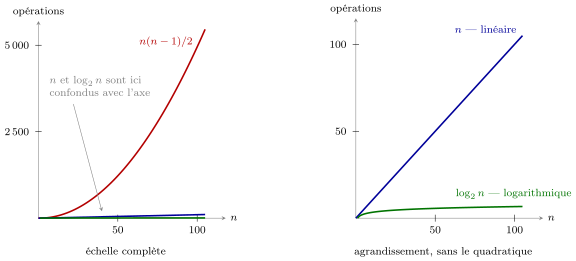
recherche dichotomique, 100 pour le parcours séquentiel, 4 950 pour le tri par sélection. Il faut deux cadrans parce qu'aucune échelle unique ne les montre tous : à gauche le quadratique écrase les deux autres, à droite l'agrandissement sépare enfin le linéaire du logarithmique.</div>
Piste de projet : Un banc d'essai de tris
Écrire un programme qui compare expérimentalement les deux tris : nombre de comparaisons et durée, sur des tableaux triés, aléatoires et inversés, pour des tailles croissantes. Tracer les courbes, et vérifier que celle du tri par sélection suit bien .
L'exigence intéressante n'est pas de coder les tris — c'est fait — mais de construire un protocole honnête : plusieurs tirages par taille, tableaux identiques pour les deux algorithmes, et un compte rendu qui distingue ce qui a été mesuré de ce qui a été prédit.