Dichotomie, voisins et gloutons
Cours complet · NSI (première), chapitre 8 · première, spécialité numérique et sciences informatiques
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Le chapitre précédent a démontré la correction de boucles ; celui-ci en tire parti pour trois algorithmes qui, chacun, illustrent une idée différente. La recherche dichotomique montre ce qu'on gagne à exploiter une structure — ici, le fait que le tableau soit trié. Les plus proches voisins montrent qu'un algorithme peut prédire. Les algorithmes gloutons montrent qu'une stratégie simple peut être excellente… ou fausse, et qu'il faut savoir dire laquelle.
8.1 La recherche dichotomique
8.1.1 Diviser l'intervalle par deux
Chercher un mot dans un dictionnaire papier, personne ne le fait en partant de la première page. On ouvre au milieu, on regarde si le mot cherché est avant ou après, et on recommence sur la moitié retenue. Chaque coup d'œil élimine la moitié de ce qui reste.
Capacité attendue
« Montrer la terminaison de la recherche dichotomique à l'aide d'un variant de boucle. »
def dichotomie(t, v):
    """Indice d'une occurrence de v dans le tableau TRIÉ t, ou -1 si absente.

    Précondition  : t est trié par ordre croissant.
    Postcondition : si le résultat r vaut -1, v ne figure pas dans t ;
                    sinon t[r] == v.
    """
    gauche = 0
    droite = len(t) - 1
    while gauche <= droite:
        # invariant : si v figure dans t, alors son indice est dans
        #             l'intervalle [gauche, droite]
        milieu = (gauche + droite) // 2
        if t[milieu] == v:
            return milieu
        elif t[milieu] < v:
            gauche = milieu + 1
        else:
            droite = milieu - 1
    return -1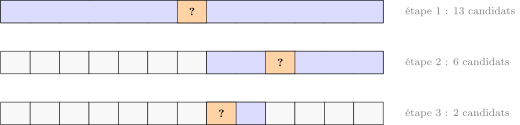
trente comparaisons suffisent pour un milliard d'éléments.</div>
Sur un tableau non trié, cette fonction ne renvoie pas une erreur : elle renvoie une réponse fausse. Elle peut annoncer pour une valeur présente. C'est le cas le plus dangereux — un programme qui se trompe sans le dire — et c'est pourquoi la précondition « est trié » doit être vérifiée par celui qui appelle, ou coûteusement par la fonction elle-même.
8.1.2 La terminaison, par un variant
Démonstration (Terminaison)
Prenons pour variant la quantité
c'est-à-dire le nombre d'indices encore candidats.
Elle est entière. gauche et droite sont des entiers.
Elle est positive tant qu'on boucle. La condition d'entrée est gauche <= droite, donc à chaque tour.
Elle décroît strictement. Le corps exécute soit gauche = milieu + 1, soit droite = milieu - 1, où vérifie . Dans le premier cas, gauche augmente d'au moins ; dans le second, droite diminue d'au moins . Dans les deux cas, diminue d'au moins .
Une suite d'entiers positifs strictement décroissante étant finie, la boucle s'arrête.
Démonstration (Correction)
Invariant : si figure dans , alors il figure dans la tranche t[gauche..droite].
Initialisation. Au départ, la tranche est le tableau entier : l'invariant est trivialement vrai.
Conservation. Supposons l'invariant vrai. Si , alors — le tableau étant trié — tous les éléments d'indice sont : aucun ne peut valoir , et l'on peut sans risque poser . Le cas symétrique se traite de même. L'invariant est conservé.
Terminaison. La boucle s'achève quand , c'est-à-dire quand la tranche est vide. L'invariant dit alors que si figurait dans , il serait dans une tranche vide : c'est impossible, donc n'y figure pas, et renvoyer est juste.
Hors programme
Le programme note que « la preuve de la correction peut être présentée par le professeur » : c'est la terminaison, par le variant, qui est exigible de l'élève. La démonstration ci-dessus est donnée pour ceux qui veulent voir jusqu'au bout ce que « prouver un programme » veut dire.
8.1.3 Ce que l'on gagne
Complexité : Coût de la recherche dichotomique
À chaque tour, le nombre de candidats est au moins divisé par deux. Partant de , il faut donc au plus tours pour tomber à zéro — c'est exactement le nombre de bits de , calculé au chapitre 1.
Le coût est logarithmique. La comparaison avec la recherche séquentielle du chapitre 7 est spectaculaire :
| séquentielle | dichotomique | |
|---|---|---|
| 100 | 7 | |
| 1 000 | 10 | |
| 1 000 000 | 20 | |
| 1 000 000 000 | 30 |
Un milliard d'éléments : trente comparaisons. Multiplier la taille par mille n'ajoute que dix tours.
Les chiffres disent l'écart mieux qu'une formule :
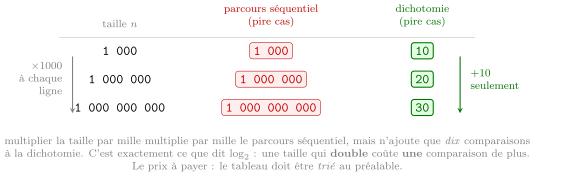
La dichotomie exige un tableau trié, et trier coûte cher — quadratique avec les tris du chapitre 7. Le calcul est donc à faire : pour une recherche, le parcours séquentiel gagne ; pour des milliers de recherches sur les mêmes données, trier une fois puis chercher en logarithmique gagne largement. C'est exactement le raisonnement du chapitre 5 entre tableau et dictionnaire.
Repère historique : Vingt ans pour la mettre au point
L'idée de la dichotomie est ancienne — le premier programme publié date de 1946. Mais Donald Knuth relève que la première version correcte pour toutes les tailles de tableau n'a été publiée qu'en 1962 : les précédentes échouaient sur des cas limites, tableau vide ou valeur aux extrémités.
Plus troublant encore : en 2006, un défaut est découvert dans l'implémentation présente depuis neuf ans dans la bibliothèque standard de Java. Le calcul (gauche + droite) / 2 y provoquait un débordement d'entier (chapitre 1) sur les très grands tableaux. En Python, dont les entiers sont de taille arbitraire, le problème ne se pose pas — mais l'anecdote dit assez qu'un algorithme de dix lignes n'est pas pour autant un algorithme facile.
8.2 Les plus proches voisins
Capacité attendue
« Écrire un algorithme qui prédit la classe d'un élément en fonction de la classe majoritaire de ses plus proches voisins. »
Le programme le présente comme « un exemple d'algorithme d'apprentissage ». Le principe tient en une phrase : pour deviner à quelle catégorie appartient un nouvel individu, on regarde les individus connus qui lui ressemblent le plus, et on retient la catégorie la plus représentée parmi eux.
8.2.1 Mesurer la ressemblance
def distance(p, q):
    """Distance euclidienne entre deux points donnés par des p-uplets
    de même longueur.

    Précondition : len(p) == len(q).
    """
    assert len(p) == len(q), "dimensions differentes"
    somme = 0
    for i in range(len(p)):
        somme = somme + (p[i] - q[i]) ** 2
return somme ** 0.5Si une coordonnée est une taille en centimètres (autour de 170) et l'autre un nombre de frères et sœurs (entre 0 et 5), la première écrase complètement la seconde dans le calcul de la distance : l'algorithme ne « voit » plus que la taille. Il faut alors ramener chaque coordonnée à une échelle commune avant de mesurer. C'est un point que les cours d'apprentissage automatique appellent la normalisation ; on se contentera ici de choisir des données déjà comparables.
8.2.2 L'algorithme
def k_plus_proches_voisins(exemples, point, k):
    """Classe prédite pour point, par vote majoritaire de ses k plus
    proches voisins.

    exemples est un tableau de couples (coordonnees, classe).
    Précondition  : 1 <= k <= len(exemples).
    Postcondition : le résultat est l'une des classes présentes dans exemples.
    """
    assert 1 <= k <= len(exemples), "k hors bornes"

    # 1. distance de chaque exemple au point
    mesures = [(distance(coord, point), classe) for coord, classe in exemples]

    # 2. les k plus proches (tri du chapitre 6 : on a le droit de l'utiliser)
    mesures = sorted(mesures, key=lambda couple: couple[0])
    voisins = mesures[:k]

    # 3. vote majoritaire (le compteur du chapitre 5)
    votes = {}
    for _, classe in voisins:
        votes[classe] = votes.get(classe, 0) + 1

    meilleure = None
    meilleur_score = 0
    for classe, n in votes.items():
        if n > meilleur_score:
            meilleure, meilleur_score = classe, n
    return meilleure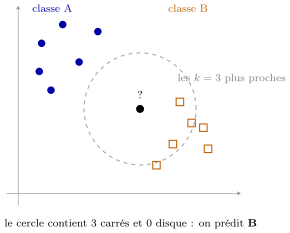
question qu'on mesure la distance à tous les exemples connus.</div>
L'algorithme n'est fait que de briques déjà connues : un parcours pour les distances, un tri, un comptage par dictionnaire. C'est très souvent ainsi qu'un algorithme « savant » se révèle à l'usage — un assemblage d'opérations élémentaires bien choisies.
Avec et deux classes à deux voix chacune, la fonction renvoie la première rencontrée : un choix arbitraire, hérité de l'ordre du dictionnaire. Deux parades, à connaître : prendre impair quand il n'y a que deux classes, ou départager par la distance. La docstring doit dire ce qui a été choisi — c'est la règle du chapitre 5 sur les ex æquo.
On parle d'« apprentissage », mais rien n'est appris au sens ordinaire : il n'y a aucune phase d'entraînement, aucun modèle construit. Toute la donnée est conservée, et le travail est fait au moment de la question. La conséquence pratique compte : prédire coûte cher, puisqu'il faut mesurer la distance à tous les exemples — le coût est linéaire en la taille du jeu de données, à chaque prédiction.
8.3 Les algorithmes gloutons
Capacité attendue
« Résoudre un problème grâce à un algorithme glouton. »
Un algorithme est glouton lorsqu'il construit une solution pas à pas, en faisant à chaque étape le choix qui paraît le meilleur sur le moment, sans jamais revenir sur une décision prise.
8.3.1 Le rendu de monnaie
def rendu_monnaie(somme, pieces):
    """Décomposition de somme avec les valeurs de pieces, par choix glouton.

    Précondition  : pieces est trié par ordre DÉCROISSANT et contient 1.
    Postcondition : la somme des valeurs rendues vaut exactement somme.
    """
    assert somme >= 0
    assert pieces == sorted(pieces, reverse=True), "pieces doit etre decroissant"
    assert 1 in pieces, "sans piece de 1, la decomposition peut echouer"

    rendu = []
    reste = somme
    for p in pieces:
        while reste >= p:          # variant : reste décroît strictement
            rendu.append(p)
            reste = reste - p
    assert sum(rendu) == somme
return renduAvec le système européen [200, 100, 50, 20, 10, 5, 2, 1] et une somme de centimes, l'algorithme rend , soit quatre pièces. C'est bien le minimum.
8.3.2 Là où le glouton se trompe
C'est le point essentiel de la section, et il vaut mieux le découvrir ici qu'à l'examen.
Prenons un système de pièces imaginaire : [6, 4, 1], et une somme de .
- Le glouton prend d'abord , puis complète : , soit trois pièces.
- L'optimum est , soit deux pièces.
L'algorithme rend une décomposition correcte — la somme est juste, la postcondition est respectée — mais pas la meilleure. Et il n'a aucun moyen de s'en apercevoir, puisqu'il ne revient jamais sur ses choix.
Le système européen, lui, a la propriété d'être « canonique » : le glouton y est toujours optimal. Ce n'est pas un hasard, c'est une propriété du jeu de valeurs — pas de l'algorithme.
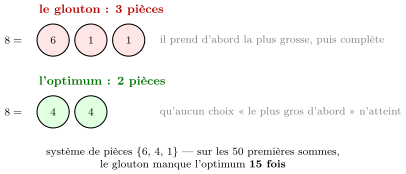
mais pas nécessairement la meilleure. Et il n'a aucun moyen de s'en apercevoir.</div>
8.3.3 Le sac à dos
Le second exemple cité par le programme. On dispose d'objets ayant chacun un poids et une valeur, et d'un sac de capacité limitée ; on veut emporter le plus de valeur possible.
def sac_a_dos_glouton(objets, capacite):
    """Sélection gloutonne par valeur massique décroissante.

    objets est un tableau de p-uplets (nom, poids, valeur).
    Précondition  : poids > 0 pour chaque objet, capacite >= 0.
    Postcondition : le poids total emporté ne dépasse pas capacite.
    Renvoie les noms choisis et la VALEUR totale emportée.
    """
    assert capacite >= 0
    assert all(poids > 0 for _, poids, _ in objets)

    tries = sorted(objets, key=lambda o: o[2] / o[1], reverse=True)
    choisis = []
    restant = capacite
    valeur_totale = 0
    for nom, poids, valeur in tries:
        if poids <= restant:
            choisis.append(nom)
            restant = restant - poids
            valeur_totale = valeur_totale + valeur
    assert restant >= 0, "le poids emporte depasse la capacite"
return choisis, valeur_totaleCapacité , et trois objets : (poids 6, valeur 30), (poids 5, valeur 20), (poids 5, valeur 20).
Les valeurs massiques valent pour , pour et . Le glouton prend donc , puis ne peut plus rien ajouter — il reste de capacité : total 30. L'optimum est , de poids et de valeur 40.
Parce que trouver l'optimum du sac à dos coûte, pour les meilleures méthodes connues, un temps qui explose avec le nombre d'objets, tandis que le glouton donne une réponse honnête en un tri. Sur beaucoup de problèmes réels, une bonne solution tout de suite vaut mieux que la meilleure trop tard.
Le programme situe d'ailleurs la chose : « les algorithmes gloutons constituent une méthode algorithmique parmi d'autres qui seront vues en terminale ». On y verra comment obtenir l'optimum — au prix d'un travail bien supérieur.
Piste de projet : Comparer les stratégies
Programmer, sur le rendu de monnaie ou le sac à dos, deux résolutions : la gloutonne, et l'exhaustive qui essaie toutes les combinaisons. Comparer les résultats et les temps, pour des tailles croissantes. Chercher, pour le rendu de monnaie, des systèmes de pièces où le glouton échoue — il en existe une infinité.
L'exhaustive devient impraticable très vite ; c'est justement ce qu'il faut mesurer et montrer.