informatique (MP2I/MPI) · Chapitre 18 · Application directe du cours
Dérouler Boyer-Moore, et compter
Algorithmique des textes · niveau 2
Énoncé
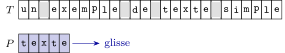
Sur et , donner les positions trouvées, puis comparer le nombre de comparaisons de caractères de Boyer-Moore et de la méthode naïve. Recommencer sur , .
Corrigé
Mesures (compteur sur le test p[j] == t[i+j]) :
T = "un exemple de texte simple"  (n=26), P = "texte" (m=5)
   Boyer-Moore : position 14, 11 comparaisons
   naif        : position 14, 28 comparaisons

T = 63 caracteres, P = "exemple" (m=7)
   Boyer-Moore : positions 29 et 41, 28 comparaisons
   naif        : positions 29 et 41, 78 comparaisons

T = "a"^100, P = "a"^5
   Boyer-Moore : 96 occurrences, 480 comparaisons
   naif        : 96 occurrences, 480 comparaisons
Sur du texte, Boyer-Moore fait comparaisons pour parcourir caractères : moins d'une comparaison par caractère, ce que la méthode naïve ne peut jamais faire. Sur le second texte, contre , soit un rapport proche de — l'ordre de grandeur de .
Le troisième cas est le contre-exemple, et il faut le retenir. Sur un alphabet à une lettre, tous les sauts valent : le premier échec n'a jamais lieu, chaque alignement est une occurrence, et l'algorithme fait exactement le même travail que le naïf. Ce n'est pas un défaut de la mise en œuvre, c'est la structure de l'entrée : la règle du mauvais caractère ne rapporte que ce que l'alphabet lui donne. Sur elle ne rapporte presque rien ; sur elle rapporte presque .
Une précaution sur ce que l'on compte. On compte ici des comparaisons de caractères. Boyer-Moore paie en plus le précalcul de la table, — soit écritures avec l'alphabet du chapitre. Sur un texte de caractères, ce précalcul domine tout ! Boyer-Moore n'est rentable que si le texte est long, et la mesure ci-dessus, prise seule, le ferait oublier.