informatique (tronc commun des prépas scientifiques) · Chapitre 19 · Exercice de TD
Lire une matrice de confusion
Algorithmique de l'apprentissage : voisins et moyennes · niveau 2
Énoncé
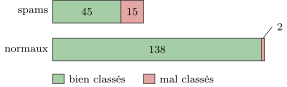
Soit un classifieur de courriers indésirables donnant les résultats suivants sur e-mails de test :
- spams classés correctement comme spams.
- spams classés à tort comme normaux (messages manqués).
- e-mails normaux classés correctement.
- e-mails normaux classés à tort comme spams (faux positifs). (a) Calculer le taux de réussite global. (b) Calculer le taux de spams détectés et la proportion de messages normaux perdus. (c) Interpréter l'asymétrie des coûts d'erreurs et analyser les limites d'un classifieur trivial qui classerait tous les e-mails comme "normaux".
Corrigé
(a) Taux de réussite global : . (b) Proportion de spams détectés : (il reste de spams non filtrés dans la boîte). Proportion d'e-mails légitimes perdus : . (c) L'erreur consistant à classer un e-mail légitime comme spam (perte d'un message professionnel important) est bien plus préjudiciable que l'erreur inverse (conserver un spam en boîte de réception). Le modèle proposé est donc adapté à ce critère d'asymétrie car il minimise les faux positifs. Un classifieur simpliste prédisant systématiquement la classe majoritaire "normal" afficherait un taux de réussite de , score flatteur en apparence mais traduisant un modèle totalement inutile qui ne filtre aucun spam.