Informatique et algorithmique
Cours complet · mathématiques appliquées (ECG 1re année), chapitre 11 · prépa ECG, 1re année
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
En ECG, l'informatique n'est pas une matière séparée : elle fait partie du programme de mathématiques, dont l'intitulé officiel est d'ailleurs « mathématiques appliquées – informatique ». Ce chapitre rassemble ce qui se travaille en travaux pratiques tout au long de l'année, et que les chapitres précédents ont déjà mis en œuvre.
Trois objectifs, énoncés par le programme : consolider la programmation commencée au lycée, mettre en place une discipline — découpage en fonctions, commentaires, évaluation par tests — et pratiquer des algorithmes utiles au traitement de l'information, à la modélisation et à la simulation.
L'étude des algorithmes simples fera apparaître deux questions : l'algorithme s'arrête-t-il (terminaison), et renvoie-t-il ce qu'on attend (correction). Le programme demande de les dégager sans les formaliser, et précise que ces notions ne sont pas exigibles.
11.1 Algorithmique des listes
11.1.1 Parcourir
Python : Recherche séquentielle
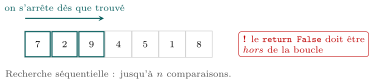
Le schéma de base : on parcourt, on teste, on s'arrête dès qu'on a trouvé.
def appartient(L, x):
    """Renvoie True si x figure dans la liste L."""
    for element in L:
        if element == x:
            return True
    return False        # atteint seulement si la boucle s'est achevee
La ligne return False est hors de la boucle. Placée dedans, elle renverrait False dès le premier élément différent de — erreur classique, et invisible sur une liste dont le premier élément est le bon.
Python : Maximum et second maximum
def maximum(L):
    m = L[0]                     # une liste vide n'a pas de maximum
    for x in L[1:]:
        if x > m:
            m = x
    return m

def deux_plus_grands(L):
    """Renvoie (plus grand, second) en UN seul parcours."""
    if L[0] >= L[1]:
        m1, m2 = L[0], L[1]
    else:
        m1, m2 = L[1], L[0]
    for x in L[2:]:
        if x > m1:
            m1, m2 = x, m1       # l'ancien maximum devient le second
        elif x > m2:
            m2 = x
    return m1, m2
On pourrait chercher le maximum, le retirer, recommencer : deux parcours au lieu d'un, et une liste modifiée. Tenir deux variables coûte une ligne et évite les deux.
Python : Boucles imbriquées : les deux valeurs les plus proches
def plus_proches(L):
    n = len(L)
    meilleure = abs(L[0] - L[1])
    couple = (L[0], L[1])
    for i in range(n):
        # j > i : chaque paire une seule fois
        for j in range(i + 1, n):
            d = abs(L[i] - L[j])
            if d < meilleure:
                meilleure = d
                couple = (L[i], L[j])
    return couple
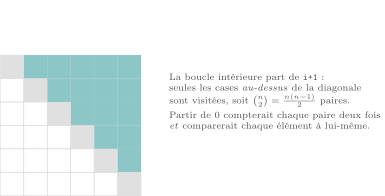
La boucle intérieure part de i + 1 : sans cela on examinerait chaque paire deux fois, et l'on comparerait chaque élément avec lui-même — distance nulle, réponse absurde. Le nombre de comparaisons est .
Un parcours simple fait de l'ordre de opérations, deux boucles imbriquées de l'ordre de . Sur une liste de éléments, cela fait contre : quelques millisecondes contre plusieurs minutes. Le choix de l'algorithme pèse bien davantage que celui du langage.
11.1.2 Dichotomie
Python : Recherche dichotomique dans une liste triée
def recherche_dichotomique(L, x):
    """L est TRIEE par ordre croissant. Renvoie un indice, ou -1."""
    a, b = 0, len(L) - 1
    while a <= b:
        m = (a + b) // 2
        if L[m] == x:
            return m
        elif L[m] < x:
            a = m + 1
        else:
            b = m - 1
    return -1
Chaque tour divise par deux le nombre de candidats : sur une liste d'un million d'éléments, vingt tours suffisent, contre un million pour la recherche séquentielle. L'hypothèse « liste triée » n'est pas un détail — sans elle, l'algorithme renvoie n'importe quoi, sans erreur.
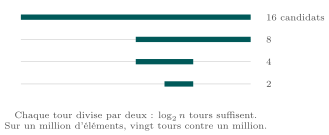
À chaque tour, diminue strictement : la boucle s'arrête. C'est le type d'argument que le programme demande de dégager, sans le formaliser.
11.1.3 Algorithmes gloutons
Un algorithme glouton construit une solution pas à pas, en faisant à chaque étape le choix qui paraît le meilleur sur le moment, sans jamais revenir en arrière.
Python : Rendu de monnaie
def rendu(somme, pieces):
    """pieces est triee par ordre DECROISSANT."""
    rendu = []
    for p in pieces:
        while somme >= p:
            rendu.append(p)
            somme = somme - p
    return rendu

# [50, 10, 5, 2] : 4 pieces, optimal
print(rendu(67, [50, 20, 10, 5, 2, 1]))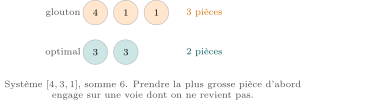
Avec le système de pièces et une somme de , l'algorithme prend d'abord , puis doit compléter par : trois pièces. Or en donne deux. Le glouton est optimal pour le système euro — c'est une propriété de ce système, pas de l'algorithme.
Python : Allocation de salles
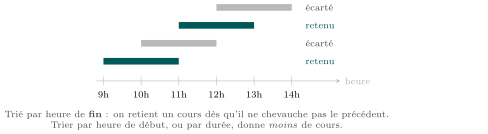
On dispose de cours donnés par leurs horaires ; on veut en placer le plus possible dans une même salle, sans chevauchement.
def allocation(cours):
    """cours : liste de couples (debut, fin)."""
    tries = sorted(cours, key=lambda c: c[1])   # tri par heure de FIN
    retenus = []
    fin_courante = -1
    for debut, fin in tries:
        if debut >= fin_courante:
            retenus.append((debut, fin))
            fin_courante = fin
    return retenus

print(allocation([(9,11), (10,12), (11,13), (12,14)]))
# [(9, 11), (11, 13)]  -> 2 cours
Ici le glouton est optimal, à condition de trier par heure de fin. Trier par heure de début, ou par durée, donne des solutions strictement moins bonnes. Le critère de choix fait tout.
11.2 Statistiques descriptives et analyse de données
Le programme demande de travailler sur des données publiques réelles au format csv — celles de l'Insee ou de data.gouv.fr. Il précise que les commandes de la bibliothèque pandas sont indiquées aux étudiants et qu'aucune n'est exigible. Ce qui compte : savoir lire un tableau, en extraire des indicateurs, et discuter la signification des résultats.
Python : Lire un fichier de données
Un fichier csv est un tableau où chaque ligne est un individu et chaque colonne un descripteur.
import pandas as pd

t = pd.read_csv("salaires.csv")
print(t.shape)              # (nombre de lignes, nombre de colonnes)
print(t.columns)            # les descripteurs
print(t.head())             # les cinq premieres lignes

print(t["salaire"].mean())
print(t["salaire"].median())
print(t["salaire"].describe())        # tous les indicateurs d'un coup

cadres = t[t["categorie"] == "cadre"] # tri selectif
print(cadres["salaire"].median())
Python : Représenter
import matplotlib.pyplot as plt

plt.hist(t["salaire"], bins=30)      # histogramme : variable continue
plt.xlabel("salaire mensuel net")
plt.ylabel("effectif")
plt.show()

effectifs = t["categorie"].value_counts()
# batons : variable qualitative
plt.bar(effectifs.index, effectifs.values)
plt.show()
Le diagramme en bâtons convient aux caractères qualitatifs ou quantitatifs discrets ; l'histogramme, dont les barres sont accolées, aux caractères continus regroupés en classes. Employer l'un pour l'autre suggère une continuité qui n'existe pas, ou l'inverse.
Calculer une moyenne prend une ligne. Décider si elle décrit correctement les données en prend davantage : sur des salaires, la médiane et l'écart interquartile disent presque toujours mieux la réalité que la moyenne et l'écart-type. C'est le point sur lequel le programme insiste.
11.3 Approximation numérique
Python : Trois façons de résoudre
def f(x):
    return x ** 3 + x - 1

# 1. Dichotomie : demande la continuite et un changement de signe
def dichotomie(f, a, b, eps):
    while b - a > eps:
        m = (a + b) / 2
        if f(a) * f(m) <= 0:
            b = m
        else:
            a = m
    return (a + b) / 2

# 2. Suite recurrente : x = g(x) avec |g'| < 1 pres du point fixe
def point_fixe(g, x0, n):
    x = x0
    for _ in range(n):
        x = g(x)
    return x

# 3. Encadrement par balayage, pour localiser AVANT d'affiner
def balayage(f, a, b, pas):
    x = a
    while x < b:
        if f(x) * f(x + pas) <= 0:
            return (x, x + pas)
        x = x + pas
    return None

print(balayage(f, 0, 2, 0.1))        # (0.6, 0.7)
print(dichotomie(f, 0.6, 0.7, 1e-12))
Les trois méthodes viennent d'une étude mathématique : le théorème des valeurs intermédiaires pour la dichotomie, l'inégalité des accroissements finis pour la suite récurrente. Aucune ne fonctionne sans hypothèse — et c'est le cours qui les fournit.
11.4 Graphes et plus courts chemins
Un graphe s'implémente soit par sa matrice d'adjacence — un tableau —, soit par des listes d'adjacence : pour chaque sommet, la liste de ses voisins, rassemblées dans une liste ou un dictionnaire.
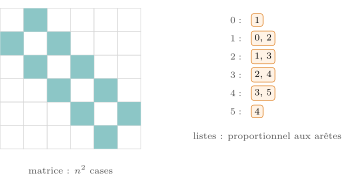
La matrice répond en une opération à « et sont-ils voisins ? », mais occupe cases même si le graphe a peu d'arêtes. Les listes d'adjacence occupent une place proportionnelle au nombre d'arêtes et se parcourent plus vite — c'est la représentation des grands graphes réels, qui sont presque toujours creux.
Python : Les deux représentations
# matrice d'adjacence
A = [[0, 1, 0, 0],
     [1, 0, 1, 1],
     [0, 1, 0, 1],
     [0, 1, 1, 0]]

# listes d'adjacence (dictionnaire)
G = {0: [1], 1: [0, 2, 3], 2: [1, 3], 3: [1, 2]}

def voisins(G, s):
    return G[s]
11.4.1 Algorithme de Dijkstra
On cherche le plus court chemin d'un sommet source vers tous les autres, dans un graphe dont les arêtes portent des poids positifs. Cette hypothèse est essentielle : c'est elle qui rend correct le principe de l'algorithme.
On maintient une distance provisoire pour chaque sommet, initialisée à sauf pour la source. À chaque étape, on fixe définitivement le sommet non traité de plus petite distance provisoire, puis on met à jour ses voisins : si passer par lui raccourcit le trajet, on le retient.
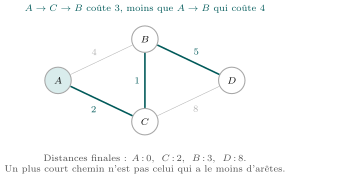
Quand on fixe le sommet de plus petite distance provisoire, on affirme qu'aucun détour ne pourra faire mieux. C'est vrai si tout détour ajoute une longueur — donc si les poids sont positifs. Avec un poids négatif, un chemin plus long en nombre d'arêtes pourrait être plus court en distance, et l'algorithme conclurait trop tôt.
Python : Dijkstra
def dijkstra(G, source):
    """G : sommet -> liste de couples (voisin, poids >= 0)."""
    dist = {s: float("inf") for s in G}
    dist[source] = 0
    a_traiter = set(G)

    while a_traiter:
        # le sommet non traite de plus petite distance provisoire
        u = min(a_traiter, key=lambda s: dist[s])
        if dist[u] == float("inf"):
            break           # les sommets restants sont inatteignables
        a_traiter.remove(u)
        for v, poids in G[u]:
            if dist[u] + poids < dist[v]:
                dist[v] = dist[u] + poids    # passer par u raccourcit
    return dist

G = {"A": [("B", 4), ("C", 2)],
     "B": [("A", 4), ("C", 1), ("D", 5)],
     "C": [("A", 2), ("B", 1), ("D", 8)],
     "D": [("B", 5), ("C", 8)]}

print(dijkstra(G, "A"))
# {'A': 0, 'B': 3, 'C': 2, 'D': 8}
Notez le résultat pour B : , et non . Le chemin direct coûte , mais le détour coûte . C'est exactement ce que la mise à jour des voisins permet de découvrir — un plus court chemin n'est pas forcément celui qui a le moins d'arêtes.
11.5 Simulation de phénomènes aléatoires
Python : Simuler les lois usuelles
import numpy as np
rng = np.random.default_rng(0)

def bernoulli(p):
    return 1 if rng.random() < p else 0

def binomiale(n, p):
    """Nombre de succes en n epreuves : une SOMME de Bernoulli."""
    return sum(bernoulli(p) for _ in range(n))

def geometrique(p):
    """Rang du premier succes : on compte jusqu'a reussir."""
    k = 1
    while bernoulli(p) == 0:
        k = k + 1
    return k

X = [binomiale(10, 0.3) for _ in range(100_000)]
print(np.mean(X), 10 * 0.3)              #  3.0
Y = [geometrique(0.2) for _ in range(100_000)]
print(np.mean(Y), 1 / 0.2)               #  5.0
Chaque simulation traduit la définition de la loi : la binomiale compte des succès, la géométrique attend le premier. Écrire la simulation, c'est vérifier qu'on a compris de quoi la loi parle.
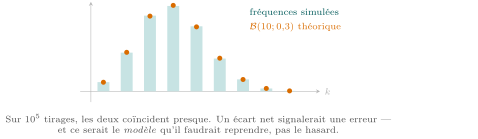
Une simulation ne démontre rien : elle donne une fréquence, pas une probabilité. Mais un écart net entre simulation et calcul signale une erreur — et c'est presque toujours le modèle qui est en cause, pas le hasard. C'est un outil de contrôle, à utiliser comme tel.
11.6 L'essentiel du chapitre
- Discipline : découper en fonctions, commenter, tester. Terminaison et correction se dégagent, ne se formalisent pas — et ne sont pas exigibles.
- Parcours : opérations ; boucles imbriquées : . Sur éléments, quelques millisecondes contre plusieurs minutes.
- Dichotomie : liste triée obligatoire ; environ tours.
- Glouton : choix localement optimal, jamais de retour en arrière. Optimal pour l'allocation de salles (tri par heure de fin) ; pas toujours pour le rendu de monnaie.
- Données :
csv, descripteurs,pandasetmatplotlib— aucune commande exigible. Bâtons pour le qualitatif, histogramme pour le continu. - Racine de : balayer pour localiser, puis dichotomie ou suite récurrente. Les hypothèses viennent du cours.
- Graphes : matrice ( cases) ou listes d'adjacence (proportionnel aux arêtes).
- Dijkstra : poids positifs ; fixer le sommet de plus petite distance provisoire, mettre à jour ses voisins.
- Simuler, c'est traduire la définition de la loi. Une simulation contrôle, elle ne démontre pas.