Informatique et travaux pratiques
Cours complet · mathématiques (ECT 2e année), chapitre 12 · prépa ECT, 2e année
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
L'informatique n'est pas une matière à part : elle fait partie du programme de mathématiques, dont l'intitulé officiel est « mathématiques appliquées – informatique ». Ce chapitre rassemble les quatre thèmes de travaux pratiques de seconde année : les statistiques descriptives bivariées, la simulation de lois et le calcul d'espérances, les bases de données, et le théorème limite central — chacun sur des données tirées de situations réelles.
Le programme le dit sans détour : « L'objectif de ces travaux pratiques n'est pas l'écriture de longs programmes mais l'assimilation de savoir-faire et de compétences spécifiés dans la liste des exigibles. »
Il précise aussi, à propos des notions nouvelles que certains thèmes exigent : « elles ne pourront en aucun cas être exigibles des étudiants. » Le théorème limite central, la covariance empirique, la droite de régression : tout cela s'utilise ici, rien de cela ne se récite.
C1 : produire et interpréter des résumés numériques et graphiques d'une série statistique (simple, double) ou d'une loi. C2 : modéliser et simuler des phénomènes, et les traduire en langage mathématique. C3 : porter un regard critique sur les méthodes d'estimation et de simulation. C4 : stocker, organiser et extraire des données structurées.
Ce sont eux qui sont évalués, pas la virtuosité en Python.
12.1 Le socle Python
Le programme de seconde année ne rallonge pas la liste : « Les commandes exigibles ont été listées dans le programme de première année. »
- Types :
=,#,+ - * / **,== > < >= <= !=,True False and or not. - Structures :
if / elif / else,for,while,defetreturn. - numpy :
np.exp,np.log,np.sqrt,np.abs,np.array,np.zeros,np.ones,np.arange,np.linspace,np.dot,np.sum,np.mean,np.var,np.std,np.min,np.max,np.median,np.cumsum. - matplotlib.pyplot :
plt.plot,plt.show,plt.hist,plt.bar,plt.boxplot,plt.scatter; etnumpy.random, détaillée plus loin.
Les autres fonctions « pourront être utilisées en classe, mais ceci ne pourra se faire qu'avec parcimonie », et toujours avec leur mode d'emploi.
12.2 Statistiques descriptives bivariées
Jusqu'ici les séries étaient à une variable. On en observe maintenant deux sur les mêmes individus : le budget publicitaire et le chiffre d'affaires d'un même mois.
Une série statistique double est la donnée de couples ; le nuage de points est l'ensemble de ces couples placés dans un repère, et son point moyen est .
On appelle covariance empirique de la série double le nombre
et coefficient de corrélation empirique le nombre , où et sont les écarts-types empiriques des deux séries.
On montre que . Le signe donne le sens de la liaison, la valeur absolue sa force : proche de , les points sont presque alignés sur une droite croissante ; proche de , sur une droite décroissante ; proche de , il n'y a aucune liaison affine — ce qui ne veut pas dire aucune liaison du tout.
La droite de régression de en est la droite qui rend minimale la somme des carrés des écarts verticaux . Ses coefficients sont
La seconde formule s'écrit : le point moyen vérifie l'équation de la droite. Contrôle gratuit — si votre droite ne passe pas par , elle est fausse.
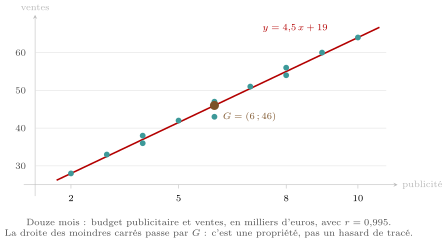
Python : Nuage, corrélation et régression en cinq lignes
import numpy as np
import matplotlib.pyplot as plt

pub = np.array([2, 3, 4, 4, 5, 6, 6, 7, 8, 8, 9, 10])
ven = np.array([28, 33, 36, 38, 42, 43, 47, 51, 54, 56, 60, 64])

print(np.mean(pub), np.mean(ven))
print(round(np.corrcoef(pub, ven)[0, 1], 4))
a, b = np.polyfit(pub, ven, 1)
print(round(a, 4), round(b, 4))

plt.scatter(pub, ven)
plt.plot(pub, a * pub + b)
# 6.0 46.0
# 0.9946
# 4.5 19.0
Les trois commandes du programme sont là : plt.scatter pour le nuage, np.corrcoef pour la corrélation, np.polyfit pour l'ajustement affine — son dernier argument est le degré, et demande une droite.
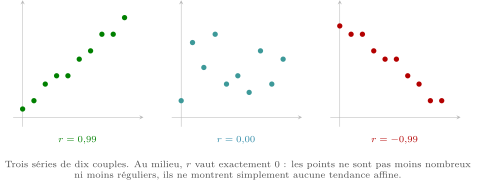
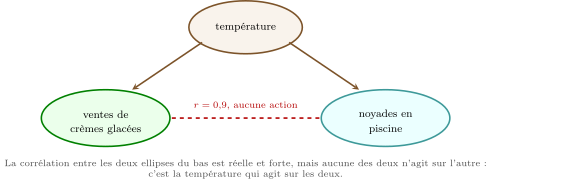
Le programme y insiste : il faut « souligner la distinction entre corrélation et causalité ». Un proche de dit que deux séries varient ensemble ; il ne dit jamais que l'une cause l'autre.
Trois lectures restent possibles : agit sur ; agit sur ; ou une troisième grandeur agit sur les deux. Le calcul ne les distingue pas.
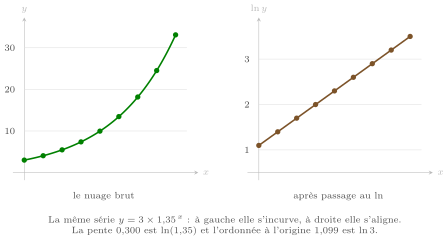
Le programme suggère de « pouvoir effectuer des pré-transformations pour se ramener au cas linéaire ». Si un nuage s'incurve comme une exponentielle, on trace le nuage : une croissance devient , donc une droite.
12.3 Simulation de lois et calcul d'espérances
Simuler une variable aléatoire , c'est produire par la machine un grand nombre de valeurs qui se répartissent comme la loi de , puis comparer l'échantillon obtenu à la loi théorique.
Dans numpy.random, importé par import numpy.random as rd : rd.random() rend un réel de et rd.randint(a, b) un entier de ; rd.binomial(n, p), rd.geometric(p) et rd.poisson(m) donnent les lois discrètes, rd.exponential(1/lam) et rd.normal(m, s) les lois à densité.
Chacune accepte un dernier argument facultatif : la taille de l'échantillon.
rd.randint(1, 7) rend un entier entre et : la borne haute est exclue. Et rd.exponential attend la moyenne , pas : pour , on écrit rd.exponential(1/0.4). Ce sont les deux erreurs les plus fréquentes du thème.
Python : Un tirage de chaque loi
import numpy.random as rd

rd.seed(5)
print(round(rd.random(), 4))
print(round(3 + 4 * rd.random(), 4))
print(rd.binomial(10, 0.3))
print(rd.geometric(0.35))
print(rd.poisson(2.5))
print(round(rd.exponential(1 / 0.4), 4))
print(round(rd.normal(170, 8), 4))
# 0.222
# 6.4829
# 2
# 6
# 4
# 0.5198
# 171.5008
La deuxième ligne simule la loi uniforme sur : si est uniforme sur , alors est uniforme sur . La ligne rd.seed(5) rend le résultat reproductible.
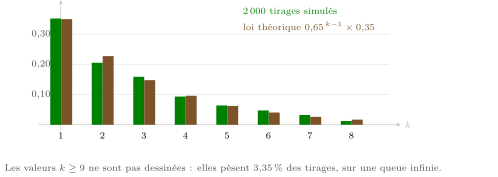
Le programme demande la « comparaison entre différentes méthodes : utilisation d'une loi de Bernoulli et d'une boucle while, utilisation du générateur rd.random ». La première méthode suit la définition (on répète une épreuve jusqu'au premier succès, en comptant les essais), la seconde appelle le générateur tout fait.
Python : La géométrique, à la main puis par le générateur
import numpy as np
import numpy.random as rd

def geo(p):
    k = 1
    while rd.random() >= p:
        k = k + 1
    return k

rd.seed(8)
a = np.array([geo(0.35) for _ in range(10000)])
b = rd.geometric(0.35, 10000)
print(np.mean(a), np.mean(b), round(1 / 0.35, 4))
# 2.8506 2.8536 2.8571
Les deux moyennes encadrent la valeur théorique à moins de près. La boucle est plus lente, mais elle explique la loi.
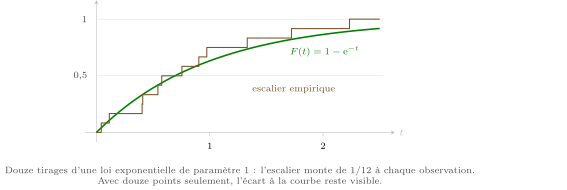
Le programme propose aussi de « tracer la fonction de répartition empirique et la comparer à la fonction de répartition théorique » : elle associe à la proportion d'observations inférieures ou égales à , et monte donc de à chaque observation.
Lorsqu'une espérance est difficile à calculer, la loi faible des grands nombres autorise à l'approcher : on simule un grand nombre de réalisations et l'on en prend la moyenne. C'est le chapitre 10 retourné en méthode de calcul.
Le résultat n'est jamais exact, et il change à chaque exécution si l'on ne fixe pas la graine — d'où la compétence C3, porter un regard critique.
Python : L'espérance du plus grand de deux dés
import numpy as np
import numpy.random as rd

rd.seed(10)
n = 100000
d1 = rd.randint(1, 7, n)
d2 = rd.randint(1, 7, n)
print(np.mean(np.maximum(d1, d2)), round(161 / 36, 4))
# 4.48046 4.4722
La valeur exacte est ; cent mille parties donnent . On aurait tort d'annoncer plus de décimales que la simulation n'en garantit.
12.4 Bases de données
Une base de données relationnelle range l'information dans des tables : chaque ligne est un enregistrement, chaque colonne un champ, et le langage SQL sert à les créer et à les interroger.
Une table (ou relation) porte des champs (ou attributs), dont chacun a un domaine : INTEGER pour les entiers, TEXT pour les chaînes. La clé primaire (PRIMARY KEY) est le champ qui identifie une ligne sans ambiguïté ; une clé étrangère (FOREIGN KEY) est un champ d'une table qui reprend la clé primaire d'une autre — c'est le lien entre les deux.
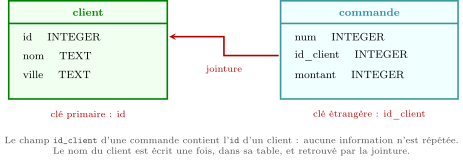
Le programme n'en ajoute que deux à celles de première année : CREATE TABLE nom_de_table pour créer une table, et SELECT * FROM table1 INNER JOIN table2 pour une jointure, avec la condition ON lorsque celle-ci est une conjonction d'égalités.
Et il ferme la porte : « Aucune autre notion de jointure n'est dans ce programme. » Ni jointure externe, ni jointure naturelle.
CREATE TABLE client (
    id INTEGER PRIMARY KEY,
    nom TEXT,
    ville TEXT
);
INSERT INTO client VALUES (1, 'Durand', 'Lyon');

SELECT * FROM commande
INNER JOIN client ON commande.id_client = client.id;

SELECT client.nom, commande.montant FROM commande
INNER JOIN client ON commande.id_client = client.id
WHERE commande.montant > 500;
CREATE TABLE et INNER JOIN sont les nouveautés de l'année ; INSERT INTO, VALUES, SELECT et WHERE étaient au programme de première année. La deuxième requête rapproche chaque commande de son client, la troisième filtre le résultat.
Le programme de seconde année renvoie à celui de première : « Les commandes non exigibles ont été listées dans le programme de première année. » Y figurent UNION, INTERSECTION, EXCEPT, les fonctions d'agrégation MIN, MAX, SUM, AVG, COUNT, ainsi que DISTINCT et ORDER BY. On peut s'en servir « par commodité », mais leur syntaxe doit toujours être rappelée dans l'énoncé.
12.5 Théorème limite central
Le programme est net : l'objectif est « de dégager des conséquences importantes du théorème limite central qui n'est pas au programme », et l'on pourra « énoncer sans formaliser la notion de convergence ». Il s'agit donc d'une observation faite sur machine dont on tire une méthode de calcul, jamais d'un résultat à restituer.
Soient indépendantes et de même loi, d'espérance et d'écart-type , et . On sait déjà que et ; ce que la simulation ajoute, c'est la forme : dès que dépasse quelques unités, l'histogramme des moyennes prend l'allure d'une cloche, quelle que soit la loi de départ.
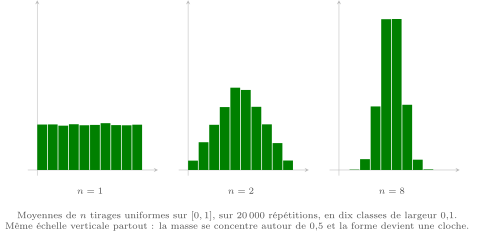
Python : La dispersion des moyennes décroît en
import numpy as np
import numpy.random as rd

rd.seed(3)
for n in [1, 2, 8, 32]:
    m = np.mean(rd.random((20000, n)), 1)
    print(n, round(np.mean(m), 4), round(np.std(m), 4),
          round((1 / 12 / n)**0.5, 4))
# 1 0.4983 0.2888 0.2887
# 2 0.502 0.2043 0.2041
# 8 0.4998 0.1025 0.1021
# 32 0.5005 0.0508 0.051
La loi uniforme sur a pour variance . Les écarts-types mesurés (troisième colonne) collent à la prévision (quatrième), et les moyennes restent voisines de .
De cette forme en cloche on tire l'intervalle de confiance asymptotique d'une proportion : pour un sondage de taille et une fréquence observée , il s'écrit au seuil de . Le coefficient vient de la loi normale ; la variance est encore majorée par , d'où le au dénominateur.
Python : Les deux intervalles, mis à l'épreuve
import numpy as np
import numpy.random as rd

rd.seed(7)
n, p = 1000, 0.42
f = rd.binomial(n, p, 20000) / n
tch = (1 / (4 * n * 0.05))**0.5
asy = 1.96 * (0.25 / n)**0.5
print(round(tch, 4), round(np.mean(np.abs(f - p) <= tch), 4))
print(round(asy, 4), round(np.mean(np.abs(f - p) <= asy), 4))
# 0.0707 1.0
# 0.031 0.9488
L'intervalle de Bienaymé-Tchebychev couvre des cas pour une garantie de : correct, mais deux fois trop large. L'asymptotique, deux fois plus étroit, couvre des cas — tout près de la cible.
Le mot n'est pas décoratif. Le second intervalle n'a aucune garantie exacte : sa couverture s'approche de quand grandit, et peut être mauvaise pour petit ou pour très proche de ou de . C'est le prix de sa finesse, et l'objet même de la compétence C3 : dire ce que chaque méthode garantit, et ce qu'elle ne garantit pas.