Estimation
Cours complet · mathématiques (ECT 2e année), chapitre 11 · prépa ECT, 2e année
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Tous les chapitres de probabilités ont procédé dans le même sens : on se donnait une loi, et l'on en déduisait des probabilités. Ce chapitre marche à l'envers. La loi est là, mais l'un de ses paramètres est inconnu — la proportion d'électeurs favorables à une mesure, le taux de pièces défectueuses d'une chaîne, le nombre moyen de réclamations d'un service. On ne dispose que d'observations, et l'on veut remonter d'elles au paramètre.
C'est le travail de l'estimation. Il en existe deux formes : donner un seul nombre, aussi proche que possible du paramètre — c'est l'estimation ponctuelle ; ou donner un intervalle assorti d'une garantie — c'est l'intervalle de confiance. Les deux reposent entièrement sur les deux résultats du chapitre précédent.
Le programme est explicite sur le niveau attendu. Sur les intervalles de confiance : « Ce paragraphe a uniquement pour but de préciser le vocabulaire employé. […] aucune connaissance autre que ce vocabulaire n'est exigible sur les intervalles de confiance. »
Il ajoute, à propos du résultat central du chapitre : « Résultat non exigible », et « La démonstration n'est pas un attendu du programme. »
On apprend donc ici un vocabulaire et une pratique : savoir calculer une estimation, savoir écrire un intervalle, savoir dire ce qu'il garantit. Pas une théorie.
11.1 La problématique de l'estimation
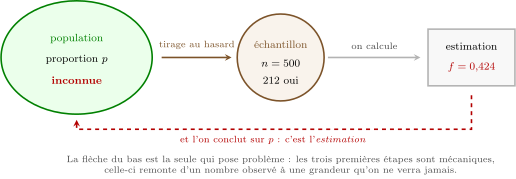
Prenons l'exemple qui sert de fil conducteur au chapitre. Une commune veut connaître la proportion de ses habitants favorables à la piétonnisation du centre-ville. Interroger tout le monde coûterait trop cher : on interroge personnes tirées au hasard, et répondent oui.
On modélise le phénomène par une variable aléatoire dont la loi dépend d'un paramètre inconnu . Observer fois le phénomène revient à se donner variables aléatoires
- indépendantes (chaque observation n'influence pas les autres),
- de même loi que .
Ces variables forment un échantillon de taille . Les nombres effectivement observés sont une réalisation de cet échantillon.
sont des variables aléatoires : elles décrivent ce qu'on pourrait observer, avant l'enquête. Les sont des nombres : ce qu'on a effectivement observé, après.
Toute la difficulté du chapitre tient dans cet aller-retour. Les garanties se calculent au niveau des variables aléatoires ; les nombres, eux, sont ce qu'ils sont.
Le programme précise : « On pourra éventuellement introduire la notion d'estimateur, mais ce n'est pas un attendu du programme. »
On parlera donc simplement de la variable aléatoire et de sa réalisation, sans construire de théorie des estimateurs — ni biais, ni risque quadratique, ni convergence d'estimateurs.
11.2 Estimation ponctuelle
Soit un échantillon de même loi que , dont l'espérance est le paramètre cherché. On pose
La réalisation de observée sur l'échantillon , c'est-à-dire le nombre , est l'estimation ponctuelle du paramètre obtenue sur cet échantillon.
La justification est la loi faible des grands nombres, démontrée au chapitre précédent : et .
Autrement dit, vise juste en moyenne, et se rapproche de la cible quand grandit. Ce sont les deux qualités qu'on attend d'une estimation, et ce chapitre n'en demande pas d'autres.
On modélise la -ème réponse par valant si la personne est favorable, sinon : suit la loi de Bernoulli de paramètre , donc . Le paramètre inconnu est l'espérance.
La moyenne empirique est alors la fréquence observée : . L'estimation ponctuelle de est , soit .
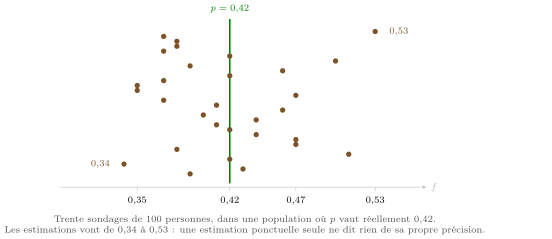
Sur la figure, aucune des trente valeurs ne vaut exactement , et la plus mauvaise se trompe de onze points. C'est inévitable : est une variable aléatoire, elle fluctue.
Un nombre livré seul est donc trompeur. C'est la raison d'être de la seconde moitié du chapitre : accompagner le nombre d'un intervalle et d'une garantie.
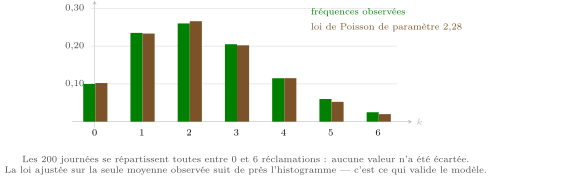
Un service après-vente enregistre le nombre de réclamations reçues chaque jour. On modélise ce nombre par une loi de Poisson de paramètre inconnu. Comme pour une loi de Poisson, le paramètre est encore l'espérance : on l'estime par la moyenne des observations.
Sur journées totalisant réclamations, l'estimation ponctuelle est
Python : Estimer, et voir l'effet de la taille de l'échantillon
import numpy as np
import numpy.random as rd

rd.seed(2)
p = 0.42
for n in [50, 500, 5000]:
    ech = rd.binomial(1, p, n)
    print(n, np.mean(ech))
# 50 0.28
# 500 0.4
# 5000 0.407
Avec personnes on annonce pour une valeur réelle de : l'erreur est de quatorze points. Avec personnes elle tombe à un point et demi. La qualité d'une estimation n'est pas dans la méthode, elle est dans .
11.3 Moyenne et écart-type empiriques
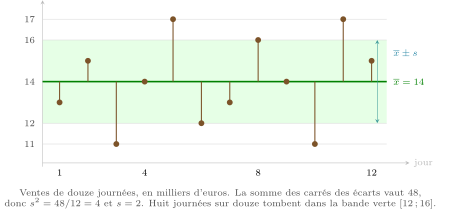
Soit une réalisation d'un échantillon. On appelle
- moyenne empirique le nombre ;
- variance empirique le nombre ;
- écart-type empirique le nombre .
Le programme le dit à propos des intervalles de confiance : « On remarque que dans la pratique, l'écart-type n'est pas connu, ce qui conduit à utiliser l'écart-type de l'échantillon (écart-type empirique). »
Autrement dit, manque presque toujours, et l'on met à sa place. Ce remplacement n'est pas justifié dans ce programme ; il est simplement signalé comme la pratique courante.
11.4 Intervalle de confiance
Estimer par intervalle de confiance, c'est ne plus donner un seul nombre, mais un intervalle aléatoire — ses deux bornes se calculent à partir de l'échantillon, donc elles sont elles-mêmes aléatoires — qui contienne le paramètre cherché avec une probabilité au moins égale à un nombre fixé d'avance.
Ce nombre, noté , s'appelle le seuil de confiance (ou niveau de confiance) ; est le risque.
Soit un échantillon indépendant de même loi que , d'espérance et de variance . Pour tout , la probabilité que l'intervalle
contienne est supérieure à .
Démonstration
Posons . La moyenne empirique a pour espérance et pour variance ; Bienaymé-Tchebychev lui donne donc
En passant à l'événement contraire, , ce qui est exactement l'énoncé.
Le programme accompagne cet énoncé de deux mentions : « Résultat non exigible » et « La démonstration n'est pas un attendu du programme. » Il ajoute : « On se limitera au cas d'une variable de Bernoulli. »
Ce qui reste au programme, c'est de savoir écrire un tel intervalle sur un exemple de sondage, et de savoir dire ce qu'il garantit.
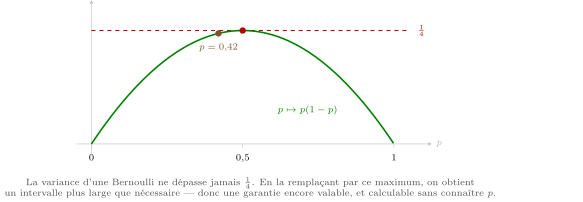
Pour une variable de Bernoulli de paramètre , — qui dépend du paramètre inconnu ! On ne peut donc pas calculer la demi-largeur. Le programme donne l'issue : « En pratique, la variance est inconnue, mais on peut la majorer par . »
En effet, pour tout , avec égalité en . On remplace donc par , ce qui agrandit l'intervalle — et une garantie reste vraie sur un intervalle plus grand :
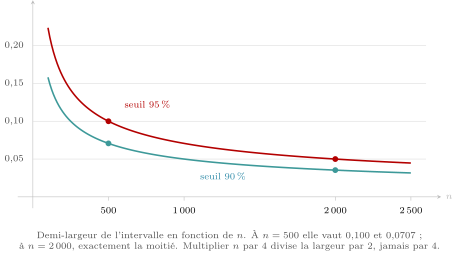
Avec et , la demi-largeur vaut :
- au seuil de confiance de () : , soit ;
- au seuil de confiance de () : , soit .
Exiger plus de confiance élargit l'intervalle : c'est le prix de la garantie.
Python : Écrire l'intervalle, et mesurer ce qu'il couvre vraiment
def ic(f, n, a):
    h = (1 / (4 * n * a))**0.5
    return round(f - h, 4), round(f + h, 4)

print(ic(0.42, 500, 0.05))
print(ic(0.42, 500, 0.10))
print(ic(0.42, 2000, 0.05))
# (0.32, 0.52)
# (0.3493, 0.4907)
# (0.37, 0.47)
La troisième ligne montre l'effet de la taille : passer de à personnes, c'est multiplier par , donc diviser la largeur par .
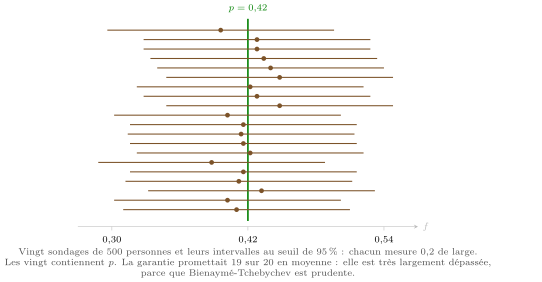
Une fois le sondage réalisé, l'intervalle est un intervalle de nombres : soit il contient , soit il ne le contient pas. Il n'y a plus de hasard, et il est faux d'écrire « ».
La bonne formulation porte sur la méthode : si l'on répétait le sondage, au moins des intervalles ainsi construits contiendraient . C'est la figure précédente, lue ligne par ligne.
11.5 Choisir la taille de l'échantillon
La demi-largeur ne dépend que de deux choses : le risque consenti et la taille . On peut donc, avant de lancer l'enquête, décider de sa taille.
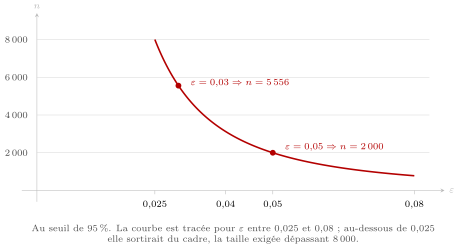
Pour que l'intervalle de confiance au seuil ait une demi-largeur au plus égale à , il suffit de prendre
Démonstration
La demi-largeur vaut . L'inégalité équivaut à , puis à , d'où le résultat en divisant par .
Python : La garantie est-elle atteinte, ou largement dépassée ?
import numpy as np
import numpy.random as rd

rd.seed(4)
n, p, a = 500, 0.42, 0.05
h = np.sqrt(1 / (4 * n * a))
f = rd.binomial(n, p, 100000) / n
print(h, np.mean(np.abs(f - p) <= h))
# 0.1 0.99999
Sur cent mille sondages simulés, l'intervalle contient dans des cas, pour une garantie annoncée de . L'intervalle de Bienaymé-Tchebychev n'est donc pas faux : il est trop large.
Cette prudence a un coût : pour deux points de précision au seuil de , la proposition exige personnes, alors que les instituts de sondage en interrogent mille. Ils n'utilisent pas Bienaymé-Tchebychev, mais l'intervalle de confiance asymptotique, qui s'appuie sur le théorème limite central.
Ce théorème n'est pas au programme ; il est abordé en travaux pratiques, au chapitre 12, où les deux intervalles sont comparés sur une même simulation.