Convergences et approximations
Cours complet · mathématiques (ECT 2e année), chapitre 10 · prépa ECT, 2e année
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Jusqu'ici, une variable aléatoire se décrivait par sa loi. Ce chapitre change de point de vue : il demande ce qu'on peut dire d'une variable aléatoire quand on ne connaît d'elle que son espérance, ou son espérance et sa variance — autrement dit, ce que ces deux nombres, à eux seuls, garantissent.
La réponse tient en deux inégalités, celle de Markov et celle de Bienaymé-Tchebychev. Elles sont grossières, et c'est leur intérêt : elles valent pour toutes les lois. C'est ce caractère universel qui permet ensuite de démontrer le résultat central de l'année — la loi faible des grands nombres — puis, au chapitre suivant, de fabriquer un intervalle de confiance sans rien savoir de la loi observée.
Le programme accompagne l'inégalité de Markov et l'inégalité de Bienaymé-Tchebychev de la même mention : « Résultat non exigible. »
Cela ne veut pas dire qu'on peut les ignorer : elles servent partout dans le chapitre et dans le suivant, et il faut savoir les appliquer. Cela veut dire qu'on ne vous demandera pas de les restituer ni de les redémontrer pour elles-mêmes. Les démonstrations données ici sont là pour l'intelligence du résultat, pas comme un attendu.
10.1 L'inégalité de Markov
Soit une variable aléatoire à valeurs positives dont on connaît l'espérance , et rien d'autre. Que peut-on dire de la probabilité que dépasse un seuil ?
L'intuition est simple. Si le nombre moyen de retours quotidiens d'une boutique est , il ne peut pas y avoir « souvent » des journées à retours : chaque grosse journée pèse lourd dans la moyenne, donc elle doit être rare. Mettre un chiffre sur ce « donc elle doit être rare », c'est exactement l'inégalité de Markov.
Soit une variable aléatoire à valeurs positives admettant une espérance. Alors
Démonstration
Traitons le cas d'une variable discrète finie prenant les valeurs , toutes positives. Par définition, . Tous les termes sont positifs : on ne diminue pas la somme en ne gardant que ceux pour lesquels . Or sur ces termes-là, , donc
On divise par .
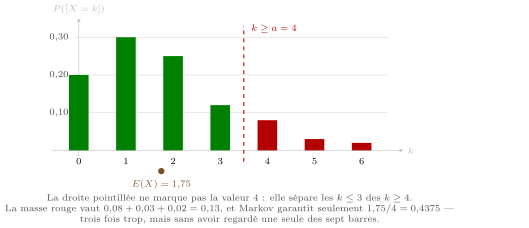
Le temps d'attente d'un appel, en minutes, est positif et d'espérance minutes. Sans rien savoir de plus, . Au plus des appelants attendent un quart d'heure ou plus. C'est une garantie contractuelle utilisable telle quelle, même si le fournisseur refuse de communiquer la loi de .
L'inégalité est fausse sans l'hypothèse . Prenons qui vaut ou avec probabilité chacune : alors , et l'inégalité de Markov prédirait , alors que cette probabilité vaut .
La démonstration montre où l'hypothèse sert : c'est la ligne « tous les termes sont positifs, on ne diminue pas la somme en en supprimant ».
Le programme le suggère : rien n'oblige à appliquer Markov à elle-même. Si , la variable est positive, et Markov lui donne . C'est en prenant sur la variable qu'on obtient la seconde inégalité du chapitre.
10.2 L'inégalité de Bienaymé-Tchebychev
Markov ne parle que de grandes valeurs. La question vraiment utile est autre : a-t-elle des chances de tomber loin de sa moyenne, dans un sens ou dans l'autre ? Il faut pour cela une seconde information, et ce sera la variance.
Soit une variable aléatoire admettant un moment d'ordre , d'espérance et de variance . Alors
Démonstration
Posons . C'est une variable positive, et son espérance est précisément . Les deux événements et sont le même événement, puisque équivaut à pour . L'inégalité de Markov appliquée à avec le seuil donne alors
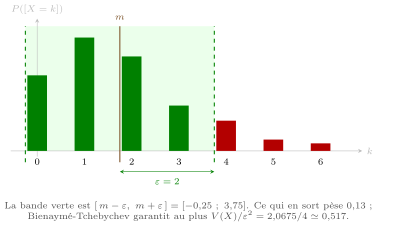
Elle transforme une information sur la dispersion en une information sur la probabilité. Écrite avec , où est l'écart-type, elle devient
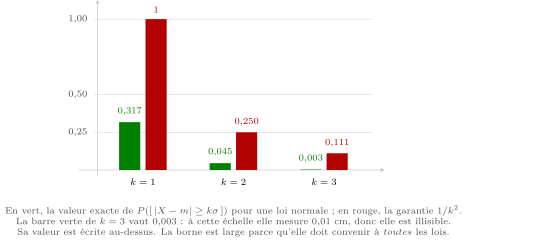
et cette forme se retient : au plus de la masse est à plus de écarts-types de la moyenne, quelle que soit la loi. Pour : au plus . Pour : au plus .
Python : Vérifier les deux inégalités sur la loi des retours
import numpy as np

val = np.array([0, 1, 2, 3, 4, 5, 6])
pro = np.array([0.20, 0.30, 0.25, 0.12, 0.08, 0.03, 0.02])
m = np.sum(val * pro)
V = np.sum(val**2 * pro) - m**2

print(m, V)
print(np.sum(pro[val >= 4]), m / 4)
print(np.sum(pro[np.abs(val - m) >= 2]), V / 4)
# 1.75 2.0675
# 0.13 0.4375
# 0.13 0.516875
Les deux bornes sont vraies, et toutes deux très au-dessus de la vraie valeur . Une inégalité n'est pas une approximation : elle ne promet pas d'être proche, seulement de ne jamais être fausse.
10.3 Suites de variables aléatoires
Pour parler de moyennes, il faut d'abord savoir manipuler une famille de variables aléatoires, et surtout dire ce que signifie qu'elles ne s'influencent pas.
Les variables aléatoires sont mutuellement indépendantes si, pour tout choix d'intervalles réels , les événements sont mutuellement indépendants.
Les variables d'une suite sont dites mutuellement indépendantes si, pour tout entier , les variables le sont.
« Mutuellement indépendantes » est plus fort que « indépendantes deux à deux » : il ne suffit pas que chaque paire soit indépendante, il faut que la propriété de produit vaille pour tous les sous-groupes à la fois. Dans la pratique de ce programme, l'indépendance mutuelle sera toujours donnée par l'énoncé, au titre de la modélisation : des clients distincts, des jours distincts, des pièces tirées avec remise.
Soient des variables aléatoires admettant une espérance et une variance, et .
- Toujours : .
- Si de plus sont mutuellement indépendantes : .
L'espérance est toujours additive : aucune hypothèse. La variance ne l'est que sous indépendance — le chapitre sur les couples a montré pourquoi : , et le terme de covariance ne disparaît que si les variables sont indépendantes.
Retenir la formule sans son hypothèse est la faute la plus coûteuse de ce chapitre : c'est elle qui fait tout fonctionner ensuite.
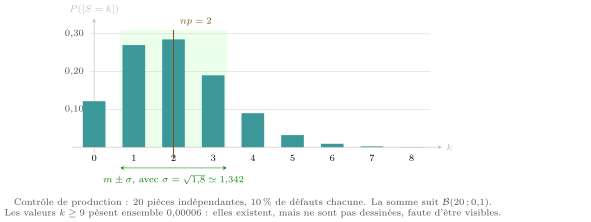
Soient mutuellement indépendantes, chacune de loi de Bernoulli de paramètre . Alors compte les succès, donc suit la loi binomiale . Les deux formules donnent immédiatement et . On retrouve, sans le moindre calcul de somme, l'espérance et la variance de la loi binomiale.
10.4 La moyenne empirique
Soit une suite de variables aléatoires. Pour , on appelle moyenne empirique d'ordre la variable aléatoire
Si les sont mutuellement indépendantes, de même espérance et de même variance , alors
Démonstration
Par linéarité, . Pour la variance, on utilise avec , puis l'additivité sous indépendance :
L'écart-type s'obtient en prenant la racine.
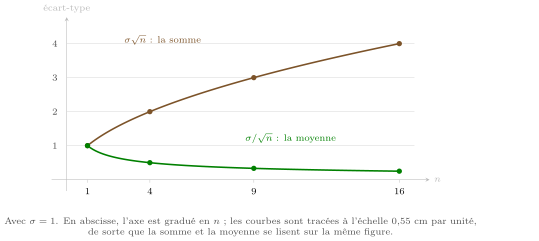
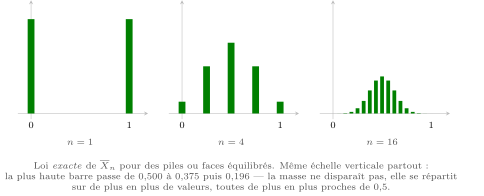
La moyenne empirique est centrée sur la bonne valeur — son espérance est exactement , quel que soit — et sa dispersion décroît, mais lentement : en , pas en .
Conséquence pratique, celle qui gouverne tout le chapitre suivant : quadrupler la taille de l'échantillon divise l'incertitude par deux seulement. C'est ce qui rend les sondages coûteux.
10.5 La loi faible des grands nombres
Soit une suite de variables aléatoires mutuellement indépendantes, admettant toutes la même espérance et la même variance. On pose . Alors
Démonstration
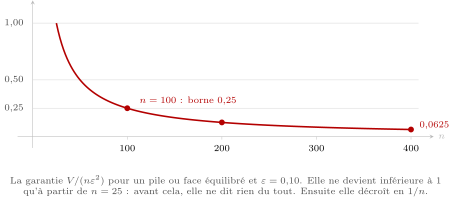
Notons la variance commune. La proposition précédente donne et . L'inégalité de Bienaymé-Tchebychev appliquée à s'écrit alors, pour tout :
Le membre de droite tend vers quand tend vers , puisque et sont fixés. Par encadrement, la probabilité du milieu tend vers .
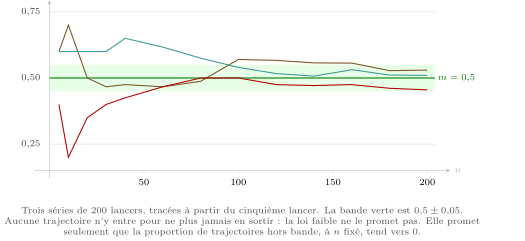
Fixons une tolérance , aussi petite qu'on veut — un point de pourcentage, un centime. L'énoncé dit que la probabilité de manquer la cible de plus de devient aussi petite qu'on veut pourvu qu'on prenne assez grand.
Il ne dit pas que finit par valoir : à tout rang, la probabilité de se tromper de plus de reste strictement positive. Elle devient seulement négligeable. C'est pourquoi on parle de loi faible.
Python : La loi faible, mesurée sur 2000 échantillons
import numpy as np
import numpy.random as rd

rd.seed(5)
eps = 0.05
for n in [50, 200, 800, 3200]:
    moy = np.mean(rd.randint(0, 2, (2000, n)), 1)
    hors = np.mean(np.abs(moy - 0.5) >= eps)
    print(n, hors, round(0.25 / (n * eps**2), 4))
# 50 0.4825 2.0
# 200 0.157 0.5
# 800 0.0035 0.125
# 3200 0.0 0.0312
La colonne du milieu est la proportion observée de moyennes hors de la bande ; la dernière est la garantie de Bienaymé-Tchebychev. La garantie est toujours plus grande — elle ne dit rien pour , où elle dépasse — et toutes deux tendent vers .
La loi faible des grands nombres justifie la lecture fréquentiste des probabilités : si l'on répète une expérience de façon indépendante, la fréquence observée d'un événement approche sa probabilité. En prenant égale à si l'événement se réalise à la -ème répétition et sinon, on a , et est exactement la fréquence observée.
C'est ce qui autorise, au chapitre suivant, à estimer un paramètre inconnu par une moyenne observée.