Statistique à deux variables quantitatives
Cours complet · mathématiques complémentaires (terminale), chapitre 10 · terminale, option mathématiques complémentaires
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Le carnet de santé d'un enfant contient une page quadrillée. À chaque visite, le pédiatre y reporte un point : l'âge en abscisse, la taille en ordonnée. Au bout de quelques années, ces points forment un nuage, et le médecin y lit deux choses qu'aucune mesure isolée ne donne — une tendance, et des écarts à cette tendance.
Toutes les disciplines qui mesurent deux grandeurs à la fois font ce geste : la dose d'un médicament et l'effet obtenu, la teneur de l'atmosphère en dioxyde de carbone et la température moyenne du globe, la superficie d'une île et le nombre d'espèces qui y vivent, le prix d'un bien et la quantité vendue, le revenu d'un pays et l'espérance de vie de ses habitants. Chaque fois, la question est la même : ces deux séries varient-elles ensemble, et si oui, comment.
Ce chapitre construit une réponse en quatre temps : résumer le nuage par une droite — la mieux placée possible, en un sens qu'il faudra définir ; mesurer la qualité de ce résumé ; redresser les nuages courbés pour se ramener au cas précédent ; et enfin savoir jusqu'où l'on a le droit d'aller. Ce dernier point est le plus important, et le plus mal compris. Une corrélation, même très forte, ne dit jamais qui cause quoi.
Problématique. Comment résumer un nuage de points par une droite, et que peut-on — ou ne peut-on pas — en déduire ?
10.1 Le nuage de points et le point moyen
10.1.1 Série statistique double
On observe deux caractères quantitatifs et sur les mêmes individus. On obtient une série statistique double, c'est-à-dire une liste de couples
Dans un repère, les points forment le nuage de points de la série.
Ce qui compte est que les deux mesures portent sur le même individu : l'âge et la taille du même enfant, la dose reçue et la baisse de tension du même patient. Apparier deux séries qui ne décrivent pas les mêmes individus n'a aucun sens, même si les calculs, eux, fonctionnent encore.
Le point moyen de la série est le point , où
Les écarts à la moyenne se compensent exactement :
Démonstration
En développant la première somme, , puisque par définition de . Le raisonnement est identique pour .
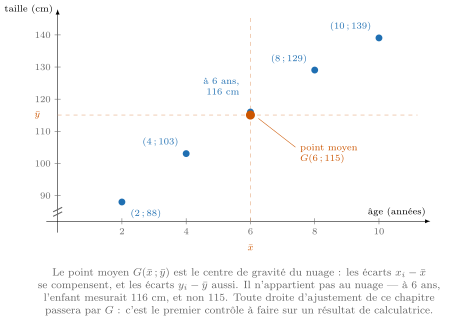
Un pédiatre relève, tous les deux ans, la taille d'un garçon (valeurs proches des courbes de référence de l'OMS, arrondies au centimètre) :
Ici et
Le point moyen est . Il n'est pas un point du nuage : à six ans, l'enfant mesurait cm.
10.1.2 Ajuster : remplacer un nuage par une droite
Ajuster affinement un nuage, c'est choisir une droite d'équation qui le résume, et remplacer la vraie valeur par la valeur prédite .
Encore faut-il que le nuage s'y prête. Le premier geste n'est donc pas un calcul mais un dessin : si les points s'organisent autour d'une droite, l'ajustement affine a un sens ; s'ils dessinent une courbe, il faudra le préparer (section sec:mc10chgvar).
Méthode : Un ajustement à la main : la droite des points moyens
Quand on ne dispose ni de calculatrice ni d'ordinateur, on obtient une droite raisonnable en trois gestes (méthode dite de Mayer) :
- ranger les points par abscisses croissantes et couper la série en deux moitiés de même effectif ;
- calculer le point moyen de la première moitié et le point moyen de la seconde ;
- tracer la droite .
Cette droite passe toujours par le point moyen de la série entière, car est le milieu de lorsque les deux moitiés ont le même effectif.
La droite des points moyens est commode mais arbitraire : elle dépend de la coupure choisie, et deux personnes peuvent obtenir deux droites. Il faut donc un critère, c'est-à-dire une définition de ce que veut dire la meilleure droite. C'est l'objet de la section suivante.
10.2 La droite des moindres carrés
10.2.1 Les résidus, et le critère
Pour une droite d'ajustement , le résidu du -ième individu est l'écart vertical
Il est positif si le point est au-dessus de la droite, négatif s'il est en dessous.
Pourquoi ne pas simplement demander que la somme des résidus soit nulle ? Parce qu'une infinité de droites le réalisent : un résidu de et un résidu de se compensent aussi bien que deux résidus nuls. On demande donc que la somme de leurs carrés soit la plus petite possible — les grands écarts, élevés au carré, deviennent alors très coûteux.
La droite des moindres carrés de en est la droite qui rend minimale la quantité
On l'appelle aussi droite de régression de en .
Les résidus se mesurent verticalement, et non perpendiculairement à la droite. Cela rend les deux variables dissymétriques : la droite des moindres carrés de en et celle de en sont deux droites différentes (elles ne coïncident que si les points sont parfaitement alignés). Il faut donc savoir laquelle des deux grandeurs on cherche à prédire — c'est elle qu'on met en ordonnée.
10.2.2 Le théorème, et sa démonstration
La covariance de la série double est le nombre
On rappelle que la variance de la série est , et que son écart type est ; de même .
On suppose que les ne sont pas tous égaux, c'est-à-dire . Alors il existe une unique droite des moindres carrés de en ; son équation est avec
En particulier, cette droite passe par le point moyen .
Démonstration (de la droite des moindres carrés)
Tout repose sur un fait de première : un trinôme dont le coefficient dominant est strictement positif atteint son minimum en , et en ce point seulement.
Première étape : à pente fixée, la hauteur. Fixons et posons . Alors
trinôme du second degré en de coefficient dominant . Son minimum est atteint pour
Quelle que soit la pente, la meilleure ordonnée à l'origine est : la droite optimale passe par .
Deuxième étape : la pente. Reportons . Le résidu s'écrit alors
Posons et . La somme à minimiser devient une fonction de la seule variable :
C'est encore un trinôme du second degré, en cette fois, de coefficient dominant , strictement positif par hypothèse. Son minimum est donc atteint en un unique point :
Conclusion. Notons cette pente et . Pour tout couple , la première étape donne , et la seconde . Le couple réalise donc bien le minimum de , et il est le seul.
Pour la droite des moindres carrés :
- elle passe par le point moyen : ;
- la somme des résidus est nulle : .
Démonstration
Le point 1 est la définition même de . Pour le point 2,
puisque .
Ces deux propriétés sont les vérifications à faire systématiquement après un calcul de calculatrice ou de programme. Si la droite obtenue ne passe pas par , ou si les résidus ne se compensent pas, c'est qu'une donnée a été mal saisie ou qu'on a échangé les deux listes. C'est le contrôle qui trahit un ajustement bricolé.
10.2.3 Calculer en pratique
Méthode : Obtenir la droite des moindres carrés
- Dessiner le nuage — d'abord, toujours. Si la forme n'est pas rectiligne, on s'arrête là et on passe à la section sec:mc10chgvar.
- Calculer et , puis les écarts et .
- Calculer comme le quotient de par , puis .
- Contrôler : la droite passe-t-elle par ? La somme des résidus est-elle nulle ?
Sur calculatrice, le mode statistique à deux variables donne directement et ; en Python, numpy.polyfit(x, y, 1) renvoie le couple .
On reprend la série du pédiatre, avec et :
D'où
La droite des moindres carrés est . La pente s'interprète : sur cette période, l'enfant grandit d'environ cm par an.
Contrôle. Les valeurs prédites sont ; ; ; ; , donc les résidus valent
de somme . Et : la droite passe bien par .
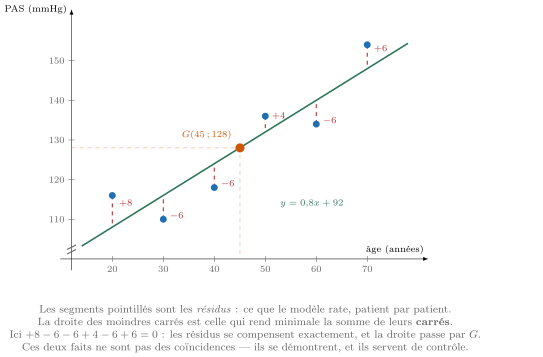
Six patients d'une même consultation (relevés fictifs, mais d'allure réaliste) : on note l'âge et la pression artérielle systolique , en mmHg.
On trouve , , puis et , d'où
La droite est : en moyenne, la systolique monte de mmHg par année d'âge, soit mmHg par décennie. Les résidus valent ; ; ; ; ; , de somme nulle.
Le nombre n'a, lui, aucun sens médical : il correspondrait à la pression d'un nouveau-né, très loin des données. On y reviendra à la section sec:mc10interp.
import numpy as np

def ajustement(x, y):
    # Renvoie (a, b, residus) pour la droite des moindres carres de y en x.
    x, y = np.array(x, float), np.array(y, float)
    xb, yb = x.mean(), y.mean()
    a = ((x - xb) * (y - yb)).sum() / ((x - xb) ** 2).sum()
    b = yb - a * xb
    return a, b, y - (a * x + b)

age    = [20, 30, 40, 50, 60, 70]
systol = [116, 110, 118, 136, 134, 154]
a, b, e = ajustement(age, systol)
print(a, b)                 # 0.8 92.0
print(e, e.sum())           # [ 8. -6. -6.  4. -6.  6.] 0.0
print(np.polyfit(age, systol, 1))   # [ 0.8 92. ]  -- meme resultat
10.3 Le coefficient de corrélation
La droite des moindres carrés existe toujours, même quand le nuage n'a aucune forme allongée : la formule ne proteste pas. Il faut donc un indicateur qui mesure à quel point le nuage est effectivement rectiligne.
On suppose et . Le coefficient de corrélation linéaire de la série double est
On a toujours . De plus si et seulement si les points du nuage sont exactement alignés.
Démonstration
Reprenons la fonction de la démonstration précédente, avec et :
C'est une somme de carrés : pour tout réel . Un trinôme de coefficient dominant strictement positif qui ne prend jamais de valeur strictement négative a un discriminant négatif ou nul :
c'est-à-dire . En divisant par le membre de droite, qui est strictement positif, on obtient , donc .
Le cas correspond à , c'est-à-dire à l'existence d'une valeur pour laquelle . Une somme de carrés est nulle seulement si chaque carré l'est : pour tout , autrement dit — tous les points sont sur une même droite.
Avec les notations du théorème,
En particulier et ont toujours le même signe, et mesure la part de la dispersion de que la droite explique.
Démonstration
La première égalité est immédiate : . Pour la seconde, on reporte dans :
Si , alors : tous les résidus sont nuls, le modèle est exact. Si , alors : la droite des moindres carrés est horizontale et ne fait pas mieux que de prédire pour tout le monde. En pratique, au lycée, on retient comme un alignement convaincant, sans lui donner la valeur d'un test.
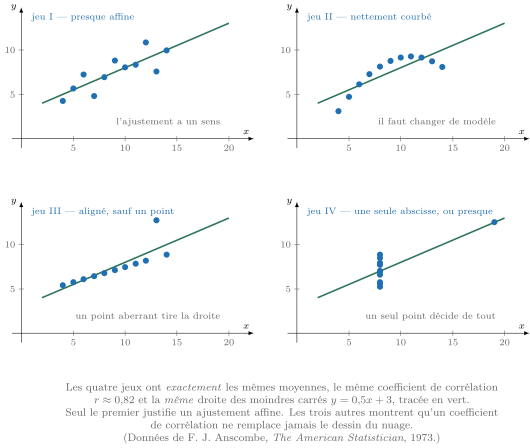
Le coefficient ne mesure qu'une chose : la proximité du nuage à une droite. Un proche de ne veut pas dire aucun lien — il peut y avoir un lien parfait mais courbé, en cloche ou en U, que ne voit pas. Et un proche de ne garantit pas que le modèle affine soit le bon : le jeu II d'Anscombe, très nettement courbé, affiche . On regarde toujours le nuage, puis les résidus, avant de faire confiance à .
Pour la taille de l'enfant, , et , donc
alignement quasi parfait. Pour les pressions artérielles, le même calcul donne — une tendance nette, mais des individus qui s'en écartent franchement. Pour le prix d'un bien et la quantité vendue, on trouvera au contraire un négatif : les deux séries varient en sens contraire.
10.4 Se ramener à un ajustement affine
Beaucoup de phénomènes ne sont pas affines : une population qui se multiplie, un médicament qui s'élimine, un nombre d'espèces qui croît avec la surface. Leur nuage est courbé. L'idée est alors de changer de variable pour redresser le nuage, d'ajuster affinement le nuage redressé, puis de revenir au modèle de départ.
Méthode : Les trois changements de variable classiques
- Modèle exponentiel (croissance ou décroissance à taux constant). On pose ; alors
qui est affine en . On ajuste en : la pente donne , et l'ordonnée à l'origine donne .
- Modèle puissance (lois d'échelle, biologie, géographie). On pose et ; alors
affine en . La pente est directement l'exposant .
- Modèle inverse . On pose ; alors , affine en .
Dans les trois cas : on transforme, on ajuste, on revient.
Pour une scintigraphie, on injecte du technétium 99m. Un compteur mesure l'activité du traceur, en mégabecquerels, toutes les deux heures :
Le nuage est courbé, mais le nuage est remarquablement aligné : la calculatrice donne
On revient au modèle de départ :
La demi-vie du traceur est le temps tel que , soit
ce qui restitue à un centième d'heure près la demi-vie tabulée du technétium 99m, heures.
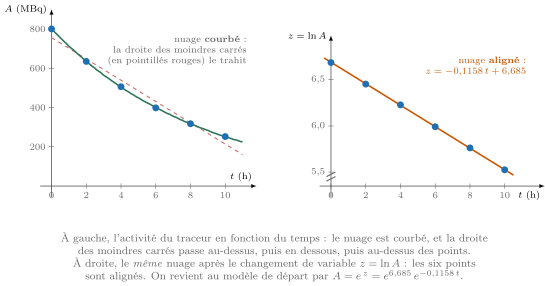
Ajuster après transformation n'est pas la même chose qu'ajuster avant : les moindres carrés sur minimisent les écarts sur les logarithmes, ce qui revient à donner plus de poids aux petites valeurs de . Les deux modèles obtenus ne coïncident pas exactement. Ce n'est pas une erreur — c'est un choix, et le choix logarithmique est le bon quand ce sont les écarts relatifs qui comptent, ce qui est le cas de tous les phénomènes multiplicatifs.
Le choix du changement de variable ne se devine pas : il vient du mécanisme. Une quantité qui perd le même pourcentage par unité de temps appelle . Une quantité qui double quand une autre est multipliée par une constante appelle contre . Un tracé de contre , puis de contre , tranche en quelques secondes : le nuage le plus droit gagne.
10.5 Interpoler, extrapoler
Soit l'intervalle balayé par les abscisses observées. Utiliser l'ajustement pour estimer en une valeur :
- à l'intérieur de , c'est interpoler ;
- à l'extérieur de , c'est extrapoler.
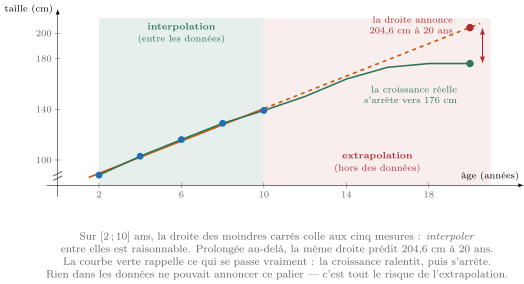
Interpoler est raisonnable ; extrapoler est un pari. Les données ne contiennent aucune information sur ce qui se passe hors de leur intervalle : c'est le modèle seul qui parle, et rien ne garantit qu'il vaille encore. La droite ajustée sur la croissance d'un enfant de à ans annonce cm à ans ; la même droite, prolongée vers l'arrière, annonce cm à la naissance et une taille négative avant. Un coefficient de corrélation de n'y change rien : il mesure l'ajustement sur les données, pas sa validité ailleurs.
Trois réflexes avant d'annoncer une prévision.
- Où suis-je ? Dans l'intervalle des données, ou en dehors — et de combien ?
- Le résultat est-il possible ? Un pourcentage supérieur à , une quantité négative, une taille de m signalent que le modèle a quitté son domaine de validité.
- Le mécanisme tient-il encore ? Une croissance s'arrête, un marché sature, une population plafonne. Si le mécanisme change, le modèle change.
10.6 Corrélation n'est pas causalité
C'est le point de ce chapitre que l'on retiendra le plus longtemps, et le seul qui serve tous les jours en dehors du cours de mathématiques.
Une corrélation forte entre deux variables et est compatible avec au moins quatre situations distinctes :
- causalité directe : agit sur ;
- variable de confusion : une troisième variable agit sur et sur , sans qu'il y ait de lien entre eux ;
- causalité inversée : c'est qui agit sur ;
- coïncidence : aucun lien, mais deux séries qui se ressemblent — d'autant plus facile à trouver qu'on cherche parmi beaucoup de séries.
Aucun calcul statistique effectué sur les seules données ne permet de distinguer ces quatre cas.
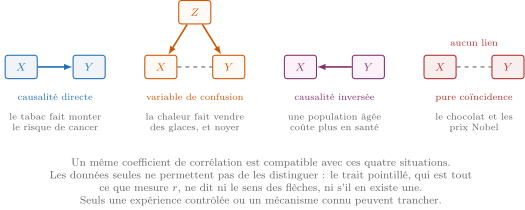
Dans une région littorale, les ventes de glaces et le nombre de noyades accidentelles, relevés mois par mois, sont corrélés à . Interdire les glaces ne sauvera pourtant personne : la chaleur estivale fait à la fois vendre des glaces et attirer les baigneurs. La température est ici la variable de confusion. L'exercice qui reprend ces données le montre par le calcul : une fois retiré l'effet de la température de chacune des deux séries, il ne reste plus aucune corrélation entre elles.
Trois questions à se poser devant une corrélation, avant toute conclusion.
- Existe-t-il un mécanisme plausible qui relie à ? Sait-on comment l'un agirait sur l'autre ?
- Quelle troisième variable pourrait expliquer les deux à la fois ? (Le temps, la richesse, l'âge, la taille de la population sont les confondantes les plus fréquentes.)
- Le sens est-il le bon ? Que se passe-t-il si l'on retourne la flèche ?
Une seule méthode tranche vraiment : l'expérience contrôlée. On répartit les individus au hasard en deux groupes, on applique le traitement à l'un et pas à l'autre, et l'on compare. Le tirage au sort casse le lien avec toutes les variables de confusion, connues ou non — c'est exactement ce que fait un essai clinique randomisé. Quand l'expérience est impossible (on ne tire pas au sort les pays qui augmenteront leurs dépenses de santé), on ne dispose que de corrélations, et la prudence reste de mise.
10.7 Bilan
- Un nuage se résume d'abord par son point moyen , où les écarts à la moyenne se compensent.
- La droite des moindres carrés de en minimise la somme des carrés des résidus . Elle a pour coefficients
La démonstration tient en deux trinômes : l'un en à pente fixée, l'autre en .
- Deux contrôles gratuits : la droite passe par , et la somme des résidus est nulle. Un ajustement qui les rate est faux.
- Le coefficient de corrélation vérifie , avec exactement lorsque les points sont alignés. Il ne mesure que l'alignement : on regarde toujours le nuage, puis les résidus.
- Un nuage courbé se redresse par un changement de variable : pour un modèle exponentiel, pour un modèle puissance, pour un modèle inverse. On transforme, on ajuste, on revient.
- Interpoler entre les données est raisonnable ; extrapoler au-delà est un pari, que ni un beau ni un joli graphique ne justifient.
- Enfin, et surtout : une corrélation, même forte, n'établit jamais une causalité. Variable de confusion, causalité inversée, pure coïncidence — seules une expérience contrôlée ou la connaissance d'un mécanisme peuvent trancher.