Thème 6 — Inférence bayésienne
Cours · mathématiques complémentaires (terminale), chapitre 16 · terminale, option mathématiques complémentaires · le début du chapitre, la suite sur Adloun
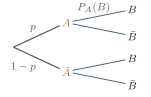
Le chapitre 8 s'est terminé sur un calcul déconcertant. Un test de dépistage qui détecte des malades, appliqué à une population où la maladie touche une personne sur cent, donne cinq faux positifs pour un vrai. Le calcul tenait en trois lignes, et pourtant sa conclusion contredit l'intuition de presque tout le monde — y compris, les enquêtes le montrent régulièrement, celle des professionnels de santé.
Ce n'était ni un paradoxe ni une bizarrerie de la loi binomiale. C'était le premier exemple d'un raisonnement qui porte un nom, qui a une formule, et dont le champ d'application dépasse largement la médecine : à chaque fois qu'un indice imparfait tombe — un test positif, une alarme, un mot suspect dans un courriel, un voyant qui s'allume, une trace sur une scène de crime —, il faut décider ce que cet indice change à ce que l'on croyait avant de l'observer. C'est l'inférence bayésienne.
Ce thème reprend ce calcul là où le chapitre 8 l'a laissé, et en fait une étude complète : la formule qui le produit et sa démonstration, la manière de le poser pour qu'il devienne évident, la quantité qui en commande le résultat, la façon d'enchaîner plusieurs indices, et quatre situations qui n'ont rien de médical — un filtre de courriels, un diagnostic de panne, la recherche d'un canot en mer, une erreur judiciaire.
Problématique. Un indice vient de tomber. De combien doit-il modifier ce que je croyais avant ?
Ce que ce thème mobilise. Les probabilités conditionnelles, l'arbre pondéré et la loi binomiale du chapitre 8 ; la dérivée d'un quotient et l'étude des variations du chapitre 4 ; la convexité du chapitre 5 ; l'équation fonctionnelle du logarithme et la recherche de seuils du chapitre 3 ; les suites géométriques et arithmétiques du chapitre 1 ; et, pour lire le comportement d'une valeur prédictive aux petites prévalences, l'approche intuitive des limites du chapitre 2.
16.1 Le renversement du conditionnement
16.1.1 Deux questions qu'on prend l'une pour l'autre
Rappelons la définition vue en première, et déjà utilisée au chapitre 8.
Soit un événement de probabilité non nulle. La probabilité de sachant est
Elle mesure la proportion de à l'intérieur de , et non dans l'univers tout entier.
Les deux nombres et ont le même numérateur, , mais pas le même dénominateur. Rien n'oblige donc à ce qu'ils se ressemblent, et le plus souvent ils ne se ressemblent pas du tout.
et ne sont pas la même chose. « Presque tous les joueurs de basket professionnels mesurent plus de m » est vrai ; « presque toutes les personnes qui mesurent plus de m sont joueurs de basket professionnels » est faux, et grossièrement. Les deux phrases portent pourtant sur le même croisement de deux caractères.
En dépistage, c'est exactement la même confusion : — la probabilité qu'un malade soit détecté — vaut dans l'exemple qui suivra, tandis que — la probabilité qu'un individu détecté soit malade — n'y vaut que .
La difficulté n'est pas mathématique : elle est de langage. Les données d'un énoncé sont presque toujours des , parce que ce sont elles que l'on mesure — on teste des malades connus pour évaluer un test. La question posée, elle, est presque toujours un , parce que c'est elle qui se pose en pratique — on voit un résultat, on ignore l'état. Tout le travail consiste à renverser le conditionnement.
16.1.2 L'arbre pondéré et la formule des probabilités totales
L'outil de base est l'arbre pondéré du chapitre 8, construit dans le sens des données : la cause d'abord, l'indice ensuite.
Soit un événement tel que et , et soit un événement quelconque. Alors
Autrement dit : la probabilité d'un indice se lit sur l'arbre en additionnant les chemins qui y mènent.
Démonstration
Les deux événements et sont incompatibles — un même résultat ne peut pas être à la fois dans et dans — et leur réunion est tout entier, puisque tout résultat de est ou bien dans , ou bien dans . L'additivité donne donc
Il reste à réécrire chaque terme avec la définition d'une probabilité conditionnelle : et .
La formule vaut de la même façon pour trois causes ou davantage, dès lors qu'elles sont deux à deux incompatibles et qu'elles recouvrent tous les cas possibles : on additionne alors autant de chemins qu'il y a de causes. Nous l'admettons sous cette forme générale et nous l'utiliserons plus loin avec trois causes de panne, puis avec trois zones de recherche ; la démonstration est mot pour mot la même.
Une boîte de réception reçoit courriels, dont sont indésirables : . Le mot « gratuit » apparaît dans des courriels indésirables et dans des courriels légitimes. En notant l'événement « le courriel contient le mot gratuit », la formule des probabilités totales donne
Sur courriels, contiennent donc le mot : indésirables et légitimes.
16.2 La formule de Bayes
Soit un événement tel que et , et soit un événement de probabilité non nulle. Alors
Démonstration
Par définition d'une probabilité conditionnelle, puis de nouveau par cette même définition appliquée dans l'autre sens,
Le numérateur est le poids du chemin qui passe par ; il ne reste qu'à remplacer le dénominateur par la formule des probabilités totales,
ce qui donne exactement l'égalité annoncée.
La formule ne contient rien de plus que la définition d'une probabilité conditionnelle et un découpage en deux cas. Ce n'est pas un théorème difficile : c'est un théorème utile, parce qu'il nomme et automatise un renversement que l'intuition rate.
Méthode : Renverser un conditionnement en trois lignes
- Nommer les deux événements et repérer, dans l'énoncé, lequel est la cause (celle dont on connaît la fréquence globale) et lequel est l'indice (celui que l'on observe).
- Construire l'arbre dans le sens des données : cause d'abord, indice ensuite. Les branches du premier niveau portent et ; celles du second, les et .
- Écrire le quotient : au numérateur le chemin qui contient à la fois la cause cherchée et l'indice observé, au dénominateur la somme de tous les chemins portant l'indice.
Un courriel vient d'arriver et contient le mot « gratuit ». Quelle est la probabilité qu'il soit indésirable ? Le numérateur est le chemin « indésirable puis gratuit », soit ; le dénominateur est :
Trois quarts des courriels contenant le mot sont indésirables — à comparer aux de l'énoncé, qui répondaient à une tout autre question.