Thème 7 — Répétition d'expériences indépendantes, échantillonnage
Cours · mathématiques complémentaires (terminale), chapitre 17 · terminale, option mathématiques complémentaires · le début du chapitre, la suite sur Adloun
Le même mois, sur la même question — l'adoption d'une réforme soumise à référendum —, deux instituts publient deux chiffres. Le premier annonce de soutien, le second . Les deux ont interrogé mille personnes. La presse titre sur un « retournement de l'opinion », les commentateurs cherchent l'événement qui, entre les deux enquêtes, aurait fait basculer trois points.
Il n'y a peut-être rien eu à basculer. Deux enquêtes menées le même jour, dans la même population, par des instituts également honnêtes, ne donnent pas le même résultat — parce qu'elles n'interrogent pas les mêmes gens. Cet écart-là n'est pas une erreur : il est la conséquence mécanique du tirage au sort. Il porte un nom, la fluctuation d'échantillonnage, et il se calcule.
Ce thème est une étude suivie de deux à quatre semaines. Elle part de la question précédente et n'y répond qu'au dernier problème. Elle mobilise le chapitre 8 (schéma de Bernoulli, loi binomiale, détermination d'un intervalle tel que ), le chapitre 9 (simuler une variable de Bernoulli à partir d'un tirage uniforme sur ), le chapitre 10 (ajustement affine après changement de variable), et, en chemin, le chapitre 4 (dérivée et tableau de variation), le chapitre 3 (logarithme) et le chapitre 2 (limites).
Problématique. De combien la fréquence observée sur un échantillon peut-elle s'écarter de la proportion vraie, que coûte le fait de réduire cet écart, et que reste-t-il de tout cela si l'échantillon est mal tiré ?
17.1 La question, et ce qu'il faut de neuf pour y répondre
17.1.1 Ce que le chapitre 8 sait déjà faire, et ce qui manque
Le modèle est acquis. On interroge personnes tirées au hasard dans une population très grande devant , de sorte que le tirage soit assimilable à un tirage avec remise : chaque personne interrogée est une épreuve à deux issues — favorable ou non —, les épreuves sont indépendantes et de même paramètre , la proportion de favorables dans la population. Le nombre de personnes favorables suit donc la loi binomiale , et le chapitre 8 en donne tout :
les deux dernières formules étant admises par le programme. Il sait même déterminer un intervalle tel que .
Il manque pourtant l'essentiel pour lire un sondage. Un institut ne publie pas « personnes favorables sur » : il publie « ». Et la question posée n'est jamais « combien de personnes ? » mais « de combien ce pourcentage peut-il se tromper ? ». Il faut donc changer de variable.
17.1.2 La fréquence observée
On répète fois, de façon indépendante, une même épreuve de Bernoulli de paramètre , et l'on note le nombre de succès. La fréquence observée de succès sur cet échantillon est la variable aléatoire
Elle prend ses valeurs parmi .
Si suit et si , alors
Démonstration
On utilise deux résultats de la classe de première, que nous admettons ici : pour tout nombre , et . Avec , et en reprenant les valeurs admises du chapitre 8 :
Ces deux formules disent tout le thème, et il faut les lire séparément.
: la fréquence observée vise juste. Elle ne dérive pas, elle ne penche d'aucun côté — à condition que l'échantillon ait été tiré au hasard dans la bonne population. C'est cette condition, et non le calcul, qui fera défaut à la section 6.
: elle vise juste mais elle tremble, et son tremblement décroît comme — pas comme . Toute la section 4 tient dans cette racine carrée.
Pour et :
soit environ point de pourcentage. Deux écarts types font points : un sondage sur mille personnes situe la proportion à environ trois points près, et non à un dixième de point près. Les trois points qui séparent nos deux instituts sont exactement de cet ordre.
17.2 Voir la fluctuation : simuler beaucoup d'échantillons
Le calcul donne un écart type. Il ne montre pas ce qu'est la fluctuation. Pour la voir, il faut faire ce qu'aucun institut ne peut se permettre : refaire l'enquête des milliers de fois dans une population dont on connaît la vraie proportion. C'est précisément ce qu'un ordinateur sait faire.
17.2.1 Le protocole
Méthode : Simuler une campagne d'échantillonnage
- Fixer la population : on se donne , que l'on connaît puisque c'est nous qui le choisissons.
- Un échantillon : répéter fois le tirage d'un nombre au hasard dans et compter un succès chaque fois qu'il est inférieur à (chapitre 9). Diviser par : on obtient une réalisation de .
- Une campagne : recommencer fois, avec grand ( ici).
- Regarder la liste des fréquences obtenues : sa moyenne, son écart type, son histogramme.
On fixe la graine du générateur : sans cela, deux exécutions ne donnent pas les mêmes chiffres et rien n'est vérifiable.
from random import random, seed

def succes(n, p):
    # Nombre de succes sur n epreuves independantes de parametre p.
    total = 0
    for _ in range(n):
        if random() < p:
            total = total + 1
    return total

def echantillon(n, p):
    # Frequence observee de succes sur un echantillon de taille n.
    return succes(n, p) / n

def campagne(n, p, M):
    # M echantillons independants de taille n : la liste des M frequences.
    return [echantillon(n, p) for _ in range(M)]

def moyenne(valeurs):
    return sum(valeurs) / len(valeurs)

def ecart_type(valeurs):
    m = moyenne(valeurs)
    return (sum((v - m) ** 2 for v in valeurs) / len(valeurs)) ** 0.5

seed(2027)
for n in [25, 100, 400]:
    f = campagne(n, 0.52, 10000)
    print(n, round(moyenne(f), 4), round(ecart_type(f), 4),
          round((0.52 * 0.48 / n) ** 0.5, 4))
Sortie du programme :
25 0.5193 0.1004 0.0999
100 0.5197 0.0501 0.05
400 0.5201 0.0246 0.025
Les trois colonnes de droite se comparent deux à deux : l'écart type observé sur échantillons et l'écart type calculé coïncident à la troisième décimale. La proposition de la section précédente n'est pas seulement démontrée, elle est vérifiée.
17.2.2 Trois histogrammes
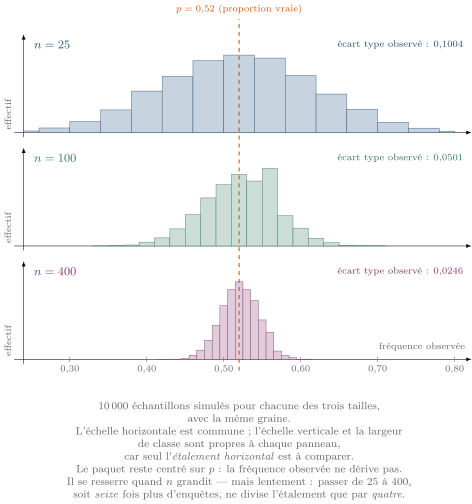
Les trois paquets sont centrés au même endroit et n'ont pas la même largeur. C'est la totalité du phénomène. Augmenter ne déplace pas la fréquence observée vers la bonne valeur — elle y était déjà en moyenne : cela réduit son tremblement.
Le hasard ne « se compense » pas. Sur personnes interrogées, il n'y a aucun mécanisme qui rattraperait une série de réponses favorables par une série de réponses défavorables : les épreuves sont indépendantes, et chacune ignore les précédentes (c'est déjà ce que disait l'absence de mémoire, au chapitre 8). Si le paquet se resserre, ce n'est pas parce que les écarts se corrigent, c'est parce qu'un écart de points sur épreuves demande une conspiration bien plus improbable qu'un écart de points sur .
17.3 L'intervalle de fluctuation, et le sens de sa lecture
17.3.1 Le passer en fréquences
Méthode : De l'intervalle du chapitre 8 à une fourchette de pourcentages
Le chapitre 8 fournit , plus petit intervalle d'entiers tel que : est le plus petit entier avec , et le plus petit entier avec .
Comme équivaut à , et de même à gauche, on a exactement le même événement des deux côtés :
La fourchette de pourcentages cherchée est donc : on divise les deux bornes par , et rien d'autre.
Le programme du chapitre 8 calculait directement. Il suffit tant que reste modeste ; ici, vaudra . Nous le remplaçons donc par un calcul de proche en proche à partir du mode, qui ne fabrique aucun nombre géant : on part d'un poids arbitraire égal à en , on propage par la relation
qui se lit directement sur l'expression de la loi binomiale, puis on divise par la somme obtenue.