Thème 9 — Corrélation et causalité
Cours · mathématiques complémentaires (terminale), chapitre 19 · terminale, option mathématiques complémentaires · le début du chapitre, la suite sur Adloun
Une agence du médicament doit décider si elle rembourse un traitement. Un rectorat doit décider s'il finance des heures de soutien. Un maire doit décider s'il installe un radar. Aucune de ces trois questions n'est une question de corrélation : ce sont des questions de causalité. Celui qui décide ne demande pas « ces deux grandeurs varient-elles ensemble ? » mais « si j'agis sur celle-ci, qu'arrive-t-il à celle-là ? ». Et cette seconde question, le chapitre 10 l'a laissée sans réponse.
Il a fait mieux que cela : il a montré qu'aucun calcul mené sur les seules colonnes ne pouvait y répondre. Un même coefficient de corrélation est compatible avec une causalité directe, une causalité inversée, une variable de confusion et une pure coïncidence. Le chapitre s'arrêtait là, sur un avertissement.
Ce thème reprend l'affaire à cet endroit précis. Il ne s'agit plus de se méfier, mais de trancher : quels gestes, quelles données, quelles précautions permettent de dire — et parfois de démontrer — que l'un cause l'autre. Nous verrons que le statisticien dispose d'un instrument souverain, l'expérience randomisée, et qu'il lui arrive de ne pas pouvoir s'en servir : on ne tire pas au sort les gens à qui l'on fera fumer trois paquets par jour. Il faut alors reconstituer la preuve autrement, comme on l'a fait pour le tabac entre 1950 et 1965.
Question directrice. Comment sait-on qu'une chose en cause une autre — et que fait-on quand on ne peut pas faire l'expérience ?
Ce que ce thème mobilise. Le chapitre 10 fournit tout le socle : nuage, point moyen, droite des moindres carrés, résidus, coefficient de corrélation. Le chapitre 8 fournit l'instrument de mesure du hasard : schéma de Bernoulli, loi binomiale, coefficients binomiaux, intervalle de fluctuation — c'est lui qui dira si un écart entre deux groupes mérite qu'on s'y arrête. Le chapitre 9 fournit la loi uniforme sur , celle avec laquelle on fabrique un tirage au sort en Python. Le chapitre 3 sert à lire un rapport de risques sur une échelle multiplicative, et le chapitre 4 à interpréter une pente. Le thème est prévu pour deux à quatre semaines.
19.1 Une corrélation, quatre histoires : comment les départager
19.1.1 Là où le chapitre 10 s'est arrêté
Rappelons la situation. On observe entre deux séries et . Quatre récits l'expliquent aussi bien l'un que l'autre :
- causalité directe — agit sur ;
- causalité inversée — c'est qui agit sur ;
- variable de confusion — une troisième grandeur agit sur les deux ;
- coïncidence — rien n'agit sur rien, et deux séries se ressemblent.
Le chapitre 10 concluait qu'aucun calcul sur les données ne les distingue. C'est exact, et c'est justement pour cela que l'affaire n'est pas close : si les données actuelles ne suffisent pas, il faut aller en chercher d'autres. Les quatre récits ne sont pas également fragiles ; chacun a un point faible, et chaque point faible se vise avec un instrument.
Les quatre lectures s'accordent sur le nuage observé, mais elles ne s'accordent pas sur ce qu'on trouverait ailleurs.
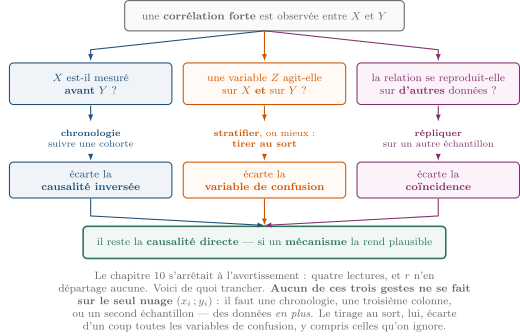
La troisième colonne est le cœur de ce thème. Chacun de ces instruments demande des données que le nuage ne contient pas : une date de mesure, une troisième colonne, un second échantillon, ou une intervention. Aucune statistique plus savante appliquée aux mêmes deux colonnes ne remplacera cela.
19.1.2 Trois gestes, trois lectures écartées
Méthode : Écarter la causalité inversée : la chronologie
On exige que l'exposition soit mesurée avant l'issue. Deux dispositifs le permettent :
- l'étude de cohorte : on part d'un groupe de personnes saines, on relève leur exposition aujourd'hui, et on les suit pendant des années en comptant les cas ;
- l'étude cas-témoins : on part des malades, on leur trouve des témoins comparables, et on reconstitue le passé de chacun.
La cohorte est la plus solide, car l'exposition est enregistrée quand personne n'est encore malade ; elle est aussi la plus lente et la plus chère.
La chronologie est nécessaire mais pas suffisante. Que précède n'exclut ni la confusion ni la coïncidence : la vente de maillots de bain précède les noyades d'été, sans rien y causer. Une cause doit précéder son effet ; ce qui précède n'est pas pour autant une cause.
Méthode : Écarter la variable de confusion : stratifier, ou tirer au sort
- Stratifier : on découpe la population selon et on refait le calcul à l'intérieur de chaque strate, là où ne varie plus. C'est l'objet de la section sec:t9strat.
- Tirer au sort : on décide de par une pièce de monnaie. Aucune variable, mesurée ou non, ne peut alors influencer . C'est l'objet de la section sec:t9ecr.
La différence est capitale : la stratification ne neutralise que les auxquels on a pensé et qu'on a mesurés ; le tirage au sort les neutralise tous.
Méthode : Écarter la coïncidence : annoncer avant, puis répliquer
Une corrélation qui n'a pas été prévue doit être vérifiée sur des données que l'on n'avait pas encore vues. Deux pratiques :
- préenregistrer : écrire la relation que l'on va chercher avant de regarder les chiffres ;
- répliquer : retrouver la même relation sur un second échantillon, recueilli indépendamment.
19.1.3 La coïncidence n'est pas rare : elle se fabrique
On croit volontiers qu'une corrélation à ne peut pas être due au hasard. Cela dépend entièrement d'une chose : combien de corrélations a-t-on regardées.
À partir de séries statistiques, le nombre de couples que l'on peut former est
Démonstration
Choisir un couple de séries, c'est choisir une partie à deux éléments dans un ensemble à éléments : c'est exactement ce que compte le coefficient binomial , dont le chapitre 8 a donné la valeur .
Le nombre de paires croît comme le carré du nombre de séries : dix séries donnent paires, cent séries en donnent , deux cents en donnent . Un service statistique qui publie deux cents indicateurs met donc en ligne, sans le savoir, vingt mille corrélations.
Pour deux séries sans aucun lien de douze valeurs chacune, on admet que
Si l'on examine paires, le nombre de celles qui franchissent ce seuil est donc en moyenne voisin de .
On tire cent séries de douze nombres au hasard, indépendantes les unes des autres : par construction, aucune ne cause aucune autre. On calcule les coefficients de corrélation. On s'attend à environ paires au-delà de ; le tirage en donne , dont au-delà de et au-delà de . La meilleure atteint .
Présentée seule, avec son nuage bien aligné, cette paire ferait un très joli graphique. Elle ne repose sur rien.
import random
from math import sqrt
from itertools import combinations

def correlation(x, y):
    n = len(x)
    mx, my = sum(x) / n, sum(y) / n
    sxy = sum((x[i] - mx) * (y[i] - my) for i in range(n))
    sx = sqrt(sum((t - mx) ** 2 for t in x))
    sy = sqrt(sum((t - my) ** 2 for t in y))
    return sxy / (sx * sy)

random.seed(9)
series = [[random.gauss(0, 1) for _ in range(12)] for _ in range(100)]
rs = [abs(correlation(a, b)) for a, b in combinations(series, 2)]
print(len(rs), round(max(rs), 4))              # 4950 0.8487
print(sum(1 for t in rs if t > 0.576))         # 241   (attendu ~248)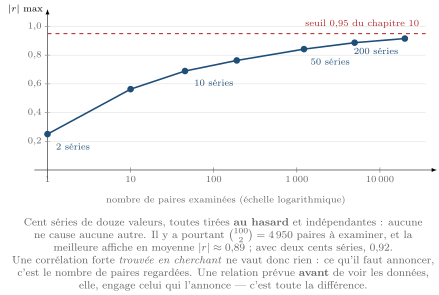
Devant une corrélation spectaculaire, la question à poser n'est pas « combien vaut ? » mais « combien de paires ont été regardées avant de retenir celle-ci ? ». Une relation annoncée avant de voir les données engage celui qui l'annonce ; une relation trouvée en cherchant n'engage personne, et doit être rejouée sur des données neuves.
19.2 L'expérience randomisée contrôlée
19.2.1 Observer, ou intervenir
Il faut d'abord voir que deux questions se cachent sous la même phrase.
Soit une exposition et une issue.
- La question observationnelle : sachant que j'observe , à quoi dois-je m'attendre pour ? C'est celle à laquelle répond la droite des moindres carrés du chapitre 10.
- La question interventionnelle : si j'impose , que devient ? C'est celle que pose toute décision.
Ces deux questions ont des réponses différentes, et parfois de signes contraires. La section sec:t9strat en donnera un exemple chiffré : une droite des moindres carrés impeccable annonce , alors que l'effet réel de l'intervention vaut . Le calcul n'est pas faux ; il répond à l'autre question.
La raison de l'écart est toujours la même : quand on observe, ce sont les patients (ou les élèves, ou les pays) qui décident de leur exposition, et ils décident en fonction de ce qu'ils sont. Quand on intervient, c'est l'expérimentateur qui décide. Toute la difficulté est de faire décider quelqu'un qui ne sait rien des individus. Ce quelqu'un existe : c'est le hasard.
19.2.2 Pourquoi le tirage au sort règle le problème
Une expérience randomisée contrôlée comporte quatre pièces :
- on constitue un groupe d'individus éligibles, tous inclus ;
- on les répartit au hasard en un groupe traité et un groupe témoin ;
- le groupe témoin reçoit un placebo, c'est-à-dire une intervention d'apparence identique et sans principe actif ;
- la mesure de l'issue se fait en aveugle : celui qui mesure ignore à quel groupe appartient le patient.
En médecine on parle d'essai clinique randomisé.
Si l'affectation au groupe traité est décidée par un tirage au sort, alors aucune caractéristique des individus — mesurée ou non, connue ou inconnue — n'influence cette affectation. Les deux groupes ne diffèrent donc que par le hasard du tirage, et ce hasard-là est de loi connue.
Exercices du chapitre
- Le tirage au sort équilibre-t-il vraiment les groupes ? corrigé
- Lire le résultat d'un essai randomisé corrigé
- Stratifier, et voir la pente s'inverser corrigé
- Problème — Un essai randomisé, du protocole à la conclusion corrigé
- Le soutien scolaire fait-il baisser les notes ? corrigé
- Le paradoxe de Simpson, sur des chiffres corrigé