Statistiques bivariées et régression linéaire
Cours complet · mathématiques appliquées (ECG 2e année), chapitre 7 · prépa ECG, 2e année
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
La première année a décrit une série de nombres : moyenne, variance, médiane. On dispose ici de deux mesures faites sur les mêmes individus — la croissance et le chômage d'un pays, le revenu et la consommation d'un ménage, la publicité et les ventes d'une entreprise — et la question change de nature : ces deux grandeurs varient-elles ensemble, et si oui, comment ?
Ce chapitre y répond par trois nombres : la covariance, qui mesure la tendance commune ; le coefficient de corrélation, qui la ramène à une échelle universelle ; et la droite de régression, qui résume le nuage par une relation affine.
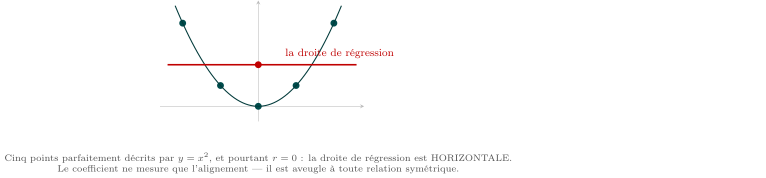
Un coefficient de corrélation proche de dit que les points s'alignent, rien de plus. Il ne dit ni que l'une des grandeurs cause l'autre, ni que la relation est linéaire en dehors des données observées. Le programme insiste : « on discutera de la pertinence d'une régression linéaire selon les données observées ».
7.1 Le nuage de points
7.1.1 Le jeu de données du chapitre
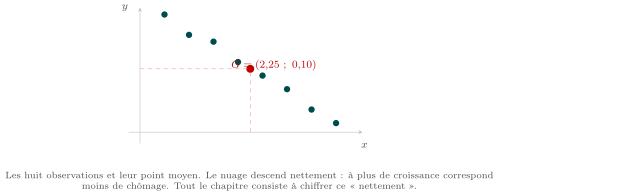
On dispose de huit observations. La variable est la croissance annuelle du PIB, en pourcentage ; la variable est la variation du taux de chômage sur la même année, en points.
| (croissance, %) | ||||||||
|---|---|---|---|---|---|---|---|---|
| (chômage, points) |
Ces valeurs sont fictives, mais elles illustrent une régularité empirique bien réelle, la loi d'Okun : plus la croissance est forte, plus le chômage recule.
Le nuage est l'ensemble des points du plan. Le point moyen est , où
7.2 Covariance et corrélation
Lorsque , on retrouve la variance empirique .
Démonstration
En développant le produit dans la définition :
et les trois derniers termes valent .
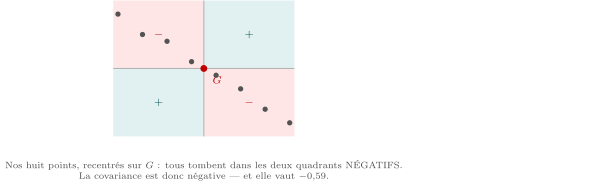
Découpons le plan en quatre quadrants centrés en . Un point situé en haut à droite ou en bas à gauche donne un produit positif ; un point en haut à gauche ou en bas à droite donne un produit négatif. La covariance est la moyenne de ces produits : elle est positive si le nuage penche à droite, négative s'il penche à gauche.
Si et ,
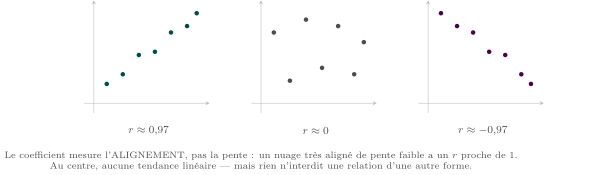
, et si et seulement si tous les points du nuage sont alignés.
- proche de : les points s'alignent sur une droite montante ;
- proche de : ils s'alignent sur une droite descendante ;
- proche de : aucune tendance linéaire — ce qui ne veut pas dire aucune relation.
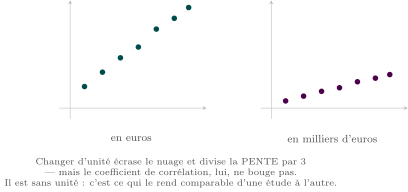
Le coefficient est sans unité : il ne change pas si l'on convertit des euros en milliers d'euros. C'est ce qui le rend comparable d'une étude à l'autre.
On calcule, sur les huit observations :
Le coefficient est très proche de : les points sont presque parfaitement alignés sur une droite descendante.
7.3 Ajustement des moindres carrés
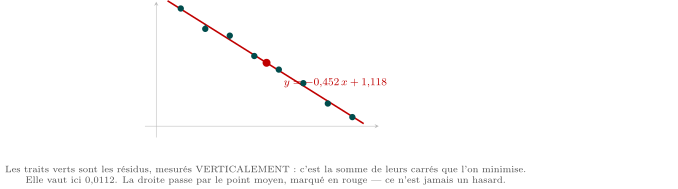
C'est la droite qui minimise la somme des carrés des résidus
En particulier, la droite passe toujours par le point moyen .
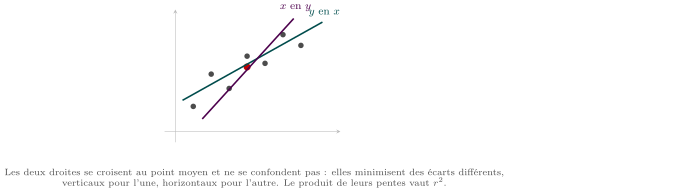
En échangeant les rôles, on obtient la droite de en , de coefficient directeur . Les deux droites passent par mais ne coïncident pas, sauf si . Il faut donc choisir laquelle des deux variables on explique, et le dire.
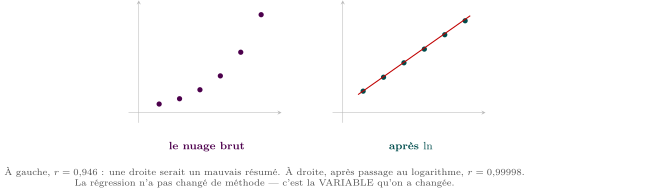
Si le nuage suit visiblement une courbe exponentielle, on n'ajuste pas une droite sur : on ajuste une droite sur . Une relation devient , qui est affine. On revient ensuite à par l'exponentielle.
Python : Tout le chapitre, en dix lignes
import numpy as np

x = np.array([0.5, 1.0, 1.5, 2.0, 2.5, 3.0, 3.5, 4.0])
y = np.array([0.9, 0.6, 0.5, 0.2, 0.0, -0.2, -0.5, -0.7])

xb, yb = x.mean(), y.mean()
sxy = ((x - xb)*(y - yb)).mean()
a = sxy / ((x - xb)**2).mean()
b = yb - a*xb
r = sxy / (x.std() * y.std())

print(round(xb,4), round(yb,4), round(sxy,5))   # 2.25 0.1 -0.59375
# -0.452381 1.117857 -0.997406
print(round(a,6), round(b,6), round(r,6))
x.std() calcule bien au sens de ce chapitre, avec le diviseur . Attention : d'autres bibliothèques divisent par et donneraient un autre nombre.