Travaux pratiques avec Python
Cours complet · mathématiques approfondies (ECG 2e année), chapitre 13 · prépa ECG, 2e année
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Les douze chapitres précédents ont construit des objets et démontré des théorèmes. Ce dernier chapitre les met en machine. Non pour vérifier ce qui est déjà démontré — une simulation ne démontre rien — mais pour voir ce que les énoncés disent, et pour traiter les cas où le calcul exact n'aboutit pas.
Le programme découpe ces travaux en quatre thèmes, que ce chapitre suit dans l'ordre : statistiques descriptives bivariées, fonctions de plusieurs variables, simulation de lois, estimation.
Le programme est explicite : « L'objectif de ces travaux pratiques n'est pas l'écriture de longs programmes mais l'assimilation de savoir-faire ». On n'attend donc de vous ni une bibliothèque, ni une interface : quinze lignes qui répondent à une question précise, et une phrase qui interprète le résultat.
Autre point de règlement, souvent mal connu : « On rappellera dans les sujets toutes les syntaxes des commandes non exigibles. » Les seules commandes à savoir par cœur sont celles de première année. Tout le reste — et ce chapitre en emploie — vous sera donné le jour de l'épreuve.
13.1 Thème 1 : statistiques descriptives bivariées
13.1.1 Le nuage et son point moyen
Une série statistique double est une liste de couples relevée sur individus. Le nuage de points est l'ensemble de ces couples dans le plan.
Le point moyen du nuage est , où et .
La covariance empirique de la série est
et le coefficient de corrélation empirique est , où et sont les écarts types des deux séries simples.
La covariance empirique est la covariance du couple pour la loi uniforme sur les observations. La formule de Huygens et l'encadrement ne sont donc pas des résultats nouveaux : ce sont ceux du cours, lus sur cette loi-là. En particulier si et seulement si les points sont exactement alignés, ce qui est le cas d'égalité de Cauchy-Schwarz du chapitre 4.
Prenons huit entreprises d'un même secteur, dont on relève le budget publicitaire et le chiffre d'affaires , tous deux en milliers d'euros.
| (budget) | 12 | 18 | 24 | 30 | 36 | 42 | 48 | 54 |
|---|---|---|---|---|---|---|---|---|
| (chiffre) | 46 | 52 | 61 | 64 | 73 | 77 | 86 | 89 |
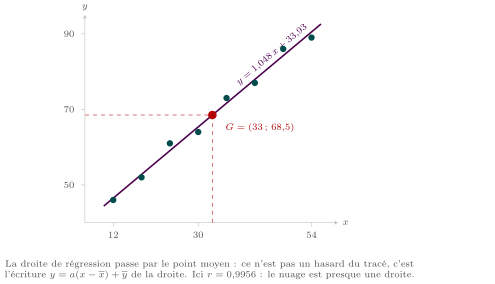
Python : Le nuage, la covariance, la droite
import numpy as np
import matplotlib.pyplot as plt

x = np.array([12, 18, 24, 30, 36, 42, 48, 54])
y = np.array([46, 52, 61, 64, 73, 77, 86, 89])

xb, yb = x.mean(), y.mean()
cov = ((x - xb)*(y - yb)).mean()
r = cov/(x.std()*y.std())
a = cov/x.var()
b = yb - a*xb
print(round(cov, 3), round(r, 4), round(a, 4), round(b, 4))
# 198.0  0.9956  1.0476  33.9286

plt.scatter(x, y)
plt.plot(x, a*x + b)
plt.plot(xb, yb, "o")        # le point moyen
plt.show()
Trois lignes de calcul, une ligne de tracé. Le .std() et le .var() de numpy divisent par , ce qui est bien la convention de la définition ci-dessus.
13.1.2 Il y a deux droites de régression
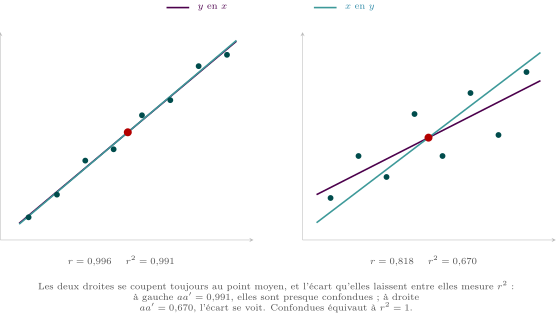
La droite de régression de en est avec et ; celle de en est avec et .
Ces deux droites passent par le point moyen , et
Démonstration
Les deux droites passent par : c'est immédiat sur , et sur . Le produit est celui des deux quotients, soit .
Les deux droites ne coïncident que si . Ajuster en , c'est minimiser les écarts verticaux : on suppose que est connu et que est à expliquer. Ajuster en minimise les écarts horizontaux et inverse les rôles.
Si l'on veut prédire le chiffre d'affaires à partir du budget, c'est la première qu'il faut. Prendre l'autre parce qu'elle est déjà tracée est une faute de modèle, pas une approximation.
13.1.3 Redresser avant d'ajuster
Une droite ne résume bien qu'un nuage droit. Quand la croissance est multiplicative, on pré-transforme les données pour se ramener au cas linéaire. Voici le nombre d'abonnés d'un service, en milliers, sur huit trimestres.
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | |
|---|---|---|---|---|---|---|---|---|
| 12 | 19 | 31 | 47 | 78 | 121 | 195 | 310 |
Si , alors : la série est exactement alignée. Ajuster une droite sur les logarithmes revient donc à ajuster une exponentielle sur les données.
Le coefficient calculé après transformation ne mesure plus la même chose : il juge la qualité du modèle exponentiel, pas celle d'un lien linéaire. Ici il passe de à — et c'est le second chiffre qui dit que le modèle est le bon.
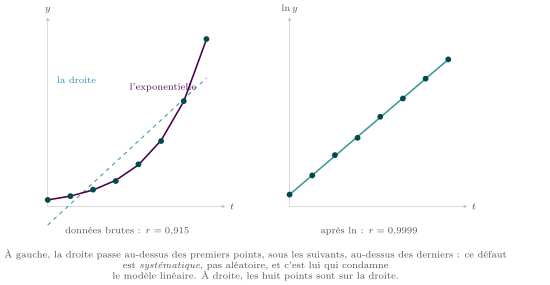
Python : Redresser un nuage par le logarithme
import numpy as np

t = np.array([0, 1, 2, 3, 4, 5, 6, 7])
y = np.array([12, 19, 31, 47, 78, 121, 195, 310])
L = np.log(y)

beta = ((t - t.mean())*(L - L.mean())).mean()/t.var()
alpha = np.exp(L.mean() - beta*t.mean())
print(round(alpha, 3), round(beta, 4))       # 11.996  0.4642
print(round(np.log(2)/beta, 3))  # 1.493 : doublement en 1,5 trimestre
print(round(alpha*np.exp(8*beta)))   # 492 : prevision au 9e trimestre
Le modèle s'écrit . Le temps de doublement se lit directement : trimestre.
dit que les deux séries varient ensemble. Il ne dit pas que la publicité fait le chiffre d'affaires : les entreprises qui vendent le plus sont aussi celles qui peuvent dépenser le plus. Un troisième facteur — la taille de l'entreprise — explique peut-être les deux.
Le programme demande explicitement un regard critique sur ces méthodes. C'est ici qu'il s'exerce : la statistique descriptive décrit, elle n'explique pas.
13.2 Thème 2 : fonctions de plusieurs variables
13.2.1 Graphe, lignes de niveau, gradient
Python : Les trois représentations d'une même fonction
import numpy as np
import matplotlib.pyplot as plt

f = lambda x, y: x**2 + 2*y**2
X, Y = np.meshgrid(np.linspace(-3, 3, 200), np.linspace(-3, 3, 200))
Z = f(X, Y)

fig = plt.figure()
ax = fig.add_subplot(1, 2, 1, projection="3d")
ax.plot_surface(X, Y, Z)                    # le graphe
ax2 = fig.add_subplot(1, 2, 2)
ax2.contour(X, Y, Z, levels=[2, 6, 12])     # les lignes de niveau
ax2.quiver(2, 1, 4, 4)                      # le gradient en (2, 1)
ax2.set_aspect("equal")
plt.show()
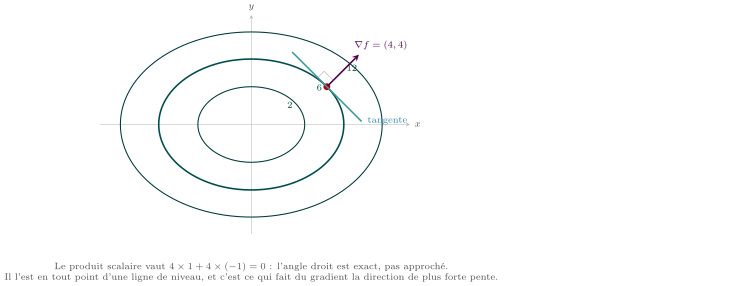
meshgrid fabrique la grille des couples ; contour trace les lignes de niveau demandées ; quiver pose une flèche. Ces trois syntaxes ne sont pas exigibles et vous seraient rappelées.
Soit de classe sur un ouvert de et un point où . Si est un arc de classe tracé sur la ligne de niveau de passant par , avec , alors
Démonstration
La fonction est constante sur la ligne de niveau. Sa dérivée en est donc nulle ; or la règle de dérivation composée du chapitre 5 donne .
13.2.2 Le graphe et son plan tangent
Le développement limité d'ordre du chapitre 10 dit que, près d'un point critique ,
donc que la position du graphe par rapport à son plan tangent est gouvernée par le signe de la forme quadratique hessienne — c'est-à-dire par les signes des valeurs propres de la matrice hessienne, qui est symétrique réelle et donc diagonalisable en base orthonormée (chapitre 9).
Python : Classer un point critique par les valeurs propres
import numpy as np

def hessienne(x, y):
    # pour f = x^3 - 3xy + y^3
    return np.array([[6*x, -3.0], [-3.0, 6*y]])

for (x, y) in [(0, 0), (1, 1)]:
    vp = np.linalg.eigvalsh(hessienne(x, y))      # matrice symetrique
    print((x, y), vp.round(4), "selle" if vp[0]*vp[-1] < 0
          else ("minimum" if vp[0] > 0 else "maximum"))
# (0, 0) [-3.  3.] selle
# (1, 1) [ 3.  9.] minimum
eigvalsh est réservé aux matrices symétriques et rend les valeurs propres triées. Le test de signe suffit alors : deux signes opposés donnent un point selle, deux valeurs propres strictement positives un minimum local.
On classe un point critique par les signes des valeurs propres de la hessienne. Aucune autre quantité associée à la matrice n'intervient, et il n'est pas question d'en calculer une pour obtenir ces signes : ici on les lit, sur machine, avec eigvalsh ; à la main, on cherche un polynôme annulateur comme au chapitre 2.
Le point mérite qu'on regarde ce qui s'y passe. La fonction y vaut et son gradient y est nul : le plan tangent est le plan . Deux coupes suffisent alors à conclure.
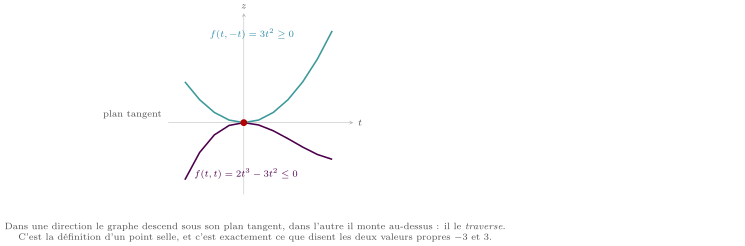
13.2.3 Extrema sous contrainte linéaire
Sous une contrainte affine, on exprime une variable en fonction des autres et l'on reporte : le problème contraint à variables devient un problème libre à variables, que l'on traite avec les outils du chapitre 10. C'est la seule méthode au programme, et elle suffit.
Cherchons le minimum de sous la contrainte . En posant , on étudie , dont la dérivée s'annule en . Comme , c'est un minimum, et il vaut , atteint en .
Python : Vérifier le minimum contraint par balayage
import numpy as np

f = lambda x, y: x**2 + 2*y**2
xs = np.linspace(-2, 6, 100001)
vals = f(xs, 3 - xs)                 # la contrainte est deja injectee
i = vals.argmin()
print(round(xs[i], 5), round(3 - xs[i], 5), round(vals[i], 6))
# 2.0  1.0  6.0
Le balayage corrobore le calcul, il ne le remplace pas : il ne visite qu'une grille, et rien ne garantit qu'il n'existe pas ailleurs un point plus bas. Ici c'est le calcul de dérivée, lui, qui le garantit.
13.3 Thème 3 : simulation de lois
13.3.1 La méthode d'inversion
Soit la fonction de répartition d'une variable à densité, continue et strictement croissante sur un intervalle où elle prend ses valeurs dans . Si suit la loi uniforme sur , alors admet pour fonction de répartition.
Démonstration
Pour , l'événement est égal à par croissance stricte de et de sa réciproque. Or , donc . La fonction de répartition de est donc .
Pour la loi exponentielle de paramètre , sur , d'où .
Python : Simuler une loi exponentielle sans numpy
import random, math

random.seed(4)
lam, N = 1.5, 200000
ech = [-math.log(1 - random.random())/lam for _ in range(N)]
print(round(sum(ech)/N, 4))                          # 0.6671    1/lam
# 0.7763    1 - e^{-1.5}
print(round(sum(1 for v in ech if v <= 1)/N, 4))
La moyenne empirique approche et la fréquence de approche . Deux contrôles valent mieux qu'un : le premier vérifie l'échelle, le second la forme.
13.3.2 Une loi sans espérance : Cauchy
La loi de Cauchy a pour densité sur , donc pour fonction de répartition et pour réciproque .
L'intégrale vaut , qui diverge. La condition d'existence de l'espérance n'est pas remplie ; il n'y a donc aucun nombre vers lequel la moyenne empirique aurait à converger. La loi faible des grands nombres ne s'applique pas : son hypothèse manque.
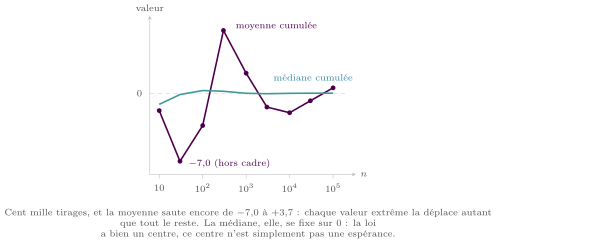
Elle ne démontre pas que l'espérance n'existe pas — une simulation ne démontre rien. C'est le calcul de l'intégrale divergente qui le démontre.
Ce qu'elle montre, en revanche, est précieux : le symptôme de cette absence, qu'on saura reconnaître ailleurs. Une moyenne empirique qui refuse de se stabiliser quand est déjà grand doit faire soupçonner une loi à queue lourde, et non un manque de tirages.
13.3.3 Trois façons de simuler une loi géométrique
Python : Bernoulli et while, exponentielle et floor, numpy
import numpy as np
import random, math

p, N = 0.3, 200000
rng = np.random.default_rng(5)

def par_bernoulli(p):               # methode 1 : on compte les essais
    k = 1
    while random.random() >= p:
        k += 1
    return k

ech1 = [par_bernoulli(p) for _ in range(N)]
# methode 2
ech2 = np.floor(rng.exponential(1/(-math.log(1 - p)), N)) + 1
ech3 = rng.geometric(p, N)                                 # methode 3

for e in (ech1, ech2, ech3):
    e = np.array(e)
    print(round(float(e.mean()), 3), round(float(np.mean(e == 1)), 3))
#  3.333 et  0.300 pour les trois : moyenne 1/p, et P(X = 1) = p
La méthode 2 s'explique : si suit avec , alors , qui est exactement pour géométrique. C'est la même loi.
La première ne demande qu'une loi de Bernoulli, mais sa durée est aléatoire : en moyenne tours de boucle, et beaucoup plus quand est petit. La deuxième et la troisième rendent un tirage en temps constant. Comparer des méthodes de simulation — pas seulement les écrire — fait partie des compétences attendues.
13.3.4 Une loi normale par le théorème limite central
Si sont indépendantes de loi uniforme sur , chacune a pour espérance et pour variance . La somme vérifie donc et : la variable est centrée réduite, et le théorème limite central du chapitre 11 suggère qu'elle est presque normale.
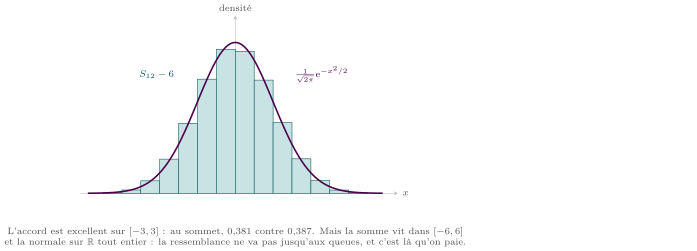
exactement, alors qu'une vraie normale centrée réduite dépasse avec probabilité . Sur tirages, le plus extrême observé vaut .
Ce n'est négligeable que si l'on s'intéresse au centre. Pour un calcul de risque, qui vit précisément dans la queue, la méthode est fausse — et numpy.random.standard_normal, qui n'a pas cette borne, est alors le bon outil. Choisir sa méthode de simulation en fonction de la question posée est, là encore, une compétence du programme.
13.4 Thème 4 : Monte-Carlo, estimation, intervalles
13.4.1 Le principe et sa garantie
Estimer une quantité en simulant un -échantillon de la loi de et en retenant
c'est appliquer la méthode de Monte-Carlo. Le cas où est la fonction indicatrice d'un événement donne l'estimation d'une probabilité par une fréquence.
Si admet une variance , alors est un estimateur sans biais de , il est convergent (loi faible des grands nombres), et le théorème limite central donne, pour grand,
Le du dénominateur est la loi d'airain de la méthode : pour diviser l'erreur par , il faut multiplier le nombre de tirages par . Aucune astuce de programmation n'y change rien — seule une réduction de le peut.
C'est aussi ce qui rend la méthode utilisable en grande dimension, là où les méthodes de quadrature s'effondrent : le ne dépend pas du nombre de variables.
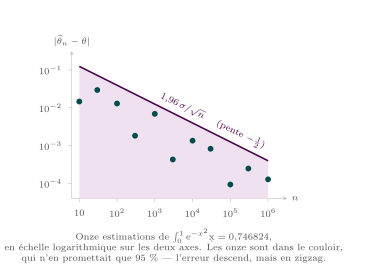
Python : Une intégrale, et la taille d'échantillon qu'elle exige
import numpy as np

rng = np.random.default_rng(11)
ech = np.exp(-rng.random(1000000)**2)
m, s = ech.mean(), ech.std(ddof=1)
print(round(m, 6), round(1.96*s/np.sqrt(len(ech)), 6))
# 0.746516  0.000394        (valeur exacte : 0.746824)

sigma = 0.20098
print(int(np.ceil((1.96*sigma/0.005)**2)))     # 6207
La dernière ligne répond à la question utile : pour que la demi-largeur tombe sous — deux décimales sûres — il faut environ tirages. On dimensionne l'échantillon avant de lancer le calcul, à partir de .
Python : Une probabilité qu'on saurait calculer, et une qu'on ne saurait pas
import numpy as np

rng = np.random.default_rng(13)
X = rng.exponential(1, 1000000)
Y = rng.exponential(1, 1000000)
print(round(float(np.mean(X + Y <= 1)), 6))    # 0.264411
print(round(1 - 2/np.e, 6))                 # 0.264241  (calcul exact)

# pas de forme simple a comparer
print(round(float(np.mean(X*Y <= 1)), 6))
La première ligne se vérifie : suit une loi de paramètre (chapitre 8), dont on sait intégrer la densité. La seconde ne se vérifie pas, et c'est justement pour ces cas-là que la méthode existe. Toujours l'essayer d'abord sur un cas où l'on connaît la réponse : c'est ainsi qu'on teste le code.
13.4.2 Comparer deux estimateurs
Soit de loi uniforme sur , inconnu. Deux estimateurs se présentent : , et où .
Comme , on a et .
Pour , l'indépendance donne sur , donc une densité , puis et . On en tire et .
Le rapport des variances vaut : pour , l'estimateur par le maximum est quatre fois moins dispersé.
Python : Comparer par histogrammes
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(17)
theta, n, N = 3.0, 10, 100000
ech = rng.random((N, n))*theta
T1 = 2*ech.mean(axis=1)
T2 = (n + 1)/n*ech.max(axis=1)

for T, th in ((T1, theta**2/(3*n)), (T2, theta**2/(n*(n + 2)))):
    print(round(T.mean(), 4), round(T.var(), 5), round(th, 5))
# 2.9961  0.29974  0.3      -> T1
# 2.9994  0.07548  0.075    -> T2

plt.hist(T1, bins=60, alpha=0.5)
plt.hist(T2, bins=60, alpha=0.5)
plt.show()
Les deux histogrammes sont centrés au même endroit — les deux estimateurs sont sans biais — mais le second est nettement plus étroit. C'est la variance, et elle seule, qui les départage : le programme exclut explicitement toute comparaison par une quantité qui mélangerait biais et variance.
13.4.3 Comparer des intervalles de confiance
Soit un -échantillon de loi avec connu. La moyenne suit , ce qui donne un intervalle de confiance exact au niveau :
L'inégalité de Bienaymé-Tchebychev en donne un autre, valable sans hypothèse de loi : .
Pour et , les demi-largeurs valent et .
Python : Demi-largeur moyenne et taux de couverture
import numpy as np

rng = np.random.default_rng(23)
m, sigma, n, N = 20.0, 4.0, 25, 200000
Xb = m + sigma/np.sqrt(n)*rng.standard_normal(N)

d_exact = 1.96*sigma/np.sqrt(n)
d_tcheb = sigma/np.sqrt(0.05*n)
for d in (d_exact, d_tcheb):
    print(round(d, 4), round(float(np.mean(np.abs(Xb - m) <= d)), 4))
# 1.568   0.9495    -> exact : tient sa promesse au plus juste
# 3.5777  1.0000  -> Tchebychev : couvre toujours, 2x plus large
Les deux intervalles sont honnêtes — aucun ne couvre moins de — mais le second est fois plus large. Tenir sa promesse exactement vaut mieux que la dépasser : un intervalle trop large ne dit plus rien.
Pour une loi de Bernoulli, l'intervalle n'est justifié qu'à la limite. En simulant, on mesure sa couverture réelle :
Le rang à partir duquel l'approximation vaut dépend de : suffit pour , il en faut environ pour . Un intervalle qui annonce et n'en couvre que n'est pas approximatif, il est faux — et seule la simulation le révèle.