Variables aléatoires discrètes infinies
Cours complet · mathématiques (ECT 2e année), chapitre 5 · prépa ECT, 2e année
Travailler ce chapitre sur Adloun Exercices corrigés de ce chapitre
Toutes les variables aléatoires rencontrées jusqu'ici prenaient un nombre fini de valeurs. Or beaucoup de questions simples n'entrent pas dans ce cadre : « combien de pièces devrai-je tester avant d'en trouver une défectueuse ? » — la réponse peut être , , , , et aucun majorant ne s'impose. « Combien d'appels le standard recevra-t-il dans la prochaine minute ? » — , , , sans plafond.
Ce chapitre étend les définitions de première année à ces variables, puis étudie les deux lois que le programme retient : la loi géométrique et la loi de Poisson.
Le programme borne strictement l'ambition théorique du chapitre : « On se limitera aux variables aléatoires positives dont l'image est indexée par . Aucune difficulté théorique ne sera soulevée au moment de l'extension des propriétés. »
Autrement dit : les définitions de la loi, de la fonction de répartition, de l'espérance et de la variance sont les mêmes qu'en première année, avec une somme infinie à la place d'une somme finie. Rien d'autre ne change, et l'on ne discutera pas de convergence.
5.1 Quand l'univers n'est plus fini
Une variable aléatoire est discrète infinie lorsque l'ensemble de ses valeurs est infini et peut être indexé par les entiers : , ou , ou plus généralement .
Sa loi de probabilité est la donnée des nombres pour tout .
La règle de première année ne change pas, mais la somme devient une série :
Cette série est convergente, et sa somme vaut . C'est la première chose à vérifier quand on vous propose une famille de nombres comme loi de probabilité — et c'est presque toujours une série géométrique qui s'en charge.
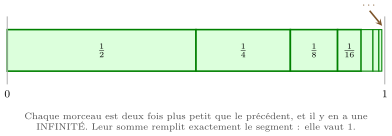
Posons pour tout entier . Ces nombres sont positifs, et la série géométrique de raison donne
C'est donc bien une loi de probabilité, alors qu'elle attribue une probabilité non nulle à une infinité de valeurs.
On ne posera aucune question sur la nature de , ni sur la façon dont on construit une probabilité sur un univers infini. Le programme est net : « Aucune difficulté théorique ne sera soulevée. » On admet que tout fonctionne comme dans le cas fini.
5.2 Fonction de répartition
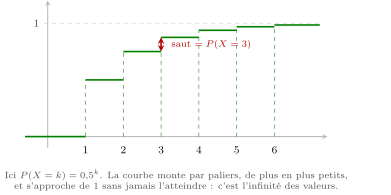
La fonction de répartition de est la fonction définie sur par .
est croissante sur , à valeurs dans , et
Lorsque , est constante entre deux entiers consécutifs et fait un saut de hauteur en chaque entier .
Pour une variable à valeurs entières, on passe sans cesse d'une forme à l'autre :
Sur les lois infinies, se calcule souvent beaucoup plus vite que la somme des premiers termes : c'est le réflexe du chapitre.
5.3 Espérance et variance
Lorsque les séries écrites ci-dessous convergent, on pose
Les formules sont mot pour mot celles de première année ; seule la somme finie est devenue une série. Toutes les propriétés connues restent vraies : , , la formule de Kœnig-Huygens, et la linéarité de l'espérance d'une somme.
Le calcul de pour la loi géométrique passe par la dérivée d'une série géométrique — et le programme écarte explicitement cet outil : « Les dérivées des séries géométriques ne font pas partie des attendus du programme. »
En face de l'espérance et de la variance des deux lois usuelles, le programme porte donc la mention « Résultats admis ». On les apprend, on les applique, on ne les démontre pas.
5.4 La loi géométrique
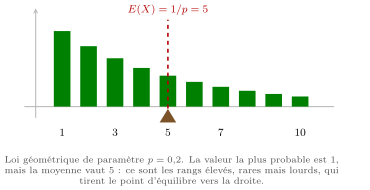
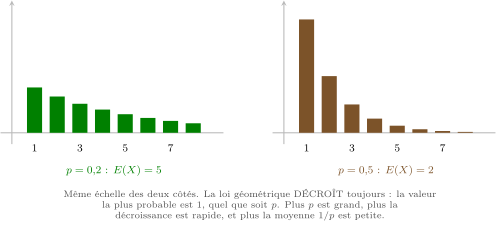
On répète, de façon indépendante, une même épreuve dont la probabilité de succès vaut . La variable égale au rang du premier succès suit la loi géométrique de paramètre , notée . On a et
Démonstration
L'événement signifie : les premières épreuves sont des échecs, et la -ième est un succès. Les épreuves étant indépendantes, sa probabilité est le produit , avec facteurs .
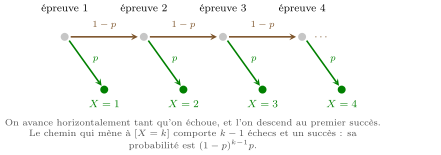
Les nombres sont positifs, et leur somme vaut :
On est passé de à : c'est exactement le décalage d'indice du chapitre sur les sommes, et il fait apparaître la série géométrique sous sa forme standard , valable car .
Si , alors
Le programme insiste : « La reconnaissance de la loi géométrique comme loi du premier succès est exigible. » Devant un énoncé, on cherche donc trois choses : une même épreuve répétée, des répétitions indépendantes, et une variable qui compte le rang du premier succès. Les trois réunies, la loi est identifiée, et se lit sans calcul.
Une chaîne produit de pièces défectueuses. Un contrôleur teste les pièces une à une, indépendamment, et note le rang de la première pièce défectueuse : on reconnaît la loi du premier succès, donc .
Ainsi : il faut tester pièces en moyenne. Et , donc : la dispersion est énorme, presque égale à la moyenne. Le nombre de tests est très imprévisible.
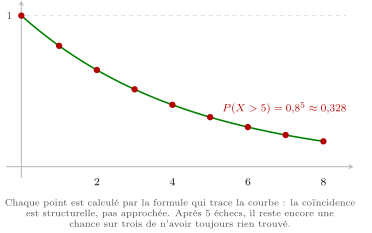
Si , alors pour tout entier :
Démonstration
Dire que , c'est dire que les premières épreuves sont toutes des échecs : la probabilité vaut par indépendance. On peut aussi sommer la série .
Python : Une série qu'on regarde converger
p = 0.2
somme = 0.0
esperance = 0.0
for k in range(1, 201):
    q = (1 - p)**(k - 1) * p
    somme = somme + q
    esperance = esperance + k * q
print(round(somme, 10), round(esperance, 6))
Sortie : 1.0 5.0. Deux cents termes suffisent à retrouver la somme et l'espérance à dix décimales — parce que les termes décroissent géométriquement. La machine corrobore les deux résultats admis ; elle ne les démontre pas, puisqu'elle s'arrête au rang .
Python : Simuler le premier succès
import random

def premier_succes(p):
    k = 1
    while random.random() >= p:
        k = k + 1
    return k

random.seed(0)
n = 200000
tirages = [premier_succes(0.2) for _ in range(n)]
moyenne = sum(tirages) / n
print(round(moyenne, 4), max(tirages))
Sortie : 4.9861 67. La moyenne empirique approche la valeur exacte , et le maximum observé rappelle qu'aucune borne ne limite : sur deux cent mille essais, il a fallu une fois tirages. C'est très exactement ce que signifie « discrète infinie ».
5.5 La loi de Poisson
Soit . On dit que suit la loi de Poisson de paramètre , notée , lorsque et
Si , alors et , donc .
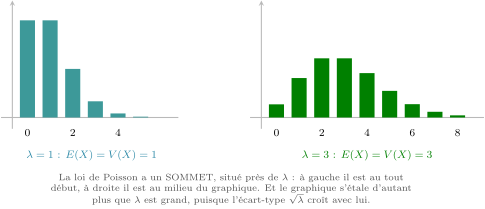
L'espérance et la variance valent toutes les deux : c'est la particularité de cette loi, et un moyen commode de la reconnaître. Le paramètre se lit donc directement comme le nombre moyen d'occurrences sur la période considérée.
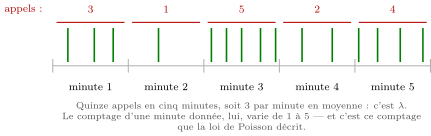
Conséquence pratique : si l'on change de période, on change de proportionnellement. Trois appels par minute en moyenne, c'est sur une minute, mais sur cinq minutes.
Un standard reçoit en moyenne appels par minute, et l'on modélise par le nombre d'appels d'une minute donnée. Alors
Une minute sur vingt environ ne reçoit aucun appel. De même
donc : plus d'une minute sur deux est « chargée », au sens où elle reçoit au moins trois appels.
On ne les confond pas si l'on retient la question à laquelle chacune répond.
- Géométrique : « au bout de combien d'essais ? » Un rang, donc ; la valeur n'a aucun sens.
- Poisson : « combien d'occurrences pendant cette période ? » Un comptage, donc ; la valeur est possible et fréquente.
Python : La loi de Poisson au clavier
from math import exp, factorial

lam = 3.0
p = [exp(-lam) * lam**k / factorial(k) for k in range(9)]
print([round(v, 4) for v in p[:4]])
print(round(sum(p[:6]), 6), round(1 - sum(p[:6]), 6))
Sortie : [0.0498, 0.1494, 0.224, 0.224], puis 0.916082 0.083918. On lit les deux valeurs égales — un accident propre à , puisque — et le fait que huit minutes sur cent reçoivent six appels ou plus.